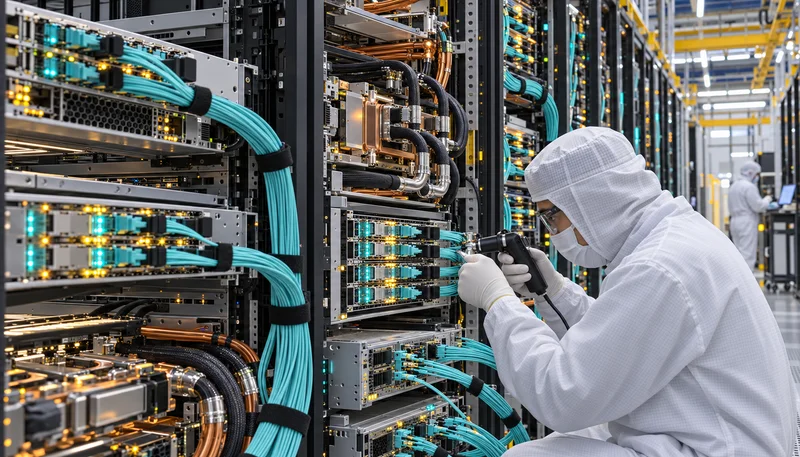
Limites Physiques du Cuivre Haute Vitesse et Dégradation de l'Intégrité du Signal sous PCIe 6.0/7.0
Le passage aux spécifications PCIe 6.0 à 64 GT/s et PCIe 7.0 à 128 GT/s marque une rupture fondamentale dans la physique de transmission sur cuivre au sein des topologies de calcul accéléré. L'adoption de la modulation d'amplitude d'impulsion à quatre niveaux (PAM4) divise par deux l'espacement entre les niveaux de tension par rapport au schéma NRZ historique, réduisant dramatiquement le rapport signal sur bruit (SNR) intrinsèque d'environ 9,54 dB. À ces débits, les fréquences de Nyquist atteignent respectivement 16 GHz et 32 GHz. Aux fréquences gigahertziennes, les pertes diélectriques au sein des stratifiés PCB conventionnels (même de grade Megtron-7 ou 8 avec de faibles tangentes de perte tan δ) combinées à l'effet de peau extrême provoquent une atténuation exponentielle du signal. Le budget de perte d'insertion total alloué par le standard PCI-SIG, plafonné entre 32 dB et 36 dB à la fréquence de Nyquist, est entièrement consommé par seulement quelques dizaines de centimètres de pistes internes, de connecteurs de bord de carte et de via stubs non compensés.
En conséquence opérationnelle directe, la portée utile des câbles passifs en cuivre à attache directe (DAC) s'effondre pour s'établir en deçà de 0,7 à 1,0 mètre à 64 GT/s, rendant impossible l'interconnexion passive entre tiroirs serveurs distants dans un même rack de 42U ou 48U. Bien que l'industrie ait temporairement remédié à cette contrainte via des câbles électriques actifs (AEC) intégrant des circuits de resynchronisation (retimers) au silicium avancés, ce palliatif engendre des pénalités énergétiques sévères. Chaque composant retimer réclame entre 2 et 3 watts par voie bidirectionnelle, générant une surcharge thermique pouvant atteindre plus de 200 watts pour un simple lien PCIe x16 complet. Cette dissipation localisée aggrave la saturation thermique des châssis denses de calcul IA. De surcroît, le recours intensif à l'égalisation temporelle (CTLE, DFE) et aux algorithmes de correction d'erreurs sans voie de retour (FEC) imposés par le mode Flit (Flow Control Unit) atteint un plafond de complexité algorithmique au-delà duquel l'overhead de calcul et la latence induite deviennent contre-productifs.
Budget d'atténuation Nyquist : Tolérance d'insertion maximale fixée impérativement à 32 dB à 16 GHz (PCIe 6.0) et 36 dB à 32 GHz (PCIe 7.0)
Seuil de portée cuivre : Proscription stricte du cuivre passif (DAC) pour les liaisons inter-tiroirs excédant 0,80 mètre de chemin de câble
Plafond d'égalisation : Limiter l'usage des retimers AEC à un budget énergétique maximal de 2,5 W par voie sous peine d'emballement thermique localisé
Architecture PCIe Optique et Dynamique des Émetteurs-Récepteurs VCSEL Multicanaux
L'émancipation photonique des interconnexions PCIe repose sur la translation transparente des flux électriques PAM4 vers le domaine optique sans altération de la sémantique de couche liaison. Contrairement aux réseaux de commutation Ethernet ou InfiniBand qui encapsulent les données dans des trames routées complexes sujettes à des piles logicielles consommatrices de temps de cycle, le PCIe optique préserve intégralement les primitives natives de transfert mémoire direct (load/store), la cohérence de cache CXL (Compute Express Link), ainsi que le contrôle de flux basé sur les crédits transactionnels. Les moteurs optiques récents intègrent des réseaux de lasers à émission de surface par cavité verticale (VCSEL) multicanaux opérant aux longueurs d'onde de 850 nm et 910 nm (multiplexage court SWDM). Ces transmetteurs sont directement couplés à des rubans de fibres optiques multimodes insensibles aux courbures de type OM4 et OM5, assurant une intégrité électro-optique optimale à très haute cadence.
La dynamique temporelle constitue le vecteur critique de cette architecture d'interconnexion : la conversion électro-optique et opto-électronique (E-O-E) doit s'exécuter sous des contraintes de délai déterministes et ultra-faibles. Les architectures optiques modernes de classe OCP 2026 atteignent une latence de conversion unidirectionnelle inférieure à 5 nanosecondes, rendant la transition photonique virtuellement invisible pour les couches protocolaires sous-jacentes et évitant le déclenchement intempestif des compteurs d'expiration (replay timers) du protocole PCIe. Cette efficacité est rendue possible par l'absence totale de décapsulation de paquets : les photons propagent directement les symboles PAM4 bruts. Les liaisons commutées par des fabrics intelligents (tels que la gamme Astera Labs Scorpio) permettent ainsi de franchir la barrière physique des racks, étendant la portée déterministe d'un lien PCIe direct de moins de 2 mètres à des distances comprises entre 10 et plus de 100 mètres à l'échelle du hall de calcul.
Pénalité de latence E-O-E : Exiger une latence de conversion électro-optique bidirectionnelle globale strictement inférieure à 5 ns
Spécification laser : Déploiement de matrices VCSEL 850/910 nm qualifiées pour un débit de modulation minimal de 32 Gbaud PAM4 par voie
Support physique : Standardisation des faisceaux sur fibre multimode insensible aux courbures (BI-MMF) de grade OM4 ou OM5 exclusivement
Désagrégation des Calculateurs à l'Échelle du Rack et Topologie de Cluster Scale-Up
L'avènement du PCIe optique démantèle définitivement la contrainte de proximité géométrique qui dictait jusqu'alors la conception des serveurs d'accélération pour l'entraînement des modèles d'intelligence artificielle de pointe. Traditionnellement, les processeurs graphiques (GPU), les accélérateurs spécialisés (XPU), la mémoire haute bande passante et les commutateurs dédiés devaient être confinés au sein d'un châssis métallique unique de quelques unités de rack pour respecter les tolérances kilométriques infinitésimales des traces de cuivre. Cette concentration créait des goulets d'étranglement insolubles en matière de densité de puissance surfacique et de points chauds thermiques. Grâce au déport optique sans perte de performance, les clusters scale-up peuvent désormais distribuer les ressources de calcul, les banques de mémoire CXL partagée et les tiroirs de stockage NVMe haute performance à travers de multiples baies interconnectées en une grille logique unifiée.
Cette désagrégation multilatérale optimise radicalement l'indice d'efficacité énergétique et la granularité d'allocation des infrastructures d'hyper-calcul. Au lieu de surdimensionner les tiroirs serveurs individuels pour répondre aux pointes d'activité, les ingénieurs système conçoivent des ensembles modulaires où les nœuds d'accélération GPU communiquent directement avec des pools distants de mémoire CXL 3.1 via une matrice optique reconfigurable à faible latence. Les topologies d'interconnexion commutées permettent de mutualiser dynamiquement des pétaoctets de mémoire centrale unifiée sans subir la pénalité logicielle des accès RDMA conventionnels. En éliminant l'entrelacement chaotique de faisceaux massifs de câblage cuivre inter-racks, l'espace physique interne des baies est restitué aux infrastructures modulaires de refroidissement liquide et de distribution électrique, facilitant une maintenance sélective sans interruption de service.
Architecture de matrice : Mise en œuvre d'un domaine d'adressage unifié PCIe/CXL étendu sur une topologie multi-baies jusqu'à 32 nœuds
Désagrégation mémoire : Allocation de pools CXL 3.1 déportés via fabric optique maintenant un temps de cycle d'accès mémoire < 80 ns
Densité d'interconnexion : Remplacement des torons de câbles cuivre par des jarretières multifibres permettant un gain d'espace volumétrique de 85 %
Dissipation Thermique, Impédance Aéraulique et Efficacité Énergétique des Interconnexions
L'engorgement physique de la face arrière des racks de calcul haute densité par les faisceaux de câblage cuivre traditionnels représente l'une des sources majeures d'inefficacité aéraulique dans les centres de données contemporains. Les câbles DAC ou AEC de forte section (AWG 24 à AWG 30) créent un mur d'obstruction continu sur les zones d'échappement d'air chaud, induisant une impédance aéraulique sévère. Cette résistance à l'écoulement contraint les ventilateurs modulaires de châssis à fonctionner à des régimes de rotation extrêmes, augmentant la charge électrique parasitaire de refroidissement qui peut représenter jusqu'à 15 à 20 % de la consommation totale du sous-système serveur. La substitution de ces éléments rigides par des rubans de fibre optique de diamètre micrométrique supprime quasi intégralement cette restriction d'écoulement, abaissant drastiquement la pression différentielle requise et réduisant les nuisances acoustiques et vibratoires.
Sur le plan thermodynamique des composants, l'intégration optique impose toutefois une ingénierie thermique rigoureuse quant à la localisation des moteurs photoniques. Les circuits lasers VCSEL présentent une courbe de dégradation de fiabilité abrupte lorsque leur température de jonction dépasse les seuils nominaux, généralement situés autour de 85 °C, alors que les processeurs de calcul IA tolèrent des pointes thermiques supérieures à 100 °C. L'architecture physique doit ainsi proscrire la cohabitation thermique directe des composants optiques avec les boîtiers ASIC dissipant plus de 1 000 W. Le déploiement de solutions d'optique intermédiaire (Mid-Board Optics) ou de modules optiques extractibles en face avant (Pluggable Optical Engines) reliés par des guides d'ondes et des connecteurs blind-mate permet d'isoler thermiquement les transmetteurs photoniques dans des corridors de flux d'air tempéré, garantissant leur rendement quantique et leur durée de vie opérationnelle.
Atténuation aéraulique : Réduction de la chute de pression statique d'extraction d'air arrière à une valeur cible ≤ 15 Pa par tiroir 4U
Confinement thermique des lasers : Garantie d'une température de fonctionnement des matrices VCSEL strictement maintenue en deçà de 75 °C
Bilan énergétique net : Suppression des étages d'amplification cuivre intermédiaires pour atteindre un rendement d'interconnexion ≤ 12 pJ/bit
Distribution d'Alimentation DC Subrack et Secours Haute Disponibilité
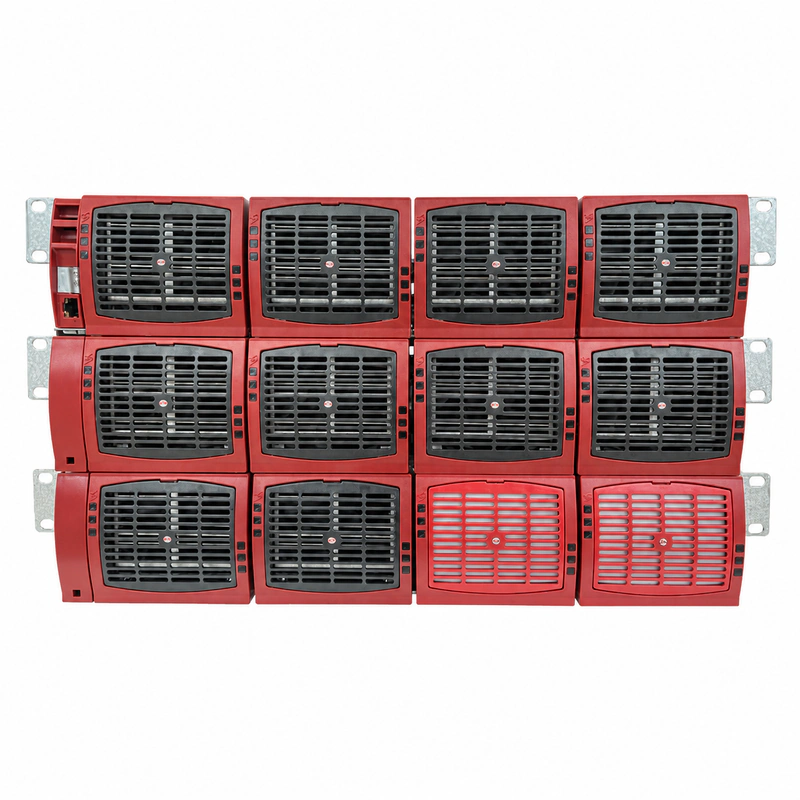
L'infrastructure d'alimentation électrique des commutateurs photoniques PCIe et des tiroirs d'accélération désagrégés exige une refonte vers des architectures à très haut rendement basées sur des rails de distribution continue en -48V DC ou 54V DC, alignées sur les spécifications Open Rack Standard (ORV3). Les commutateurs optiques de nouvelle génération génèrent des gradients d'appel de courant transitoires extrêmement raides lors du basculement simultané de centaines de voies de communication à très haut débit. Pour empêcher toute chute de tension locale (droop) susceptible d'entraîner des instabilités logiques sur les émetteurs-récepteurs ou d'altérer le point de polarisation des diodes laser, chaque sous-rack intègre des redresseurs distribués à haut rendement ainsi que des bancs de découplage capacitifs montés directement au plus près des barres omnibus (busbars).
La disponibilité opérationnelle sans faille de la fabric optique est impérative : la perte d'un seul commutateur PCIe optique central peut entraîner l'effondrement de l'ensemble du domaine de cohérence mémoire et le gel brutal des charges d'entraînement IA distribuées. L'infrastructure requiert par conséquent une architecture d'alimentation redondante à double source (2N) équipée de commutateurs de transfert automatique ultra-rapides (ATS à semi-conducteurs) opérant en moins d'une milliseconde. Ce dispositif élimine toute micro-coupure réseau et prévient tout basculement intempestif des liens vers les états d'économie d'énergie basse puissance de la norme PCIe (états L0s ou L1), prévenant ainsi le partitionnement critique de la grappe de calcul et les cycles de réinitialisation logicielle hautement préjudiciables à la convergence des modèles d'entraînement.
Tension de distribution : Alignement sur le standard busbar -48V / 54V DC avec tolérance de régulation de tension transitoire < 3 %
Temps de transfert de secours : Implantation de commutateurs ATS à semi-conducteurs avec basculement de source garanti en moins de 2 ms
Tolérance aux pannes : Configuration redondante des redresseurs subrack en topologie N+2 avec partage de courant actif (droop share)
Feuille de Route, Fiabilité des Connecteurs Optiques MPO et Maintenance Terrain
Le passage des démonstrateurs de faisabilité présentés au sommet mondial OCP vers un déploiement massif à l'échelle industrielle requiert une standardisation rigoureuse, actuellement pilotée par le groupe de travail optique du consortium PCI-SIG. L'un des principaux défis opérationnels réside dans la vulnérabilité environnementale inhérente aux interfaces optiques multivoies. Contrairement aux broches métalliques du cuivre capables de traverser de minces couches d'oxydation, les connecteurs multifibres haute densité de type MPO/MTP-16 et MPO-32 présentent une sensibilité critique à la contamination particulaire. Une microparticule de poussière de 1 à 2 microns logée sur la face terminale d'une férule optique peut entraîner des pertes d'insertion prohibitives ou générer des réflexions optiques parasites (return loss) dégradant le taux d'erreur binaire (BER) au-delà des capacités de correction de la FEC interne.
Le déploiement des fonds de panier optiques à insertion directe sans raccord manuel (blind-mate optical backplanes) impose le déploiement d'outillages de métrologie et de protocoles de maintenance automatisés. Les équipes d'ingénierie d'infrastructure doivent implémenter des systèmes de télémétrie embarquée interrogeant en temps réel la puissance optique reçue (RSSI) et surveillant la dérive du courant d'attaque des lasers VCSEL pour anticiper la fin de vie d'un composant avant rupture de liaison (MTBF moyen ciblé > 10 millions d'heures par canal). Conjointement, les techniciens d'exploitation doivent appliquer des procédures d'inspection par interférométrie vidéo numérique couplées à des dispositifs de nettoyage mécanique sous flux gazeux ionisé lors de chaque manipulation de tiroir serveur, garantissant la pureté optique des zones de contact physique.
Standard de propreté optique : Conformité stricte à la norme IEC 61300-3-35 avant tout accouplement de connecteurs MPO multifibres
Télémétrie prédictive : Surveillance continue par logiciel du courant de polarisation (bias) VCSEL et alerte en cas de dérive de ±10 %
Fiabilité mécanique : Sélection de connecteurs de fond de panier blind-mate certifiés pour au moins 500 cycles d'insertion sans dégradation
Approvisionnement et support technique
Pour les fiches techniques, les topologies d'alimentation sur mesure ou les devis de gros, contactez les ingénieurs RICEWIND.