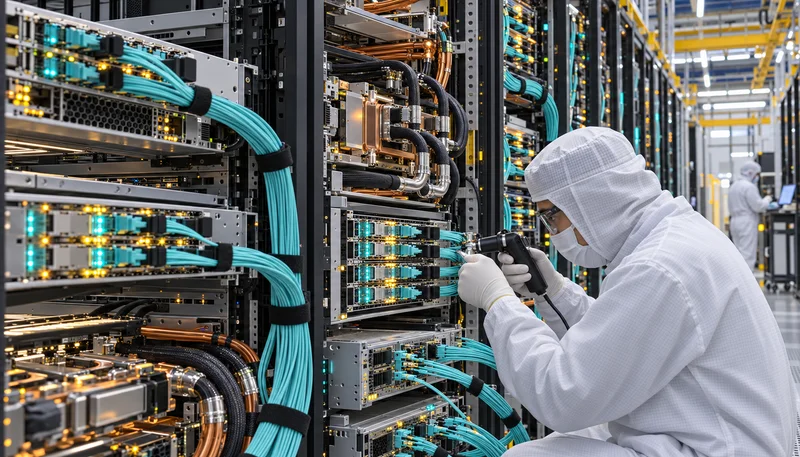
Physikalische Grenzen von Kupferverbindungen und Signaldegradation bei PCIe 6.0 und 7.0
Die Evolution von PCIe 6.0 mit 64 GT/s und PCIe 7.0 mit 128 GT/s basiert auf der 4-Stufen-Pulsamplitudenmodulation (PAM4), welche im Vergleich zur klassischen NRZ-Signalisierung die Datenübertragungsrate pro Taktzyklus verdoppelt. Dieser Schritt geht jedoch mit einer Reduktion des Signal-Rausch-Verhältnisses (SNR) um mindestens 9,54 dB einher, da sich das Signalauge in drei vertikal gestapelte Teilaugen mit drastisch geringerer Amplitude aufteilt. Auf Standard-Leiterplattensubstraten wie Megtron-6 oder Megtron-8 führt die fundamentale Nyquist-Frequenz von 16 GHz (PCIe 6.0) bzw. 32 GHz (PCIe 7.0) zu massiven dielektrischen Verlusten und stark ausgeprägtem Skin-Effekt. Zusammen mit Diskontinuitäten durch Durchkontaktierungen (Vias), Gehäuseanschlüsse und Leiterbahntoleranzen wird das maximal zulässige Dämpfungsbudget der PCI-SIG von 32 dB bis 36 dB bereits nach Leiterbahnlängen von lediglich 15 bis 25 Zentimetern vollständig aufgezehrt.
Der Einsatz passiver Direktanschluss-Kupferkabel (DAC) ist infolgedessen auf maximale Distanzen von unter 1,0 Meter limitiert, was eine rackübergreifende Topologie physikalisch unmöglich macht. Die Ausweichung auf aktive elektrische Kabel (AEC) verlagert die Problematik lediglich in die thermische und elektrische Domäne: Integrierte Retimer-Bausteine an den Kabelenden kompensieren zwar Kanalverluste und Intersymbolinterferenzen (ISI) mittels Continuous Time Linear Equalization (CTLE) und Decision Feedback Equalization (DFE), konsumieren jedoch pro x16-Schnittstelle zwischen 20 und 35 Watt zusätzlicher Verlustleistung. Dies generiert kritische Hotspots direkt an den internen Steckfeldern und belastet das thermische Budget moderner Beschleunigerknoten unzulässig, während die Latenz durch komplexe Vorwärtsfehlerkorrektur (Flit-Mode FEC) weiter ansteigt.
Kanal-Einfügedämpfungsbudget strikt auf maximal 32 dB (PCIe 6.0) bzw. 36 dB (PCIe 7.0) bei Nyquist-Frequenz auslegen
Passive Kupferverbindungen (DAC) auf Längen unter 0,85 m innerhalb des gleichen Subracks begrenzen
Retimer-Dichte pro Baugruppe thermisch evaluieren und Verlustleistungsbudget von max. 2,5 W pro PCIe-Lane einhalten
Optische PCIe-Architektur und Dynamik mehrkanaliger VCSEL-Transceiver
Um die Beschränkungen elektrischer Kanäle aufzuheben, etabliert die optische PCIe-Architektur eine transparente, photonische Transportschicht direkt auf der Bitübertragungsschicht (Physical Layer), ohne die höheren Protokollschichten zu verändern. Native Semantiken wie speicherabgebildete Lese- und Schreiboperationen (Load/Store), flusssteuerungsbasierte Kreditvergaben (Credit-based Flow Control) sowie zustandslose Flit-Paketstrukturen (256-Byte-Flits) bleiben vollständig intakt. Dies ermöglicht eine nahtlose Kohärenzsicherung im Rahmen des CXL-Standards (Compute Express Link 3.1) über optische Strecken hinweg. Entscheidend ist hierbei die Eliminierung protokollbedingter Serialisierungs- und Entkapselungsoverheads, wie sie bei alternativen Ansätzen via InfiniBand oder RoCE unvermeidbar sind.
Die physikalische Realisierung erfolgt über monolithisch integrierte VCSEL-Arrays (Vertical-Cavity Surface-Emitting Laser), welche im Wellenlängenbereich von 850 nm oder bi-direktional bei 910 nm auf OM4- bzw. OM5-Gradientenindex-Multimodefaserbändern operieren. Diese elektro-optischen Wandler sind direkt an spezialisierte Treiber-ASICs und Transimpedanzverstärker (TIA) gekoppelt. Durch den Verzicht auf rechenintensive digitale Signalprozessoren (DSP) und die Nutzung rein analoger linearer Treiberschaltungen (Linear Optical Engines) lässt sich die kumulierte Wandlungslatenz für die elektro-optische und opto-elektrische Konversion (E-O-E) auf unter 5 Nanosekunden drücken. Damit erweitert sich die verlässliche Signalreichweite innerhalb des Rechenzentrums von unter 2 Metern auf 10 bis über 100 Meter bei minimaler Bitfehlerrate (Pre-FEC BER < 10^-6).
Multi-Mode VCSEL-Arrays auf 850 nm / 910 nm mit OM5-Fasern für Wellenlängenmultiplex (SWDM) spezifizieren
Gesamtlatenz der E-O-E-Wandlungsstufe unterhalb von 5 ns für CXL-Laufzeittoleranzen garantieren
Flit-Mode FEC-Grenzwerte auf optischer Ebene kontinuierlich per Eye-Monitor-Schaltung überwachen
Disaggregation auf Rack-Ebene und Scale-Up-Cluster-Topologien
Die Skalierung moderner Large-Language-Modelle erfordert heterogene Scale-Up-Domänen, in denen hunderte von Beschleuniger-ASICs (GPUs, XPUs) mit uneingeschränktem Speicherzugriff und deterministischer P2P-Kommunikation operieren müssen. Bisherige Server-Architekturen erzwangen die physische Konzentration von Recheneinheiten, NVLink- oder PCIe-Switches und CXL-Speichererweiterungen in monolithischen, extrem dicht bepackten 4U- bis 8U-Chassis. Durch den Einsatz optischer PCIe-Verbindungen wird diese strikte räumliche Kopplung aufgehoben: Rechenmodule, PCIe-Fabric-Switches (wie Astera Labs Scorpio) und CXL-Speicherpools können nun physisch auf separate Subracks oder vollkommen getrennte Racks verteilt werden, ohne den Latenzvorteil eines gemeinsamen Systembusses zu verlieren.
Diese multilaterale Disaggregation ermöglicht den Aufbau modularer Scale-Up-Cluster über mehrere Racks hinweg. GPU-Knoten müssen nicht mehr unter Berücksichtigung lokaler Stromversorgungs- und Kühlungsengpässe überdimensioniert werden, sondern lassen sich in spezialisierten Compute-Racks mit optimierter Flüssigkeitskühlung bündeln, während Speicherpools und optische Fabrics in thermisch weniger kritischen Zonen untergebracht werden. Zudem löst die dünne, flexible Faserverkabelung die massive Verbauung des Rack-Rückraums auf. Durch den Wegfall dicker Kupferkabelstränge wird die laminare Abführung der erwärmten Abluft drastisch verbessert, was parasitäre Ventilatorverluste minimiert und Ausfallraten senkt.
Scale-Up-Fabric über optische PCIe-Switches für mindestens 256 Endpunkte pro Domäne auslegen
Speicherpools via CXL 3.1 über Faserstrecken von bis zu 30 m mit Latenzzuwachs < 15 ns disaggregieren
Optische Kabelbaumführung zur vollständigen Freigabe der rückseitigen Chassis-Ausblaszonen planen
Verlustleistung, thermische Strömungswiderstände und Systemeffizienz
Die thermische Dynamik hochdichter Beschleuniger-Racks wird massiv durch den Strömungswiderstand (Impedanz) im Abluftpfad bestimmt. Konventionelle passive Kupferverkabelungen für x16-PCIe-Topologien erfordern hochgradig geschirmte, dicke AWG-26- oder AWG-24-Kabelbäume, die an den Rack-Rückseiten bis zu 40 Prozent des Querschnitts blockieren. Dieser Strömungswiderstand zwingt die Systemlüfter dazu, bei signifikant höheren Drehzahlen und statischen Drücken zu arbeiten, was den parasitären Energiebedarf der Serverkühlung um 10 bis 15 Prozent der Gesamtchassisleistung in die Höhe treibt. Der Wechsel auf photonische Übertragung via Multimode-Flachbandkabel reduziert das Blockadevolumen auf unter 3 Prozent und senkt den statischen Druckverlust drastisch.
Gleichzeitig verändert die Optik die systemische Verlustleistungsbilanz grundlegend. Während traditionelle Lösungen mit mehreren Retimer-Kaskaden pro Kanal arbeiten, eliminieren Near-Package-Optics (NPO) oder Front-Panel-Optikmodule (FPO) mit linearen Schnittstellen den Bedarf an stromhungrigen Re-Clocking-ASICs. Durch das Verlagern der optischen VCSEL-Engines weg vom thermischen Einflussbereich des über 1000 W heißen GPU-Packaging hin zur Gehäuseperipherie wird zudem eine präzise Temperaturkontrolle ermöglicht. VCSEL-Laserdioden reagieren hochsensibel auf thermische Belastungen jenseits von 70 °C Sperrschichttemperatur; die optische Entkopplung stellt somit eine hohe Lebensdauer und minimale Bitfehlerraten sicher.
Statischen Druckverlust der Chassisausblasung durch Fasernutzung um mindestens 30 % reduzieren
Sperrschichttemperatur der VCSEL-Dioden dauerhaft unter 65 °C mittels gerichteter Kaltluftführung halten
Verlustleistungsersparnis durch Retimer-Eliminierung gegen Transceiver-Verbrauch bilanzieren (< 1,5 W/Lane)
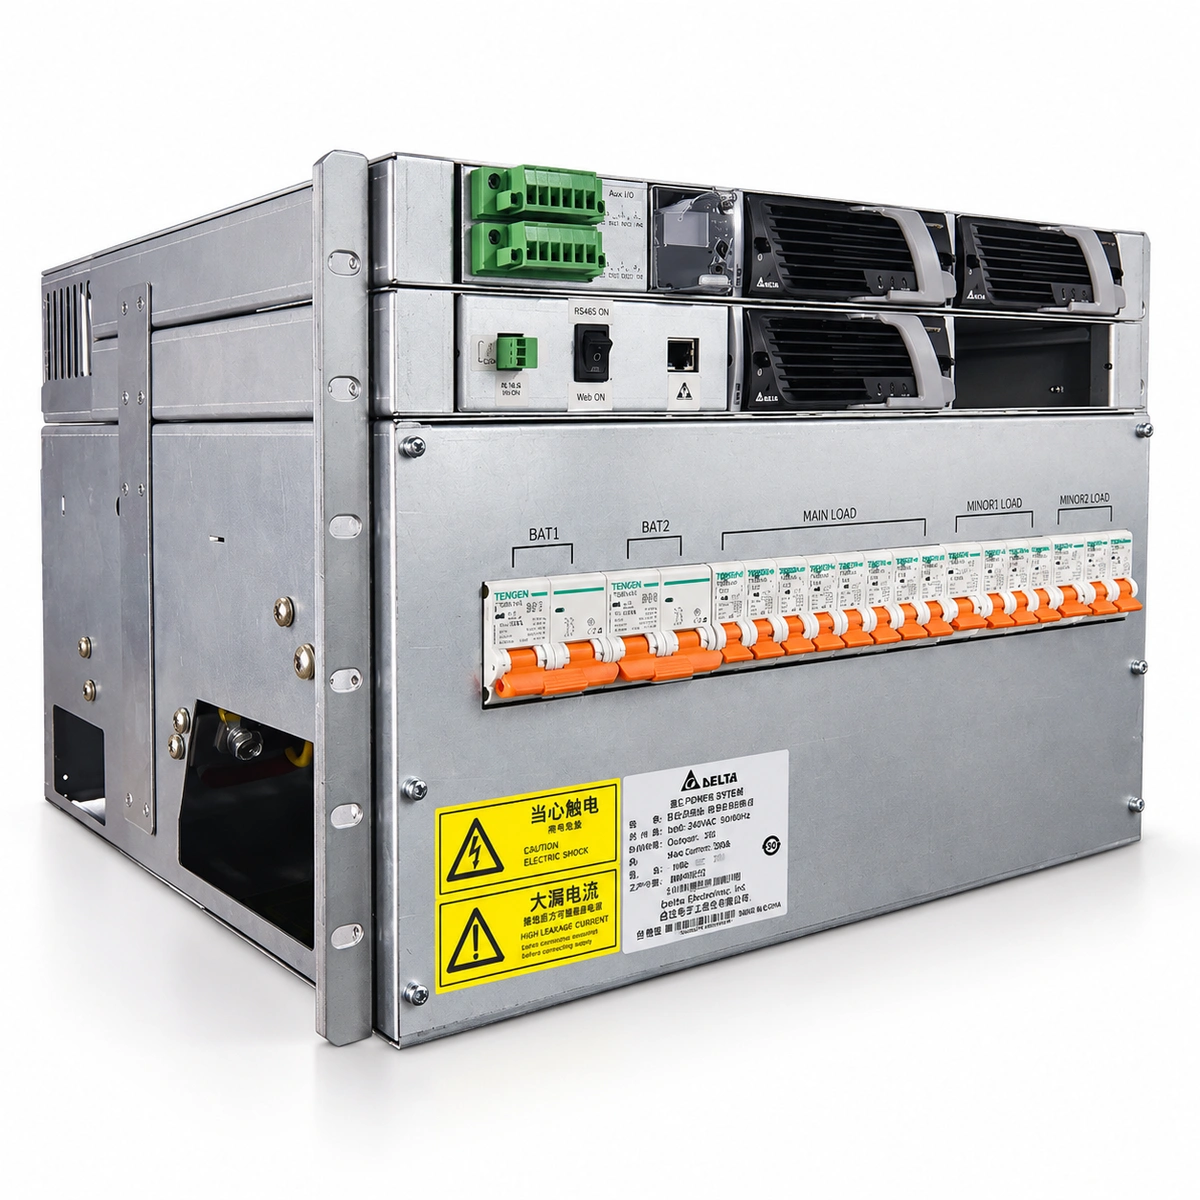
Gleichstromversorgung (-48V DC) und Hochverfügbarkeits-Infrastruktur
Hochdichte optische PCIe-Switche und disaggregierte Rechenschlitten stellen extreme Anforderungen an die Energieversorgungsinfrastruktur. Die traditionelle 12V-Gleichstromverteilung innerhalb des Racks führt bei Leistungen von über 40 kW pro Rack zu untragbaren Leitungsverlusten ($I^2R$) und massiven Sammelschienenabmessungen. Der Industriestandard für optisch disaggregierte Racks setzt daher auf hochmoderne -48V- bzw. 54V-DC-Open-Rack-Busbars (ORV3-Standard). Zentrale, hocheffiziente Gleichrichterstationen im Subrack wandeln den Dreiphasen-Wechselstrom um und speisen die optischen Fabric-Module direkt, wodurch kaskadierte Wandlungsstufen entfallen und Wirkungsgrade von über 97,5 Prozent realisiert werden.
Eine zentrale Herausforderung im Kontext optischer PCIe-Fabrics liegt im dynamischen Lastwechselverhalten. Schnelle Zustandswechsel der Beschleuniger zwischen Volllast (L0-Zustand) und Energiesparmodi (L0p/L1) erzeugen extreme Stromtransienten (di/dt) von mehreren hundert Ampere innerhalb von Mikrosekunden. Um zu verhindern, dass transiente Spannungseinbrüche optische Treiber oder Switch-Cores destabilisieren und unkalkulierbare Bus-Resets oder Fabric-Partitionierungen auslösen, sind verteilte Superkondensator- oder Batterie-Backup-Einheiten (BBU) sowie integrierte Active-Transfer-Switches (ATS) auf Modulebene unverzichtbar, die eine unterbrechungsfreie Haltezeit von mindestens 10 bis 20 Millisekunden sicherstellen.
Subrack-Stromversorgung auf redundante -48V / 54V DC Busbar-Topologie nach OCP ORV3 konfigurieren
Transientenfestigkeit der optischen Transceiver-Treiber gegen di/dt-Spitzen von > 500 A/µs absichern
Zweifach gespeiste BBU-Systeme mit nahtloser Umschaltung (< 2 ms) zur Verhinderung von Fabric-Resets integrieren
Standardisierung, MPO-Zuverlässigkeit und Wartungsprotokolle im Feld
Der Übergang von proprietären optischen Machbarkeitsstudien zu großflächig einsetzbaren Infrastrukturen wird maßgeblich durch die PCI-SIG Optical Workgroup vorangetrieben. Ziel der Standardisierung ist die Schaffung klar definierter elektro-optischer Abstraktionsgrenzen sowie formfaktorunabhängiger Spezifikationen für steckbare optische Transceiver (OSFP-XD, QSFP-DD) und optische Blind-Mate-Backplanes. Letztere ermöglichen das werkzeuglose Einschieben von Beschleunigerschlitten direkt in optische Schnittstellen im Rack-Rücken. Die größte operative Herausforderung im Feldeinsatz bleibt dabei die Anfälligkeit hochdichter Fasersteckverbinder (MPO-16, MPO-24, MMC) gegenüber partikulärer Kontamination.
Bereits Staubpartikel im Sub-Mikrometerbereich auf den Endflächen von Faserkernen können katastrophale Rückflussdämpfungen, Reflexionen und lokales Verbrennen durch hohe optische Leistungsdichten verursachen. Robuste Deployment-Konzepte in KI-Hyperscalern fordern daher erweiterte mechanische Verschlussmechanismen an optischen Blind-Mate-Schnittstellen sowie den Einsatz von Expanded-Beam-Linsentechnologien (PRIZM-MT), die den Lichtstrahl aufweiten und die Schmutzempfindlichkeit um Zehnerpotenzen senken. Ergänzend dazu müssen automatisierte Inspektionsprotokolle gemäß IEC 61300-3-35 sowie kontinuierliche In-Band-Telemetriesysteme etabliert werden, welche die optische Sendeleistung (Tx) und Empfänger-Signalstärke (Rx) in Echtzeit überwachen, um Degradationen prädiktiv zu beheben, bevor es zu Link-Drops kommt.
Blind-Mate-Backplane-Schnittstellen mit Expanded-Beam-Linsen zur Schmutzresistenz spezifizieren
Strikte Reinigungsprotokolle nach IEC 61300-3-35 vor jedem Steckvorgang per Video-Mikroskop vorschreiben
Prädiktive Telemetrie zur Erfassung von Tx/Rx-Dämpfungsdrifts im PCIe-Fabric-Manager implementieren
Beschaffung und technischer Support
Für Produktdatenblätter, kundenspezifische Stromversorgungslösungen oder Großhandelsangebote kontaktieren Sie RICEWIND.