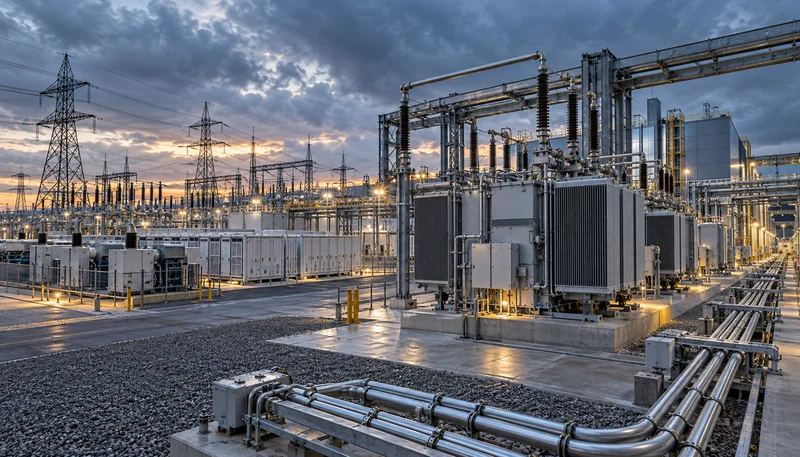
Die Dual-Track-Realität: Zeitgewinn durch Effizienz versus Netzausbau-Rückstand
Die aktuelle Transformation der Rechenzentrumsinfrastruktur wird von einer fundamentalen Divergenz der Investitions- und Innovationszyklen dominiert. Während Chip-Entwickler und Server-OEMs im 6- bis 12-Monats-Rhythmus neue Generationen von Beschleuniger-Architekturen mit thermischen Verlustleistungen von über 1.000 Watt pro Sockel ausliefern, erfordert die Bereitstellung der korrespondierenden Netzkapazitäten auf Übertragungsnetzebene zwischen 4 und 8 Jahren. Dies umfasst Genehmigungsverfahren, Umweltverträglichkeitsprüfungen, die Beschaffung von 400-kV/110-kV-Großtransformatoren mit Vorlaufzeiten von über 180 Wochen sowie den physischen Leitungsbau. Um den akuten Kapazitätsengpass abzufedern, setzen Betreiber auf eine nachfrageseitige Dual-Track-Strategie. Durch fortgeschrittene direkte Flüssigkeitskühlung (Direct-to-Chip DLC), mikrofluidische Kühlsysteme und algorithmisches Dynamic Voltage and Frequency Scaling (DVFS) gelingt es, die Power Usage Effectiveness (PUE) auf Werte unter 1,12 zu drücken und stranded capacity an existierenden Transformatorabgängen zu aktivieren.
Diese demand-side Optimierungen generieren jedoch lediglich einen zeitlichen Puffer von 18 bis 36 Monaten und lösen keineswegs die physikalische Klemmenleistungskrise. Die fortlaufende Skalierung von Clustergrößen auf 50.000 bis 100.000 Beschleuniger treibt den Anschlussbedarf einzelner Campus-Standorte von 100 MW in den Multi-Gigawatt-Bereich. An dieser Skalierungsgrenze stoßen thermodynamische und softwarebasierte Optimierungen an das Gesetz des abnehmenden Ertrags. Netzbetreiber fordern für diese Leistungsdichten verlässliche Kurzschlussleistungen und Frequenzstabilisierungsbeiträge, die durch reine Effizienzsteigerungen nicht bereitgestellt werden können. Der Glaube, man könne physische Netzinfrastruktur und HGÜ-Trassen durch intelligente Lastverteilung dauerhaft substituieren, ignoriert die Gesetze der elektrischen Energieübertragung und führt unweigerlich zu massiven Verzögerungen bei der Inbetriebnahme strategischer Rechenzentrumsprojekte.
Auditierung der realen Transformator-Reserven unter N-1-Bedingungen zur Bestimmung der tatsächlich nutzbaren thermischen Anschlusskapazität.
Angleichung der IT-Bereitstellungspläne an Lieferzeiten von 400-kV-Schaltanlagen und Großtransformatoren (Vorlaufzeit: 36 bis 48 Monate).
Ermittlung des Demand-Side-Puffers (in MW und Monaten) vor Erreichen der thermischen Netzanschlussgrenze des lokalen Netzknotens.
Bifurkation der Workload-Elastizität: Batch-Pre-Training versus unterbrechungsfreie Inferenz
Die technische Umsetzbarkeit nachfrageseitiger Netzflexibilität scheitert häufig an einer undifferenzierten Betrachtung des IT-Lastprofils. Rechenzentrums-Workloads müssen strikt in zeitlich verschiebbare (elastische) und zeitkritische (inelastische) Komponenten unterteilt werden. Das Pre-Training von Foundation Models, Checkpoint-Schreibzyklen, die Synthetisierung von Trainingsdaten sowie Offline-Einbettungen weisen eine hohe intrinsische Elastizität auf. Diese Prozesse können bei Spitzenlast-Signalen oder extremen Locational Marginal Prices (LMP) über Checkpointing-Mechanismen unterbrochen, auf 20 bis 30 % der Nennleistung gedrosselt oder geographisch in Regionen mit temporären Überkapazitäten migriert werden, ohne die Gesamtintegrität des Trainingszyklus irreversibel zu gefährden.
Im diametralen Gegensatz dazu steht die Inferenz-Infrastruktur für echtzeitfähige Produktivsysteme, automatisierte Transaktionssysteme und generative Konversationsmodelle. Hier gelten harte Service Level Agreements (SLAs) mit maximal zulässigen Latenzen im zweistelligen Millisekundenbereich. Ein Abwurf oder eine signifikante thermische Drosselung dieser Lasten führt zu unmittelbaren Timeouts und SLA-Vertragsstrafen. Rechenzentrumsarchitekten sind daher gezwungen, getrennte Energieverteilungstopologien (Dual-Bus-Systeme) zu etablieren: Ein hochverfügbarer Inferenz-Pfad mit unterbrechungsfreier 2N-Stromversorgung und extrem steifen Spannungsbändern koexistiert mit einem bedarfsweise abschaltbaren N- oder N+1-Pfad für das Batch-Training. Diese architektonische Aufspaltung verkompliziert die Schaltanlagenkonfiguration, ist jedoch die Grundvoraussetzung, um Flexibilitätsprämien am Netzmarkt ohne Beeinträchtigung des Kerngeschäfts realisieren zu können.
Implementierung softwaredefinierter Leistungszonen zur galvanischen und logischen Trennung von elastischen Trainings- und Inferenz-Racks.
Validierung von automatisierten Checkpoint-Resume-Zyklen unter Lastabwurf-Bedingungen innerhalb eines Zeitfensters von < 500 ms.
Auslegung der Schaltanlagen mit motorisierten Leistungsschaltern für kontrollierte Teilabwürfe unkritischer Rechenlasten bei Netzengpässen.
Die Verifikationslücke: Vertragliche Curtailment-Audits und Netzanschlusskriterien
Regional Transmission Operators (RTOs) wie PJM, ERCOT oder die europäischen Übertragungsnetzbetreiber begegnen reinen Software-Versprechungen zur Lastreduktion mit zunehmender Skepsis. Die sogenannte 'Paper Flexibility' – vertraglich zugesicherte, aber rein softwaregesteuerte Lastkappung – wird bei Netzkapazitätsprüfungen für Neuanschlüsse zunehmend verworfen. Um Netzüberlastungen und Auslösungen des Unterfrequenz-Schutzes (UFLS) abzuwenden, fordern die Regulierungsbehörden manipulationssichere, deterministische Nachweise. Ohne hardwarebasierte Verriegelungen und auditierbare Telemetrieschnittstellen verweigern Netzbetreiber den Netzanschluss oder stufen die Einspeise- bzw. Bezugszusagen auf unzureichende 'Non-Firm'-Kontrakte zurück.
Zur Schließung dieser Verifikationslücke gewinnen neue Metriken wie die Power Compute Effectiveness (PCE) und integrierte Lastabwurf-Controller an Bedeutung. Betreiber installieren dedizierte Remote Terminal Units (RTUs), die über IEC 61850 oder DNP3 direkt mit den Netzleitsystemen der TSOs kommunizieren. Im Falle einer Netzüberlastung müssen diese Einheiten in der Lage sein, innerhalb von 100 bis 200 Millisekunden eine physikalisch verifizierbare Lastreduktion herbeizuführen. Dies geschieht entweder durch die direkte Aktivierung von BESS-Entladezyklen zur Netzentlastung oder durch das gezielte Trennen definierter Transformator-Abgänge über fest verdrahtete Schutzkreise, wodurch die Einhaltung von N-1-Kriterien im übergeordneten Verteilnetz sichergestellt wird.
Installation von IEC 61850-konformen Schutz- und Steuergeräten zur Echtzeit-Telemetrieübertragung an den Übertragungsnetzbetreiber.
Einrichtung hardwareverriegelter Lastabwurfpfade (Hardwired Interlocks) außerhalb des IT-Betriebssystems zur garantierten Leistungsbegrenzung.
Implementierung von PCE-Logging-Systemen zur sekundengenauen Dokumentation des tatsächlichen Lastgangs bei Abregelungsereignissen.
Behind-the-Meter-Mikronetze: BESS-Großspeicher und Schnellstart-Turbinen zur Spitzenlastkappung
Um sich gegen unzureichende Netzkapazitäten und volatile Strompreise abzusichern, vollziehen Hyperscale-Campusse den Wandel vom passiven Großverbraucher zum aktiven Behind-the-Meter (BTM) Microgrid. Das Herzstück dieser dezentralen Energiearchitektur bilden containerisierte Batteriespeichersysteme (BESS) auf Basis von Lithium-Eisenphosphat (LFP) oder Natrium-Ionen-Zellen. Diese Speicher weisen C-Raten von 1C bis 4C auf und erfüllen eine doppelte Funktion: Sie puffern die extremen di/dt-Lastsprünge moderner KI-Prozessoren netzseitig ab und stellen innerhalb von Millisekunden Regelleistung bereit, um Netzwirkleistungssprünge bei Peak-Shaving-Ereignissen vollständig vom Übergabepunkt zu entkoppeln.
Zur Sicherstellung einer mehrtägigen Autarkie und zur Überbrückung längerer Netzunterbrechungen (Resilience Bridging bis zu 48 Stunden) werden BESS zunehmend mit aero-derivativen Gasturbinen oder schnellstartenden Gasmotoren (H2-ready) kombiniert. Diese Einheiten erreichen innerhalb von weniger als 5 Minuten ihre volle Nennleistung und ermöglichen einen stabilen Inselbetrieb des gesamten Campus. Durch diese Hybridisierung kann der Betreiber nicht nur garantierte Curtailment-Anforderungen erfüllen, sondern überschüssige Kapazitäten über Frequenzhaltungs- (FCR) und automatische Frequenzwiederherstellungsreserven (aFRR) an den Energiemärkten monetarisieren. Damit wird die BTM-Infrastruktur vom reinen Investitionskostenfaktor zum strategischen Flexibilitäts-Asset.
Dimensionierung eines LFP/Na-Ion-BESS-Systems mit mindestens 2C-Entladefähigkeit zur Kompensation von Millisekunden-Lastgradienten.
Integration von aero-derivativen Gasturbinen mit Schnellstartfähigkeit (< 5 Minuten bis Nennlast) für Inselbetriebsfähigkeit.
Parametrierung der Microgrid-Steuerung zur automatisierten Umschaltung zwischen netzparallel geschaltetem Peak-Shaving und galvanisch getrenntem Inselmodus.
Topologien der Energieverteilung: 380V/700V-Gleichstrom-Sammelschienen und Festkörpertransformatoren
Auf Rack- und Reihenebene stoßen klassische Niederspannungs-Wechselstromtopologien (480V/208V bzw. 400V/230V AC) an ihre physikalischen Grenzen. Die Stromstärken, die zur Versorgung moderner Serverracks mit Leistungsdichten von 100 kW bis über 300 kW pro Rack erforderlich sind, bedingen massive Kupferquerschnitte und erzeugen untragbare ohmsche Leitungsverluste ($I^2R$). Die logische Konsequenz ist der Übergang zu Gleichstrom-Sammelschienenarchitekturen auf 380-V-DC- oder 700-V-DC-Niveau direkt an den Power Shelves. Diese Transformation reduziert die Wandlungsstufen von der Mittelspannung zur GPU-Kernspannung drastisch, eliminiert Blindleistungsverluste und senkt die elektrischen Leitungsverluste im White Space um mehr als 40 %.
Gleichzeitig erfordern die dynamischen Lastwechsel von KI-Clustern – beispielsweise der synchrone Wechsel von Leerlauf zu Volllast innerhalb von Mikrosekunden – völlig neuartige Leistungselektronikkomponenten. Der Einsatz von Festkörpertransformatoren (Solid-State Transformers, SST) auf Basis von Siliziumkarbid (SiC) und Galliumnitrid (GaN) ermöglicht extrem schnelle Regelkreise mit Schaltfrequenzen im zweistelligen Kilohertzbereich. In Kombination mit hocheffizienten Gleichrichtermodulen (mit Wirkungsgraden von 97,5 bis 98,5 %) fangen diese Systeme extreme $di/dt$-Transienten intern ab, noch bevor diese sich als harmonische Verzerrungen oder Spannungseinbrüche auf die vorgeschalteten Mittelspannungs-Transformatoren auswirken und Schutzschalter auslösen können.
Umstellung der Rack-Einspeisung auf standardisierte 380V/700V-DC-Sammelschienensysteme zur Reduzierung des Kupferbedarfs und der Leitungsverluste.
Einsatz von SiC-basierten Gleichrichtern und Wandlern mit einem Teillastwirkungsgrad von > 97 % über den gesamten Betriebsbereich.
Installation von aktiven Oberschwingungsfiltern und SST-Einheiten zur Unterdrückung von Transienten bei synchronen KI-Burst-Events.
Kapitalallokation und Politik: Direktfinanzierung von HGÜ-Trassen und Co-Location-Modelle
Die Dimension der anstehenden Kapazitätserweiterungen zwingt Betreiber und Energieversorger zu neuen Formen der Kapitalallokation und Kooperation. Da traditionelle Netzbetreiber durch regulatorische Renditeobergrenzen und langwierige Netzentwicklungspläne gebunden sind, gehen Hyperscaler zunehmend dazu über, die Errichtung von Netzinfrastruktur direkt bilanzwirksam zu finanzieren. Dies umfasst die Übernahme von Vorfinanzierungskosten für neue Umspannwerke, die Bereitstellung von Eigenkapital für Hochspannungs-Gleichstrom-Übertragungstrassen (HGÜ) und den Abschluss langfristiger Power Purchase Agreements (PPAs) mit garantierten Abnahmevolumina über 15 bis 20 Jahre, um Versorgungsunternehmen Investitionssicherheit für neue Erzeugungskapazitäten zu bieten.
Parallel dazu zeichnet sich eine geographische Neuausrichtung ab: Statt gigantische Rechenzentren in bereits überlasteten Netzwerk-Hubs wie Frankfurt, London oder Nord-Virginia anzusiedeln, gewinnt das Co-Location-Prinzip an primären Energieerzeugungsknoten massiv an Bedeutung. Cluster für das unkritische Basis-Training werden unmittelbar an Kernkraftwerken, großen Wasserkraft-Kaskaden oder designierten Offshore-Wind-Anlandepunkten errichtet. Durch diese direkte Kopplung ('Behind-the-Generator') entfällt die Belastung des öffentlichen Übertragungsnetzes weitgehend, Netzanschlusszeiten verkürzen sich signifikant, und die Rechenzentrumsbetreiber sichern sich dauerhaft CO2-freie Bandenergie zu stabilen Grenzkosten.
Strukturierung direkter Co-Finanzierungsmodelle mit Netzbetreibern zur Beschleunigung von HGÜ- und Umspannwerksprojekten.
Standortbewertung für reine Trainings-Campus-Cluster direkt an Erzeugungsanlagen (Kernkraft, Laufwasser, Windparks).
Absicherung langfristiger 24/7-PPA-Vertragsstrukturen mit Kopplung an standortnahe firm carbon-free generation (CFG).
Beschaffung und technischer Support
Für Produktdatenblätter, kundenspezifische Stromversorgungslösungen oder Großhandelsangebote kontaktieren Sie RICEWIND.