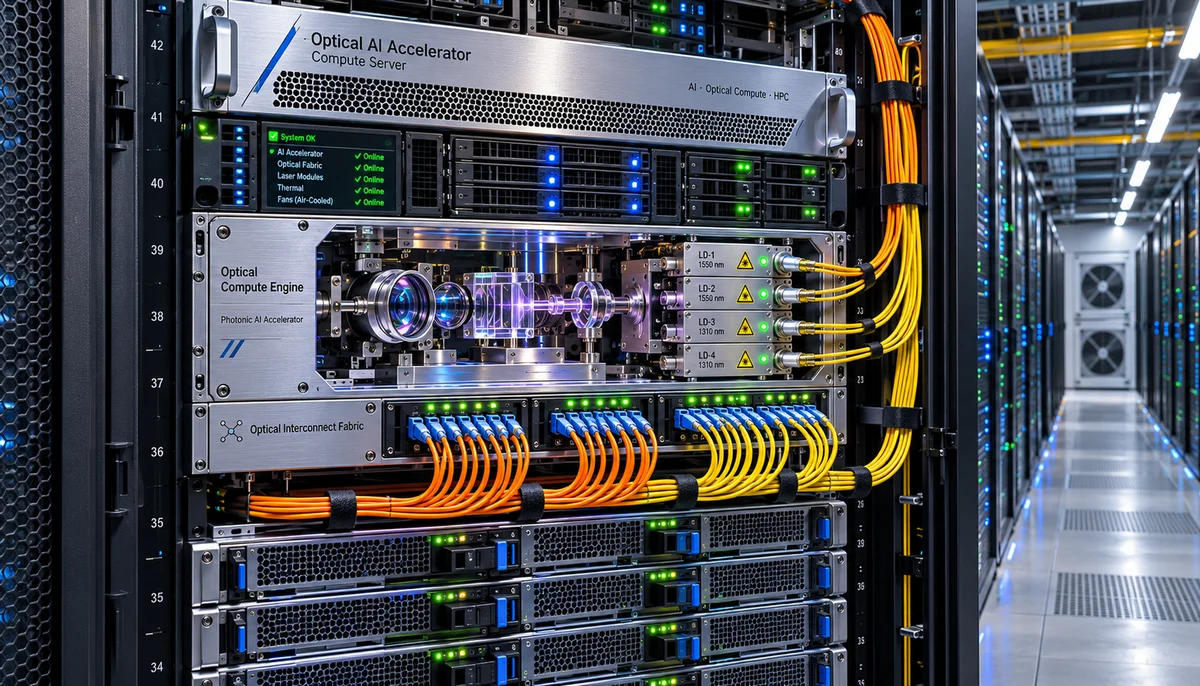
Physikalische Grundlagen der Matrixmultiplikation: Elektronen versus Photonen
Die mathematische Grundlage moderner Transformermodelle stützt sich fast ausschließlich auf General Matrix Multiply (GEMM) Operationen. In konventionellen Halbleiter-GPUs erfordert die Ausführung dieser Operationen das ständige Umladen parasitärer Leitungskapazitäten über Milliarden von Feldeffekttransistoren. Mit dem Voranschreiten moderner Lithografieknoten auf 3nm- und 2nm-GAAFET-Strukturen steigen die Leckströme und thermischen Verlustleistungsdichten überproportional an. Dies führt dazu, dass herkömmliche Digitalschaltungen zwischen 1,0 und 3,0 Picojoule pro Multiply-Accumulate (MAC) Operation verbrauchen, wobei ein erheblicher Teil dieser Energie nicht für die logische Verknüpfung selbst, sondern für den internen Datentransport über metallische Verbindungsleitungen dissipiert wird.
Optische KI-Beschleuniger umgehen diese fundamentale thermodynamische Hürde, indem sie Berechnungen im optischen Bereich ausführen. Eingangsdaten werden als Intensitäts- oder Phasenwerte auf kohärente Laserstrahlen moduliert, die über Wellenlängenmultiplexverfahren (WDM) gebündelt werden. Das Passieren eines passiven optischen Netzwerks – implementiert über Silizium-Mikroring-Resonatoren, Mach-Zehnder-Interferometer oder diffraktive Freiraumelemente – realisiert die Multiplikation und Summation als physikalischen Welleninterferenzeffekt. Da diese passiven Rechenschritte mit Lichtgeschwindigkeit und ohne kapazitives Schalten erfolgen, sinkt der Energieverbrauch auf unter 0,1 Picojoule pro MAC. Die dissipative Verlustleistung im optischen Rechenkern nähert sich dabei theoretisch Null an.
Energieeffizienz: Reduktion des Energiebedarfs auf sub-0,1 pJ/MAC im Vergleich zu 1,0 bis 3,0 pJ/MAC bei 3nm/2nm CMOS-Halbleitern.
Signalpropagation: Nahezu latenzfreie Inferenz linearer Schichten durch passive photonische Interferenz mit Lichtgeschwindigkeit.
Multiplex-Skalierung: Gleichzeitige Ausführung paralleler Vektormultiplikationen über Dense Wavelength Division Multiplexing (DWDM).
Disaggregierte Inferenztopologie: Entkopplung von Prefill- und Decode-Phasen
Die Inferenz großer Sprachmodelle weist eine ausgeprägte rechnerische Asymmetrie zwischen ihren beiden Kernphasen auf. Die Prefill-Phase verarbeitet den gesamten Prompt-Kontext simultan. Hierbei werden dieselben Gewichtsmatrizen über Tausende von Eingabetoken hinweg wiederverwendet, was zu einer extrem hohen arithmetischen Intensität führt. Diese Phase ist strikt compute-bound und skaliert linear mit der Matrixmultiplikationskapazität der Hardware. Die anschließende Decode-Phase hingegen generiert Token sequenziell, wodurch pro neu generiertem Token sämtliche Modellgewichte einmalig aus dem Speicher geladen werden müssen. Das Decode-Regime ist daher fast vollständig durch die Speicherbandbreite von HBM3e- und HBM4-Subsystemen begrenzt.
Durch eine disaggregierte Serving-Architektur wird dieser Flaschenhals architektonisch aufgelöst. Spezialisierte optische Beschleuniger, wie etwa aus den Validierungsreihen des UK ARIA Scaling Inference Labs, übernehmen exklusiv die rechenintensive Prefill-Phase für Kontexte von 32k bis über eine Million Token. Sie führen die Key-Value-Projektionen photonisch durch und übertragen die generierten KV-Caches über latenzarme RoCEv2- oder InfiniBand-Verbindungen direkt an GPU- oder ASIC-basierte Decode-Knoten. Softwareseitig wird dieses Paradigma nahtlos durch Frameworks wie vLLM via Chunked Prefill und PagedAttention-Offloading, SGLang sowie Ray Serve unterstützt, was die GPU-Cluster von unproduktiven Wartezyklen befreit.
Arithmetische Spezialisierung: Zuordnung photonischer GEMM-Kerne zur compute-limitierten Prefill-Verarbeitung massiver Kontexte.
Fabric-Datenaustausch: Streaming vorberechneter KV-Caches über 400G/800G RoCEv2-Fabrics mit deterministischer Microsekunden-Latenz.
Framework-Integration: Native Einbindung in vLLM, SGLang und KServe zur transparenten Orchestrierung hybrider Rechenressourcen.
Elektrische Leistungsbudgets, Thermik und Standard-Luftkühlungsintegration
Die Skalierung moderner Hyperscale-Rechenzentren scheitert zunehmend an den Anschlussleistungen der Umspannwerke und den thermischen Maximalwerten pro Rack. Während herkömmliche GPU-Cluster Leistungsdichten von 40 kW bis über 100 kW pro Rack erreichen und zwingend komplexe Direct-to-Chip-Flüssigkühlungen (DLC) sowie Cooling Distribution Units (CDUs) erfordern, erlaubt die photonische Inferenz eine Rückkehr zu etablierten Infrastrukturen. Die optischen GEMM-Kerne erzeugen keine nennenswerten Hotspots auf dem Siliziumdie, wodurch die thermische Dissipation primär auf die Peripheriekomponenten beschränkt bleibt.
Ein optischer Inferenzserver setzt auf eine hybride elektro-optische Systemarchitektur. Die massiv-parallele lineare Mathematik verbleibt im optischen Modul, während klassische digitale Mikrocontroller und SRAM-Strukturen für nichtlineare Operationen wie Softmax, SiLU und LayerNorm zuständig sind. Durch diese Aufteilung bleibt der Gesamtleistungsbedarf eines 2U- bis 4U-Chassis typischerweise in einem Bereich von 1,5 kW bis 2,5 kW. Entsprechende Systeme lassen sich problemlos in reguläre EIA-310 19-Zoll-Racks integrieren und innerhalb von Standard-Kaltgang-/Warmgang-Einhausungen rein luftgekühlt nach ASHRAE A1/A2-Richtlinien betreiben, wodurch Nachrüstungskosten in Millionenhöhe entfallen.
Chassis-Leistungsbudget: Begrenzung der Leistungsaufnahme auf 1,5 kW bis 2,5 kW pro Multi-Petaflops-Recheneinheit.
Infrastrukturkompatibilität: Reibungslose Bereitstellung in Standard-19-Zoll-Racks ohne Notwendigkeit für sekundäre Kühlmittelkreisläufe.
Thermomanagement: Konformität mit ASHRAE A1/A2-Spezifikationen bei ausschließlicher Nutzung konventioneller N+1 Lüftermodule.
Optoelektronische Lieferkette, Komponenten und industrielle Zuverlässigkeit
Ein wesentlicher Faktor für die Marktreife optischer KI-Beschleuniger ist der Rückgriff auf erprobte Fertigungsprozesse der Telekommunikationsindustrie. Anstelle spekulativer Neuentwicklungen basieren die optischen Engines auf standardisierten Komponenten: Distributed Feedback (DFB) Laserarrays, Elektroabsorptionsmodulatoren (EAM), Silizium-Phasenmodulatoren und optische Transceiver im OSFP- oder QSFP-DD-Formfaktor, die in den bewährten Wellenlängenbändern bei 1310 nm (O-Band) und 1550 nm (C-Band) arbeiten. Diese Komponenten profitieren von jahrzehntelanger Optimierung bezüglich Ausbeute, Wafer-Skalierung und Alterungsverhalten.
Herausforderungen bezüglich mechanischer Vibrationen, Schockbelastungen und thermischer Drift werden durch geschlossene Regelkreise gelöst. Integrierte thermoelektrische Kühler (TEC) in Kombination mit interferometrischen Feedback-Schleifen halten die Wellenlängendrift der Laserquellen unter 0,01 Nanometer pro Grad Celsius über ein Betriebstemperaturfenster von 10 °C bis 45 °C stabil. Um die unvermeidliche optische Einfügedämpfung (Insertion Loss) entlang komplexer Wellenleiterpfade zu kompensieren, kommen reflexionsarme dielektrische Beschichtungen und hochempfindliche Ge-Photodiodenarrays zum Einsatz. Diese stellen sicher, dass das Signal-Rausch-Verhältnis (SNR) für INT8- und FP8-Präzisionsanforderungen vollständig ausreicht.
Wellenlängenstabilität: Closed-Loop-Driftkontrolle unter 0,01 nm/°C zur Sicherstellung deterministischer Signalpegel.
Fertigungskompatibilität: Nutzung etablierter Silizium-Photonik-Foundries (SiPh) auf 200mm/300mm SOI-Wafern.
Präzisionsgarantie: Ausreichendes Signal-Rausch-Verhältnis (SNR) zur fehlerfreien Repräsentation von INT8- und FP8-Matrizen.
TCO-Quantifizierung, PUE/WUE und Rückgewinnung gestrandeter Rechenzentrumskapazität
In vielen Hyperscale-Einrichtungen existiert das Phänomen der gestrandeten Leistung (Stranded Power): Zwar steht physischer Rack-Platz zur Verfügung, die Zuleitungskapazität des lokalen Netzes ist jedoch vollständig ausgeschöpft. Da 60 bis 70 Prozent des Energiebudgets reiner GPU-Inferenzcluster auf den Prefill-Schritt entfallen, wirkt der Einsatz photonischer Beschleuniger als Kapazitätsmultiplikator. Durch die Verlagerung dieser Last auf optische Engines kann die Prompt-Verarbeitungskapazität innerhalb bestehender Megawatt-Feeder verdreifacht werden, ohne dass eine Erweiterung der Netzanschlussleistung erforderlich ist.
Gleichzeitig verbessern sich die ökologischen und betriebswirtschaftlichen Kennzahlen drastisch. Der Verzicht auf evaporative Kühltürme reduziert den Wasserverbrauch (WUE) an den Standorten auf nahezu null, während der Power Usage Effectiveness (PUE) Wert durch den verringerten Kühlaufwand sinkt. Großskalige Validierungen, unter anderem im Rahmen der ARIA-Initiative, belegen eine mittlere Betriebsdauer zwischen Ausfällen (MTBF) von über 100.000 Stunden für die optoelektronischen Baugruppen. Die nahtlose Einbindung in Kubernetes-Cluster erlaubt es Hyperscalern, Inferenzflotten ökonomisch zu betreiben und die Total Cost of Ownership pro Million generierter Token massiv zu senken.
Kapazitätsausnutzung: Verdreifachung des verarbeitbaren Inferenzvolumens unter Beibehaltung bestehender Megawatt-Limits.
Ressourceneffizienz: Drastische Reduktion des WUE-Werts durch Eliminierung von Verdunstungskühlungssystemen.
Betriebsfestigkeit: Validierte System-MTBF von über 100.000 Stunden unter produktiven Rechenzentrumsbedingungen.
Beschaffung und technischer Support
Für Produktdatenblätter, kundenspezifische Stromversorgungslösungen oder Großhandelsangebote kontaktieren Sie HEFENGQI.