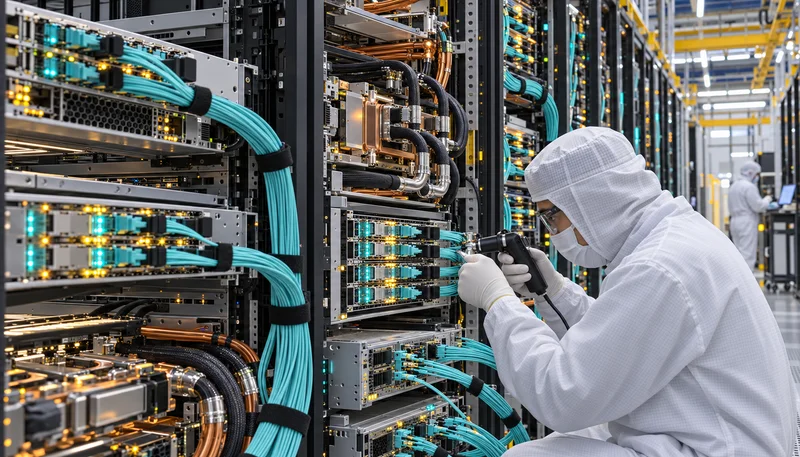
高频铜介质物理极限与PCIe 6.0/7.0信号完整性衰减分析
在PCIe 6.0演进至64 GT/s以及PCIe 7.0迈向128 GT/s的技术迭代中,物理层从传统NRZ信令全面切换为PAM4脉冲幅度调制。PAM4在相同奈奎斯特频率下实现了双倍数据吞吐,但代价是眼高压缩至传统NRZ的三分之一,信噪比恶化了9.6 dB左右。在16 GHz(PCIe 6.0)与32 GHz(PCIe 7.0)的奈奎斯特频率点上,高频趋肤效应与FR-4/Megtron-8等PCB基材介质损耗(Dielectric Loss)呈指数级攀升。标准机柜内无源直连铜缆(DAC)与板卡走线的总插入损耗预算被严格限制在32 dB至36 dB范围内,这导致无源铜介质的有效物理传输距离被极限压缩至1.0米至1.5米以下,彻底丧失了跨机架直连扩展能力。
为缓解铜缆高频衰减,工业界曾广泛引入有源电缆(AEC)及重定时器(Retimer)芯片。然而,在密集的x16或x32直连总线架构中,Retimer芯片单通道功耗普遍达到2至3瓦,一个全互连机架仅用于信号再生的额外功耗就可达数千瓦,并诱发机箱局部的严苛热点。此外,多级Retimer级联引入的确定性时延抖动、前向纠错(FEC)编解码时延以及高频阻抗不连续点产生的信道串扰,使整个电气信道的误码率(BER)逼近1e-4的FEC纠错红线,硬件工程师在信号均衡调整(CTLE/DFE)上面临边际效益递减的物理绝壁。
严格核算端到端32 dB(PCIe 6.0)与36 dB(PCIe 7.0)奈奎斯特损耗预算,限制主板无源铜走线长度小于250 mm
在系统级仿真中将PAM4眼高安全裕量设定不低于15 mV,眼宽抖动窗口裕量保留大于0.2 UI
评估多级Retimer芯片级联带来的延迟累积,确保物理层额外重定时器时延严格控制在12 ns以内
光PCIe架构演进与多通道VCSEL光收发引擎动力学
为了在根本上突破电互连信道损耗壁垒,Native Optical PCIe架构通过电光一体化收发引擎,将底层物理传输介质从微带线/同轴电缆切换为多模光纤,同时完整保留PCIe协议的高层语义。该架构直接在物理层进行电光调制,不改变事务层数据包(TLP)、数据链路层Flit帧格式、基于信用(Credit-Based)的流量控制机制以及CXL协议的缓存一致性状态机。通过在PHY控制器与光引擎之间建立低阶无时钟恢复通道,原生光PCIe规避了网络协议栈封装开销,保证软件栈对于硬件介质由铜转光完全透明无感。
核心光引擎采用多通道垂直腔面发射激光器(VCSEL)阵列,工作波长涵盖850 nm与910 nm双波段,并匹配OM4/OM5弯曲不敏感多模带状光纤(Ribbon Fiber)。VCSEL阵列具备极高的电流调制带宽与优异的能效比,其内置的高灵敏度跨阻放大器(TIA)与驱动器阵列能够实现小于5 ns的端到端单向电光-光电转换时延。借助于多模光纤在吉赫兹频段近乎平坦的低衰减特性(850 nm衰减约2.5 dB/km),机房内的PCIe信号有效覆盖半径从亚米级无缝扩展至10米至100米以上,为跨机架的大规模Scale-Up扩展构筑了高带宽物理底座。
选用850 nm/910 nm波长的多通道VCSEL驱动阵列,确保单通道调制速率满足64 GT/s PAM4要求
端到端电光/光电转换总时延(E-to-O/O-to-E)控制在5 ns以内,确保物理层Flit同步不发生重传溢出
部署OM5宽带多模带状光纤系统,在高密度弯曲半径小于7.5 mm时维持附加损耗低于0.1 dB
机架级计算解耦与跨机架Scale-Up AI集群拓扑解构
在大模型参数量跨越万亿门槛的背景下,传统的单机架紧耦合GPU服务器架构遭遇了严重的供电与散热瓶颈。原生光PCIe的百米级低时延传输特性使得计算资源、内存资源与交换织网的机架级全解耦(Rack-Scale Disaggregation)成为现实。硬件架构师可以将超高密度的GPU/XPU计算托盘、基于CXL的多TB级内存池扩展扩展柜,以及专用的PCIe/CXL Smart Fabric交换机物理分离部署在不同机柜中。这种物理层面的多边解耦彻底打破了算力聚集与局部电力供给上限之间的刚性绑定。
在集群拓扑层面,光PCIe与CXL结合支持跨多个物理机架构建统一的缓存一致性Scale-Up互连域。数十个计算托盘通过光纤背板与PCIe Switch Fabric直连,共享低访问时延的非易失性存储与远端动态随机存取内存(DRAM)池。计算节点通过标准的内存加载/存储(Load/Store)原子指令即可直接寻址远端机柜内存,相较于传统的RDMA over Converged Ethernet(RoCEv2)方案,不仅消除了网络协议栈数十微秒的处理延迟,更规避了拥塞丢包导致的性能断崖,显著提升了大规模并行训练中的有效计算时间比(Goodput)。
采用多层级PCIe/CXL Smart Fabric交换矩阵,实现单域支持跨机架挂载多达256个GPU加速节点
为解耦CXL内存资源池配置动态NUMA分配策略,确保跨机架远端内存访问时延增量小于150 ns
在交换网络层启用动态链路带宽重配置与信用分配机制,彻底避免突发大块Load/Store指令引发端点死锁
功耗预算权衡、后阻抗气流优化与互连热力学
传统AI高密机柜后部被密布的x16无源铜缆及厚重的主动电缆(AEC)束完全占据,在机箱出风口形成极大的物理流阻(Airflow Impedance)。风道堵塞导致服务器内部散热盲区扩大,强制机柜冷却风机长期维持在80%以上的转速区间,导致风机寄生功耗激增。引入外径仅数毫米的超柔性带状光缆替代粗重铜缆束后,机柜背板排风阻抗骤降70%以上,不仅显著降低了系统背压与机箱内部温升,更使整机风冷散热能耗实现20%至30%的结构性下降。
在电能消耗与热源分布模型中,光互连技术呈现出独特的能效权衡特征。虽然光收发引擎单通道引入了约1.5W至2.5W的静态功耗,但其彻底免除了铜缆信道中功耗极高的多级DSP与高阶数字Retimer(单链路往往消耗10W以上)。此外,系统工程中采用了板载中间光学引擎(Mid-Board Optics, MBO)与前面板光收发结构,将高热光电转换芯片在物理布局上与数千瓦功耗的GPU ASIC芯片实施严格的热隔离。这种布局大幅降低了激光芯片长期处于高温环境下的热退化速率,优化了整机热力学传导拓扑。
计算并优化后部排风截面自由开孔率,采用多模光纤束替代铜缆使阻抗截面开孔率维持在65%以上
配置光引擎板级隔离布局,确保VCSEL工作结温在严苛满载散热环境下稳定低于85摄氏度
建立机架级能效平衡模型,实现光电转换功耗与省除的Retimer及风机功耗差值大于净结余15%
子系统直流配电架构与高可用电源支撑保障体系
光PCIe交换矩阵与高密计算托盘的规模化部署,对系统配电架构的瞬态响应与高可用性提出了近乎苛刻的要求。传统机架内部采用的12V配电总线在数万安培电流负载下,导线铜排阻抗损耗极大(I²R Loss)。现代光PCIe解耦机架全面转向高效率-48V甚至更高电压的集中式直流母线槽(Busway)架构。通过在机架子系统内部部署高频隔离非稳压点负载(PoL)转换器,实现从-48V直流母线到ASIC与光学引擎毫伏级敏感供电轨的一级高效转换,端到端供电效率显著突破96%。
在动态负载响应方面,光PCIe链路在执行L0s/L1等低功耗动态状态切换时,光引擎与驱动芯片的电流需求会在微秒级时间内产生极高斜率的阶跃突变(di/dt)。配电系统必须在子系统级配置低ESR的固态铝聚合物电容阵列与瞬态抑制滤波网络,以抑制母线纹波。同时,采用双路互投(Dual-Source ATS)与分布式N+2并联冗余整流模块体系,结合机架级超级电容或锂电备份单元(BBU),在微秒级电网扰动或市电闪络期间提供不间断的能量钳位,杜绝任何因瞬态欠压导致的PCIe链路重置或交换织网分区崩溃。
在交换与计算子框部署-48V高压直流集中母线系统,确保母线阻抗压降严格控制在0.5%以内
为光引擎驱动电路线路设计瞬态抑制电路,确保在50 A/μs阶跃电流冲击下,供电轨电压漂移小于±2%
集成双路冗余直流配电控制器,实现毫秒级电源热插拔切换并保持无损PCIe链路状态机锁定
标准演进路径、盲插光学背板可靠性与现场运维协议规范
光PCIe互联技术正经历从早期OCP概念验证向PCI-SIG官方标准化深度演进的关键阶段。PCI-SIG Optical Workgroup正在加速确立光学物理层的合规测试规范、电气-光学转换接口标准以及统一的管理总线协议,打破专有私有协议的生态锁定。在硬件工程实施中,高密度盲插光学背板(Blind-Mate Optical Backplane)技术成为了实现节点无工具热插拔的核心。通过结合高精度的弹簧浮动对准销与微透镜阵列扩展光束技术,使光纤托盘在推入机柜插槽瞬间完成低损耗多芯直连,单次盲插插入损耗控制在0.35 dB以内。
在实际超大规模AI集群运维中,粉尘颗粒与光纤端面污染是诱发光链路误码率抖动乃至物理闪断的最主要根源。工程运维体系必须建立基于MPO-16/MPO-32的高可靠性抗污染防护与自动诊断机制。通过在交换机内部固件层集成光时域反射(OTDR)感知能力与激光器发光功率闭环监控遥测(Optical Power Telemetry),实时追踪各物理通道的接收光功率(RSSI)和激光偏置电流。一旦检测到光衰减异常劣化,控制平面即可提前预测链路失效并触发动态重路由,同时配合干式自清洁快拔防尘组件,最大限度提升万卡光互连集群的平均无故障时间(MTBF)。
选用支持微透镜扩束或精密导针定位的盲插MPO连接器,保障1000次插拔循环下插入损耗小于0.5 dB
在固件层集成实时光功率遥测与基于机器学习的链路退化预测算法,上报周期设定小于100 ms
制定严格的机房现场光端面清洁规范,要求安装前执行符合IEC 61300-3-35标准的双端面自动干涉检测