超大规模AI集群的三重约束:功率密度裂变、电网互联延迟与首Token交付加速
现代前沿大语言模型(LLM)与多模态AI训练集群的演进,已彻底颠覆了传统现场构建(Stick-built)数据中心在物理空间与交付时序上的工程假设。随着单算力封装的热设计功耗(TDP)突破1200W至1500W,机柜级密度呈现指数级跃升:从经典的10kW-20kW风冷机架,直接攀升至Nvidia GB300 NVL72乃至下一代Vera Rubin NVL72架构下的120kW至140kW+。在传统砖混土建模式下,此类超高密度部署面临土建施工周期长、劳动力紧缺、一次性土建过度冗余以及长达36至60个月的市政高压变电站互联排队周期。这种资本滞后与算力生命周期错配,导致数以亿美元计的GPU资本支出在等待基础设施落地的过程中面临断崖式折旧风险。
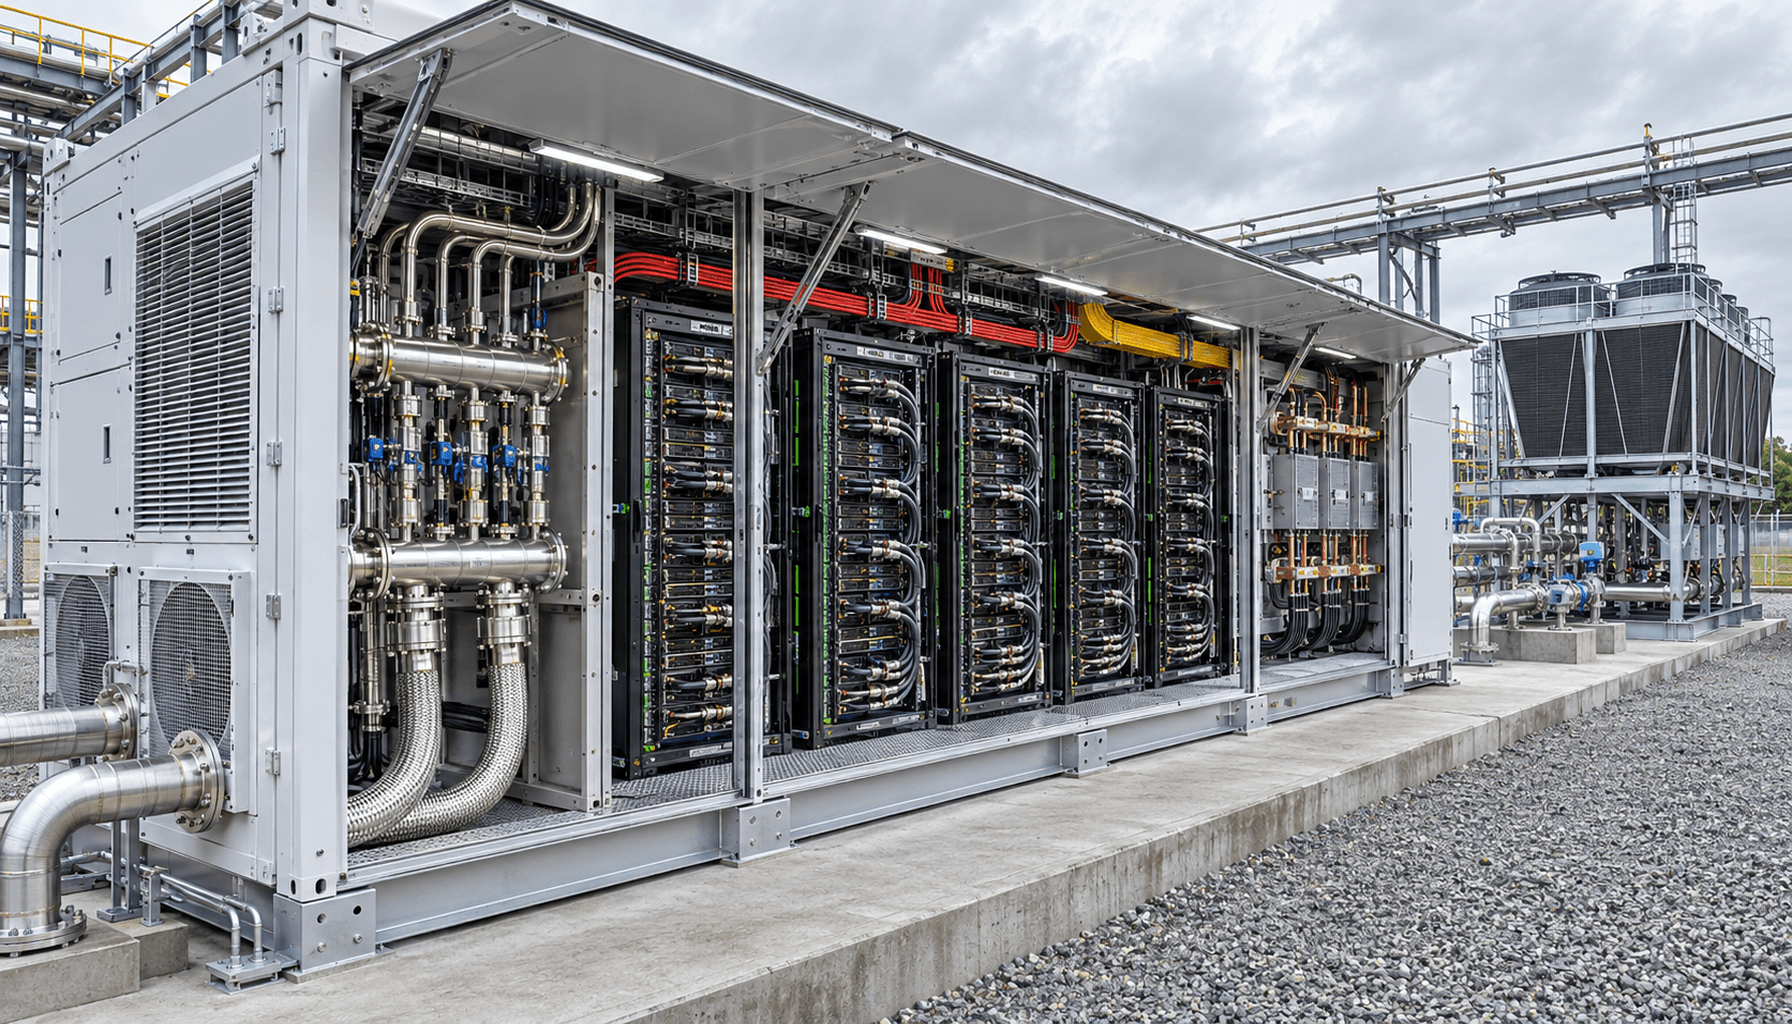
工厂预制模块化数据中心(Modular AI Data Center, MDC)在此背景下重构了算力基础设施的交付边界。通过将85%至90%的结构支撑、中低压配电、流体冷却分配单元(CDU)、消防抑制及自动化监控管线转移到受控的工业制造产线,构建以3.5MW为标准交付单元的独立算力模块。这些模块采用撬装(Skid-mounted)设计,在现场完成平整硬化垫层与预埋接口后,可实现即插即用部署,将“从场地准备到首Token产出(Time-to-Token)”的周期从传统的24-36个月骤降至几周或数月内。这种将大型工程项目转化为标准化工业硬件产品的工程转变,是解决电力约束与加速算力货币化的确定性技术路径。
验证单机柜物理承重指标是否满足NVL72满载规格(单机柜静态载荷≥2200kg)
核算现场混凝土承载垫层平面度公差(全域控制在±3mm以内)及抗震锚固剪切强度
审查工厂装配阶段机电一体化预制比例(标准化BOM统计确认预制率≥88%)
评估场地中压接入点至模块化母排快接端口的物理间距与走线弯折半径合规性
芯片级直接液冷(DLC)热力工程:双闭环微通道流体力学与零水耗极限散热
面对单颗计算裸片热流密度超100W/cm²的极端工况,传统强制对流风冷因空气比热容有限($C_p \approx 1.005\,\text{kJ/(kg\cdot K)}$)已遭遇热物理极限。3.5MW模块化单元全面采用中温闭环直接芯片液冷(Direct-to-Chip Liquid Cooling, DLC)拓扑。一次侧内部环路通过冷却液分配单元(CDU)将脱矿去离子水-丙二醇(PG25/Water)工质精确输送至覆盖GPU与CPU核心的微通道冷板(Micro-channel Cold Plates)。供水温度设定在45°C至55°C区间,依据流体传热方程 $Q = \dot{m} C_p \Delta T$,系统在维持流量 $\dot{m}$ 与热阻最优化平衡的同时,将芯片结温($T_j$)稳定控制在75°C安全红线以内,彻底消除了计算节流(Thermal Throttling)隐患。
在热量外排环节,系统通过不锈钢/钛合金板式换热器(PHE)将热负荷隔离转移至二次侧闭环绝热干冷器(Adiabatic Dry Coolers),构建全封闭双环路换热系统。该拓扑杜绝了蒸发冷却塔的连续水资源损耗(WUE趋近于0.00 L/kWh),消除了白烟羽流与军团菌滋生隐患。得益于一次侧出水温度高达60°C-65°C的品位优势,二次侧散热在环境干球温度高达45°C的极热干旱气候下仍具备足够的对数平均温差(LMTD)驱动自然散热,驱动整舱全年工况下的功率使用效率(PUE)稳固锁定在1.15以下,流体泵送能耗占比小于总输入功耗的2.8%。
测量一次侧与二次侧板式换热器在100%额定热负荷下的对数平均温差(LMTD ≤ 4.5K)
校验去离子水-丙二醇介质配比及电导率(要求电导率 ≤ 5.0 μS/cm,pH值控制在7.5-8.5)
检测CDU变频循环泵在不同流量设定点下的扬程-流量特性曲线及NPSHa净正吸入压头余量
验证极热干球工况下闭式干冷器风机阵列在满载PWM驱动下的能耗比与声功率级(≤78 dBA@10m)
电气配电拓扑:3.5MW功率块、380V HVDC与48V/54V高密度母排系统
3.5MW标准化功率块的电气链条设计聚焦于极致转换效率与占地面积最小化。模块入口配置紧凑型中压环网柜与干式变压器,将输入的13.8kV或34.5kV电网级电压就地降压。为规避低压交流大电流工况下的线缆集肤效应与极高的铜排热损($P_{loss} = I^2 R$),内部配电拓扑采用集中式整流系统,直接输出380V高压直流(HVDC)或±190V双极性直流母线,相较传统三相400V/480V交流双变换UPS系统,电能链条级联转换级数由四级精简至两级,电能传输转换效率达到97.5%以上。
在机架内部物理层,供电架构严格对齐开放计算项目(OCP)ORV3标准。380V HVDC经由机柜顶部集成的高效隔离型DC-DC降压转换汇流箱,将母线电压降至48V/54V,直接馈入镀银实心铜排垂直母线槽。单母排承载电流能力提升至3000A以上,直接向搭载NVLink全互联背板与计算托盘(Compute Trays)的盲插供电接口(Blind-mate Power Connectors)供电。此外,该电气舱预置了微电网双向变流接口(PCS),可无缝对接现场部署的天然气微燃机组、固体氧化物燃料电池(SOFC)或小型模块化核反应堆(SMR),在国家大电网审批迟滞期间,可率先消纳局域“滞留能源(Stranded Energy)”实现满功率离网试运行。
使用红外热成像检测380V HVDC至48V/54V直流母排在3.5MW满功率下的温升(最高温升 ≤ 30K)
测试ORV3机柜垂直铜排盲插触点在极限140kW脉冲负载扰动下的瞬态电压跌落(≤ 3.5%)
校核中压变压器与固态断路器(SSCB)的保护定值配合与超高速分断动作时间(≤ 2ms)
确认微电网接口与分布式能源控制器(DERC)之间的下垂控制响应延迟与无缝孤岛切并网逻辑
模块化舱体结构与英伟达DSX POD标准对齐:互联、密封与流体无损热插拔
舱体结构工程全面对齐英伟达DSX POD模块化部署规范,满足严苛的机械与流体公差约束。舱体外壳基于高强度耐候钢框架与轻量化绝热夹心板构建,具备NEMA 4X及IP66防护等级,满足严苛的抗震设防烈度(满足IEEE 693高等级要求)与阵风抗剪切能力。舱内空间划分为高热容液体冷却走廊与全封闭气流管理区,内部顶棚集成双层立体式管线阵列:下层部署低流阻不锈钢供回水二次侧分水主管(Dual-manifold Headers),上层装配低损耗MPO-16/MPO-32多模/单模光纤走线槽,严格实现强电、流体与光互联通道的物理空间三分立。
运维可达性采用全前/后维护(All-Front/Rear Service)几何布局,彻底取消冷热通道翻折门结构。每个计算节点采用标准盲插式无滴漏快换接头(Blind-mate Quick Disconnect, QD),符合严格的ISO 16028标准,允许操作人员在不断电、不泄压工况下进行计算托盘热拔插。舱体流体主管底部全长铺设双冗余离子感应式漏液感测绳,配合基于压力降导数($dP/dt$)的边缘智能算法,一旦检测到纳升/秒级的微漏事件,分布式气动球阀可在15毫秒内完成故障机架管段的隔离,将局部水击效应与介质喷溅风险降至绝对零。
通过氦质谱检漏仪对所有机柜分水歧管快换接口执行真空反压检漏(泄漏率 ≤ 1×10⁻⁷ mbar·L/s)
测量计算托盘盲插导向销在三维方向的几何对准公差(X/Y轴偏差 ≤ ±0.75mm)
触发漏液传感绳模拟报警,验证气动隔离电磁阀切断响应时间(动作延时 ≤ 15ms)
验证机舱内正压维持系统在外部粉尘环境下的压差梯度保持能力(内部维持相对于大气压 ≥ 20Pa)
全生命周期TCO模型、资本支出优化与分布式主权AI边缘经济学
将3.5MW算力单元工厂化预制带来的核心经济学收益,在于从根本上重构了AI基础设施的资金流动模型。传统超大规模(Hyperscale)数据中心往往采用单体数百兆瓦的一次性规划,迫使运营方在首日投入数十亿美元的非弹性沉没资本,然而首批算力交付通常被拖延至3年以上。相比之下,模块化架构支持精准匹配GPU采购节奏与电力消纳进度的“即时(Just-in-Time)资本开支”策略。运营商能够以3.5MW(单体可支撑约24-28个140kW机架)为最小资本颗粒度进行滚动投资,将初始资本沉没风险削减60%以上,并将单瓦全周期建设成本压缩15%-25%。
这一架构同时赋能了“主权AI(Sovereign AI)”与分布式推理超级边缘(Super-Edge)的大规模部署。在面临地缘合规、数据本地化主权法案及长途光纤回传网络延迟瓶颈时,3.5MW模块化单元可直接投运于国家级边缘节点、近海油气平台伴生气发电机旁或工业机器人聚集地。通过将电力基础设施转化为高度标准化的集装箱级资产,企业不仅能提前24个月捕获市场上的未满足推理需求、兑现高额算力租金,还能赋予数据中心物理资产在不同国家电网节点之间吊装迁移的极高流动性。
建立折现现金流(DCF)模型,对比分析预制模式与传统土建模式的净现值(NPV)与内部收益率(IRR)
核算3.5MW单元在不同电价场景($0.04/kWh至$0.12/kWh)下的度电折算总运营成本(Levelized TCO)
审查模块运输边界条件,确保尺寸与轴载符合美国DOT及欧洲跨国超限特种运输公路标准
评估主权合规性审计中关于物理防侵入、电磁屏蔽(EMC/Tempest)及离线密钥托管模块的软硬件边界
出厂验收测试(FAT)、全负荷热假负载验证与现场快速并网规程
模块化AI数据中心高可靠性的底层基石在于极致严谨的工厂验收测试(Factory Acceptance Testing, FAT)。在设备发运出厂前,模块需在受控测试基地进入全要素热舱测试台。工程师团队接入专用的3.5MW可编程阻性/感性流体热假负载机架,模拟真实GPU在0%到100%全负荷突加、突卸(Step-load)过程中的瞬态热脉冲。系统在此期间执行耐压强度测试:以1.5倍公称工作压力(通常为10至12 bar)注入荧光示踪流体持续保压48小时,监测压力衰减率,确保在极值热胀冷缩工况下无微裂纹与密封失效。
现场连接流程(Field Hookup Protocol)被严格约束为工序高度固化的机械与电气卡接。现场工作仅包含三个物理界面的耦合:中压/低压母线法兰软连、进出水二级循环管网大通径维卡(Victaulic)卡箍压接、以及全舱MPO主干光缆快速配线架打线。所有传感器节点预先映射入模块内置的边缘控制器,通过Redfish及RESTful API直接向中心DCIM上报冷量需求、各机架热熵平衡及电能质量遥测数据。从底盘落位于垫层到完成全系统冷热态自检并网,标准施工工时被压缩在120小时以内,实现了真正工业化流水线式的算力极速点亮。
执行工厂全负荷3.5MW假负载带载热平衡测试,记录冷板进出口温差与泵组扬程变化率
完成水压试验(1.5倍额定工作压力下稳压4小时,压降要求 ≤ 0.05 bar)与全管路氮气吹扫
验证现场大通径快速管箍联结处的扭矩校核(严格按照规范打上防松标线)
通过自动化脚本触发基于Redfish协议的带外管理(OOB)与遥测系统端到端连通性测试(时延 ≤ 50ms)