1. 102.4Tbps网络时代的SerDes信道损耗与可插拔光学功耗墙
随着前沿万亿参数大语言模型(LLM)分布式训练向数万卡GPU集群扩展,网络互联带宽正在向单芯片102.4Tbps聚合吞吐演进。传统基于前端面板的可插拔光模块(如QSFP-DD与OSFP 800G/1.6T)在此代际遭遇了不可逾越的物理限制。核心问题源于高频电信号在PCB介质上的信道衰减物理规律:当单通道SerDes速率演进至106 Gbps PAM4乃至212 Gbps PAM4(奈奎斯特频率超过53 GHz)时,即便采用Megtron 7或Megtron 8等顶级极低损耗介质基板,信号在经过10至14英寸(254mm至355mm)的主板走线、过孔以及前端物理连接器时,插入损耗也会突破28至32 dB,迫使交换机ASIC和光模块内置DSP必须运行极为复杂的判决反馈均衡(DFE)与连续时间线性均衡(CTLE),带来了毁灭性的抖动裕量损耗。
除了信号完整性恶化,能耗与热密度构成了更严峻的物理墙。采用重定时DSP(Retimer DSP)的传统光模块单比特能耗居高不下,维持在18至22 pJ/bit水平。在一个典型的102.4Tbps交换机机箱内,仅光模块总功耗就高达3500W至4500W,占整机系统总能耗的35%至45%。更致命的是,前端面板仅有1U或2U的物理进风截面,在如此狭窄的区域聚集了超过64个高发热模块,局部热流密度往往突破15 W/cm²。常规40mm或60mm高转速反转风扇在声学极限(>85 dBA)与风阻阻抗下已无法建立有效热边界层,导致模块激光器结温急剧飙升,进而引发雪崩式的光功率骤降与误码率劣变。
验证主板走线在高频奈奎斯特频率(53 GHz)下的插入损耗不超过30 dB,必须在全链路部署S参数时域反射仿真(TDR)
单机架前端面板热预算严格限定在3000W以内,风冷系统进风温差需控制在ΔT ≤ 15°C以内
前置DSP热插拔模块的单端口功耗必须在量产验收测试中实测验证(800G ≤ 16W,1.6T ≤ 28W)
2. CPO硅光引擎架构与超短距直驱(<7 pJ/bit)物理层设计
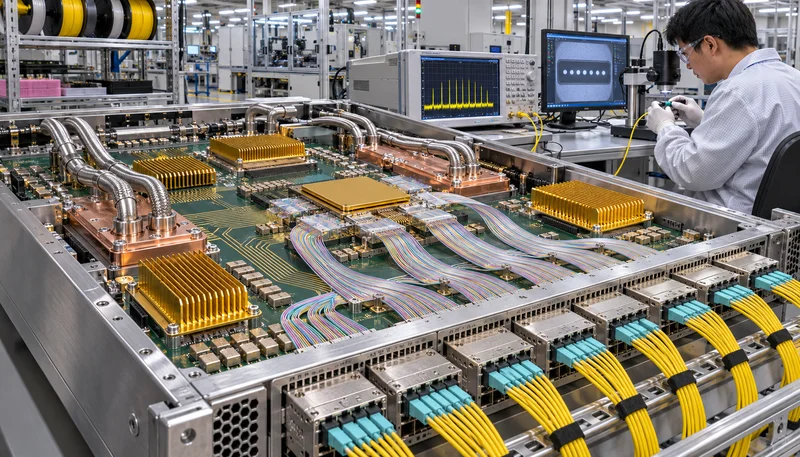
共封装光学(CPO)技术通过颠覆性的异构集成拓扑从根源打破了功耗墙。在禾风起 / RICEWIND推荐的高性能CPO架构中,3.2T硅光互连引擎(Optical Engine, OE)被直接搬移至交换ASIC相同的高密度有机多芯片模块(MCM)基板或无源硅中介层(Silicon Interposer)上。此举将ASIC SerDes与光调制器驱动器(Driver)之间的电气走线长度从传统的300mm几何级缩短至15mm至25mm。极短的传输距离使信道插入损耗在53 GHz下被骤降至2.5至4 dB以内,从而完全省去了高功耗的重定时DSP芯片,步入纯线性直驱(Linear Direct-Drive)范式。
在架构层面,3.2T光引擎集成了硅基马赫-曾德尔调制器(MZM)或超低驱动摆幅的硅微环调制器(MRM),配合单片集成的低功耗互阻抗放大器(TIA)与驱动芯片(Driver IC),将整个交换机互连层面的单比特传输能耗压缩至5至7 pJ/bit区间,相比传统可插拔光学实现了65%至75%的断崖式能耗下降。光信号的导出采用高密度2.5D/3D异构耦合方案:在硅光芯片边缘采用低损耗悬臂梁模场转换器(Spot Size Converter, SSC)或亚微米超表面光栅耦合器,通过折射率匹配胶与单模光纤阵列(Fiber Array)实现端面被动对准,单通道耦合损耗控制在1.0 dB以内,最终汇聚成单侧柔性光纤带引出至盲插光连接器。
ASIC至3.2T光引擎的Die-to-Die超短距电通道插入损耗控制在≤ 3.5 dB @ 26.56 GHz / ≤ 5.0 dB @ 53.125 GHz
光学引擎发射端与接收端系统整机总能耗必须经过严格功率计量监控,目标达成全负荷运行 ≤ 6.5 pJ/bit
硅光芯片端面SSC模场转换器与保偏光纤阵列耦合插入损耗在1310nm波段实测均值必须 ≤ 1.2 dB
3. ELSFP外置激光源:磷化铟(InP)热可靠性与热插拔激光安全
将传统激光二极管直接固化在CPO交换ASIC MCM基板上的方案存在严重的物理缺陷。磷化铟(InP)分布式反馈(DFB)连续波(CW)激光器对结温极其敏感:当工作环境温度从50°C升高至85°C时,InP材料的俄歇复合(Auger recombination)效应加剧,激光器阈值电流将成倍上升,斜率效率(Slope Efficiency)暴跌40%以上,更会导致其平均故障间隔时间(MTBF)呈指数级萎缩,缩短至设计寿命的十分之一以下。然而,102.4Tbps交换ASIC满载运行时的核心结温普遍处于85°C至105°C之间,若将激光二极管置于同一基板,将直接导致不可接受的现场失效率。
为彻底解耦热应力,本规范全面采用OIF标准化的ELSFP(External Laser Small Form-Factor Pluggable)外置激光架构。将大功率连续波激光源(输出光功率通常为+20 dBm至+24 dBm)从高热ASIC区域隔离,封装进安装于交换机冷区前端面板或独立盲插激光托架的ELSFP模块中。激光通过保偏光纤(PMF)排线注入至CPO光引擎内部的调制器中。由于激光模块工作温度被锁定在35°C至50°C黄金区间,激光器MTBF可保证在1000万小时以上。此外,ELSFP支持在线热插拔,激光器老化或失效时运维人员可在数秒内完成无感更换,结合硬件级自动激光关断(ALS)与微秒级眼部安全互锁(Class 1M Eye Safety Interlock),彻底根除了激光直接辐射风险。
ELSFP激光源冷板运行温度必须严格被限制在 ≤ 50°C,环境进风温差监控偏差不得超过 ± 2°C
保偏光纤(PMF)链路全长偏振消光比(PER)在系统满负荷振动测试下必须保持 ≥ 20 dB
ELSFP光模块微动开关必须联动硬件ALS逻辑,光纤断开或模块拔出时必须在100微秒内关断输出功率至安全阈值(< -10 dBm)
4. 高基数光纤管理、链路插损预算与APC MPO清洁度工程
高基数102.4Tbps系统面临前所未有的物理层光纤密度挑战:单台交换机若采用单通道100G架构,需引出高达1024根单模光纤;即便采用双波长CWDM或DR4架构,进出封装基板的光纤线缆也达到512根以上。在机箱紧凑空间内,必须设计多层精密防微弯应力释放布线桥架,采用具备超强耐弯折性能的G.657.B3级低弯曲损耗单模光纤与保偏光纤带,确保光纤弯曲半径在缩小至5mm时,因宏弯引起的附加损耗仍低于0.05 dB。内部接口采用MT-Ferrule高密度盲插背板(Blind-Mate Optical Backplane),将机箱内光束规范导出至前面板。
在链路功率预算方面,2026年AI超算集群对光损耗的容忍度极低,1310nm DR4链路总通道预算通常仅有6.5至8.5 dB。系统内部引入的ELSFP 1:4/1:8保偏分束器、前端盲插连接器、内部MT插芯以及硅光芯片耦合端面将消耗4.0至5.0 dB的预算。因此,光互连端面必须全量采用8度斜角物理接触(APC)研磨工艺,确保反射回波损耗(Return Loss)优于-55 dB,以扼制反射光对大功率DFB激光器引发的光谱线宽展宽和相对强度噪声(RIN)恶化。同时,在CPO封装产线与现场必须执行严格的IEC 61300-3-35标准端面自动化清洗与干涉仪形貌质检,严防亚微米级微尘诱发高光强热烧结损伤。
机箱内部光纤带在5mm最小弯曲半径极限下,1310nm与1550nm全波段光损耗增量必须 ≤ 0.05 dB
所有盲插光连接器端面回波损耗经高精度OTDR验证必须满足 RL ≥ 55 dB(APC 8°标准)
严格遵循IEC 61300-3-35 Class A标准,光纤纤芯区域(0-25μm)在自动干涉检测中必须实现0缺陷、0划痕、0污染物
5. 异构基板非均匀热流与双温区液冷冷板协同散热设计
CPO模块的封装级热协同设计堪称当前电子封装物理学中最复杂的挑战之一。中央交换ASIC的功耗在102.4T级别普遍达800W至1200W,局部核心计算单元热流密度峰值高达120至150 W/cm²,其允许的最高工作结温为85°C至105°C;而在同一MCM基板边缘,分布着16个或32个3.2T硅光互连引擎,每个引擎功耗为15W至25W,热流密度约为30至40 W/cm²,但其对温度变化极其敏感——硅微环调制器(MRM)的谐振波长温漂系数通常为0.1 nm/°C,为避免热调微加热器(Thermal Tuner)超负荷工作,必须将光引擎结温严苛限定在60°C以下。
传统的单一大面积均热板液冷方案无法应对此类巨大的温度梯度错配,极易导致热量从高温ASIC倒灌至敏感的光引擎。禾风起 / RICEWIND工程体系提出了双温区隔离液冷冷板(Dual-Zone Liquid Cold Plate)方案:采用微通道流道解耦设计,冷却工质(采用丙二醇水溶液PG25或全绝缘介质流体)以逆向梯级方式流动,高流速低温流体(进液温度35°C)首先流经外围光引擎区域,将其温度死死钳制在55°C以内;随后汇入内层中央ASIC高密度微翅片区,允许ASIC在高效相变或单相换热下平稳维持在75°C至80°C。同时,基板采用热膨胀系数匹配的低热阻石墨烯增强型界面导热材料(TIM2),法向热阻抗小于0.08 K·cm²/W,确保异构热应力不引起任何微米级光学光栅位移。
双温区液冷冷板在进液温度35°C、额定流量(≥ 2.5 L/min)工况下,必须确保所有3.2T光学引擎结温 ≤ 58°C
中央交换ASIC微通道热阻(Rth_jc)需控制在 ≤ 0.035 K/W,满载工况下ASIC最高热点结温 ≤ 80°C
MCM异构基板在-40°C至+125°C温度循环测试(TC-1000次)中,光引擎与纤芯位移量不得超过 ± 0.3μm
6. AI智算集群TCO经济学、演进路线与自动化运维验证体系
从总体拥有成本(TCO)与技术演进视角审视,网络架构正经历从传统插拔光(Pluggable)、线性可插拔光(LPO)向CPO的必然演进。在800G与部分1.6T组网场景中,LPO与高性能插拔模块仍因其存量生态兼容性而占据一席之地;但进入单端口3.2T及整机102.4Tbps与204.8Tbps时代后,传统电接口通道损耗将彻底逼近物理上限,CPO成为超算集群规模化扩展的唯一确定性物理通道。尽管当前CPO交换机的首制资本支出(CapEx)因光电共封装微组装良率而在单机硬件上存在15%至20%的溢价,但在超算集群生命周期运营支出(OpEx)模型中展现出压倒性优势。
以万卡H100/B200级别集群交换矩阵计算,采用CPO技术带来的60%互联功耗降幅,可直接使单个机柜功耗节约超8千瓦,一个典型集群排组(Row)年节电数十万度,更直接将数据中心机房PUE从1.25压缩至1.10以下。节约的电网变压器容量可直接转化为额外的AI加速卡计算节点,带来显著的算力产出收益。在规模运维部署层面,工程规范强制要求在管理平面集成分布式光时域反射仪(OTDR)与数字诊断监控(DDM),实现微秒级断纤定位;物理层严格以前向纠错前误码率(Pre-FEC BER)低于1×10⁻⁴作为退化告警阈值,并建立ELSFP光功率自适应调节闭环,构筑全生命周期免人工干预的韧性网络底座。
在万卡集群建设方案中输出完整的全周期TCO经济学模型,证明CPO在部署第14个月内通过节能收益实现CapEx溢价打平
整机控制平面必须集成嵌入式OTDR实时监测固件,光纤断纤与宏弯故障判定定位精度需达成 ≤ 0.5米
集群链路验收指标必须全量满足Pre-FEC BER ≤ 1.0×10⁻⁴,且在72小时满载压力测试期间不可出现任何不可纠正FEC帧(Zero Uncorrectable FEC Blocks)