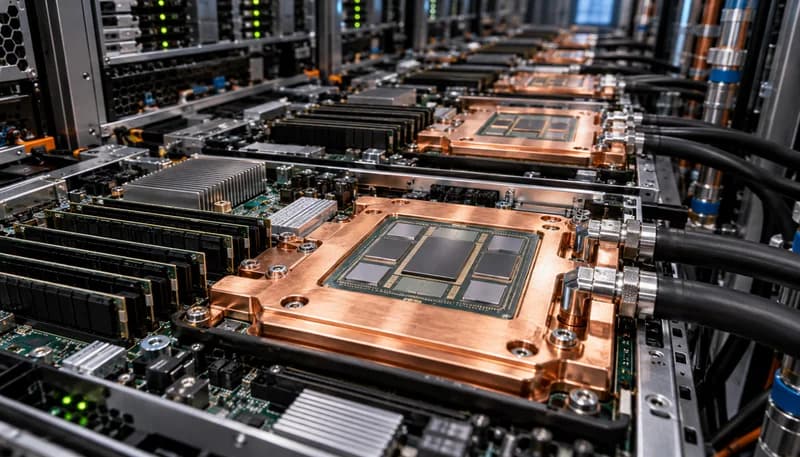
单片光罩极限与物理经济瓶颈:驱动2.5D/3D芯粒解耦的工程动因
半导体制造在深亚微米及先进制程节点下正面临严苛的物理与几何极限。传统单片(Monolithic)服务器处理器长期受制于光刻机的单曝光视场极限(即光罩极限,Reticle Limit,通常约为858 mm²)。随着现代大语言模型(LLM)训练与高密度云计算多租户负载对片上晶体管总量的爆发式需求,强行在单一硅片上整合全部计算核心、二级/三级缓存、内存控制器及高速PCIe/CXL SerDes接口,将导致芯片裸片面积直逼物理天花板。根据墨菲良率模型(Murphy's Yield Model)与负二项分布规律,晶圆缺陷率随裸片面积增大呈指数级恶化,使得光罩极限附近的超大芯片晶圆制造良率暴跌至经济不可承受的临界线以下。
芯粒(Chiplet)范式通过空间拓扑解耦彻底颠覆了传统设计哲学。通过将超大规模单片处理器分解为多个专用模块化裸片——包括计算核心粒(Compute Corelets)、I/O接口粒(IOD)以及高带宽内存(HBM)切片,系统设计师能够针对不同功能单元匹配最优制造节点。例如,对晶体管密度敏感的计算核心可采用3nm先进FinFET或GAAFET制程,而对于模拟特性占主导、尺度缩放收益极低的I/O与物理层接口则沿用7nm或12nm成熟工艺。这种异构集成不仅使硅片综合缺陷率显著降低、晶圆净良率提升40%以上,更赋能超大规模云服务商(CSP)基于通用互连底板敏捷拼装针对特定工作负载的定制化ASIC芯片,大幅压缩研发与量产交付周期。
打破光罩极限约束:单硅片面积严格受限在约858 mm²内,超大芯片良率通常衰减至30%以下
工艺节点异构匹配:前沿3nm计算核心与7nm/12nm成熟I/O模块实现同封装混构,晶圆成本降低35%-50%
单插槽物理算力跃升:利用2.5D/3D先进基底支持单插槽集成128至256+个物理计算核心与多路HBM3e
Die-to-Die互连架构:UCIe规范、超低时延与硅中介层布线
芯粒解耦成功的物理基石在于裸片间(Die-to-Die, D2D)高密度物理互连技术。传统片上总线演变为跨裸片网络,必须依托硅中介层(Silicon Interposer,如台积电CoWoS)、硅桥接嵌入(如英特尔EMIB)或高密度扇出封装(InFO)等先进封装介质。这些工艺利用亚微米级布线技术(线宽与线距L/S ≤ 0.8 μm/0.8 μm)以及微凸块(Micro-bumps,节距<25-55 μm)或直接铜-铜混合键合(Cu-Cu Hybrid Bonding,节距<10 μm),构建起媲美单片内部金属互连层的走线密度,避免了传统封装引脚所带来的高寄生电容与电感瓶颈。
为打破私有专有互连协议的生态壁垒,通用芯粒互连标准(UCIe, Universal Chiplet Interconnect Express)已成为行业事实标准。UCIe规范定义了严格的物理层(PHY)、D2D适配层以及支持PCIe 6.0/CXL 3.0与原始流式传输的协议层栈架构。在物理电气表现上,先进封装模式下的UCIe可实现单通道最高32 Gbps的信号传输速率,提供高达1.3 Tbps/mm甚至更高的数据岸边带宽密度(Shoreline Bandwidth Density)。尤为关键的是,得益于超短互连走线损耗(< -3 dB),封装内D2D通信能耗被压缩至0.5 pJ/bit以下,传输物理时延控制在2纳秒以内,从而彻底规避了分布式多NUMA节点带来的通信阻滞与片上网络(NoC)拓扑膨胀开销。
高频高密电气指标:UCIe 32 Gbps/lane速率下实现数据线岸边带宽密度>1.3 Tbps/mm
超低功耗时延预算:Die-to-Die端到端物理能耗控制在<0.5 pJ/bit,互连延迟抑制在<2 ns
先进封装布线约束:硅中介层线宽/线距严格收敛于0.8/0.8 μm至2/2 μm,微凸块间距压缩至<40 μm
亚伏特级核心电压调节:应对极高di/dt瞬态的48V-PoL与集成稳压器IVR工程方案
芯粒高度集成的计算核心对板级供电网络(Power Delivery Network, PDN)提出了近乎严苛的电磁与电路动态响应挑战。现代先进逻辑工艺的核心电压(Vcore)已下探至0.75V甚至0.65V区间,而单插槽在全负载下的电流需求却激增至1000A至1500A以上。在深度学习大模型突发激活或动态电压频率调整(DVFS)瞬态切换工况下,计算集群电流瞬态变化率(di/dt)可骤然超越1500 A/μs至3000 A/μs。由于电压跌落与杂散电感遵循ΔV = L × (di/dt),传统放置在CPU插座外围的12V多相降压转换器(VRM)因插座接触电阻、PCB走线电感及过孔寄生电感(数纳亨级),会产生灾难性的IR压降与地弹(Ground Bounce),导致逻辑电路时序崩溃。
解决该物理死局的核心在于重构从机架到硅片的配电拓扑。服务器主板全面弃用传统12V供电,转向48V/54V直流总线直接引入架构,使主板输送电流降低至原先的1/4,铜损(I²R)缩减至1/16。在芯片端,采用紧凑型多相垂直供电技术(Vertical Power Delivery, VPD)或两级混合拓扑:48V经由板载高效转换模块下变频至中间电压,最后通过置于封装内部或硅片正下方的集成稳压器(IVR)直接向Vcore供电。配合晶圆级深槽电容(Deep Trench Capacitor, DTC)以及背部供电网络(BSPDN),将整个供电回路寄生电感压制在皮亨(pH)量级,保证核心电压在极高动态负载跳变时的波动范围严格约束在标称值的±3%(<25 mV)以内。
动态瞬态负载容差:在di/dt > 1500 A/μs激增条件下,0.75V Vcore供电纹波瞬态偏移严格限制在±25 mV以内
垂直配电寄生最小化:采用垂直供电网络(VPD)与片上DTC,将PDN回路寄生电感消除至<50 pH
两级电源拓扑能效:48V至负载点(PoL/IVR)全链路综合转换效率在额定工况下达到≥94%
微观热通量挑战:芯片直接微通道冷板、均热板TIM与热界面退化治理
芯粒异构堆叠与高密核心布局引发了灾难性的热流集中效应。尽管整片封装的平均功耗可能为500W-1000W,但不同芯粒间的功耗密度呈现极度空间不均匀性:高强度张量运算单元所在的先进制程计算Die局域热通量常常超越100 W/cm²甚至200 W/cm²,而临近的I/O Die与基底温度则相对较低。这种微观局部热点(Microscopic Hotspots)导致巨大的热应力梯度,不仅将半导体PN结温推向失效临界线(通常需严格压制在Tj ≤ 85°C),更使依靠自然扩散热阻与空气强迫对流的传统热管风冷散热器彻底失效,直接微通道液体冷却成为唯一可行的热力学解法。
芯片直接液冷(Direct-to-Chip, D2C)微通道冷板(MCP)的设计已深入到微米级流体力学范畴。冷板通常采用高导热无氧铜制造,内部加工有微细翅片阵列(翅片宽度50-100 μm,深宽比>10:1),配合定向射流冲击(Jet Impingement)歧路设计,确保低温冷却液以高速紊流状态直接冲击高热流计算Die上方,将局部对流换热系数推升至数万W/(m²·K)。此外,芯粒封装大尺寸表面热膨胀系数(CTE)失配,导致传统导热硅脂在剧烈热循环下极易发生“泵出效应”(Pump-out)与干涸老化,热阻随时间急剧漂移。工程实践中必须强制引入金刚石复合材料、共晶铟(In)金属片或原位固化的液态金属(GaIn合金)TIM1/TIM2界面材料,将接触热阻持久锚定在<0.05 K·cm²/W的严苛水准。
局域热通量移除指标:冷板系统具备安全耗散>100-200 W/cm²热点能力,维持最高结温Tj ≤ 85°C
微通道水力动力学设计:微通道冷板流阻压降严格限制在30-70 kPa,翅片深宽比维持>10:1
长寿命热界面材料阻抗:全面采用抗泵出液态金属或烧结铟片,端到端TIM热阻维持在<0.05 K·cm²/W
服务器平台与机架级高密化:配电母排、54V电源机框及ORV3机械物理约束
芯粒算力集群将2U机箱内的节点功耗推向2kW至4kW量级,促使整机柜功率密度呈现对数级跳变。传统12V铜排在单机柜数十千瓦工况下需承载数千安培电流,母排发热损耗及连接器体积已完全突破物理空间限值。遵循开放计算项目(OCP)Open Rack V3(ORV3)架构规范,数据中心全面普及54V集中式母排(Busbar)供电架构。机架背部采用单根高导电率铜制母线槽贯穿整个机柜高度,通过盲插浮动盲配端子向每个计算IT节点直接供给54V直流电,不仅消除了单节点内部各自配备交流电源供应器(PSU)的容积浪费,更将供电链路铜损压减超过90%。
高密机架化带来的机械与空间物理冲突高度集中在电源机框(Power Shelf)与液冷分配管网的重叠区域。ORV3标准下,集中式电源机框通常由多组钛金级(Titanium-grade,能效≥96.5%)3kW/5.5kW AC-DC整流模块构成,以N+N或N+2并行冗余架构提供高达33kW甚至66kW的集中电力输送。与此同时,由于液冷进出水不锈钢分流主管(Manifold)、软管回路及盲插无滴漏快速断开接头(QDD)占据了机架后部宝贵的布线走廊,服务器底板结构刚性面临极大考验。单机架满载湿重突破1500 kg,机架机械结构必须在承受严苛抗震等级的同时,抵御流体QDD盲插侧向公差偏移所引发的剪切破坏风险。
ORV3配电与母排损耗:54V背板母排主回路电压降控制在<1.5%,PSU系统转换效率达到≥96.5%
承重与机械力学规范:单机架动载荷承载能力提升至1400-1800 kg,以支撑重型节点与充液管网
流体快速断开冗余度:QDD接头耐受不低于500次加压盲插操作,达到零微滴漏(100%无渗漏)安全级
超大规模设施架构演进:存量数据中心白区向60kW-120kW+液冷芯粒机架迁移
芯粒技术的普及正驱动超大规模(Hyperscale)数据中心白区(White Space)物理设施发生底层质变。过去按单机架5kW-15kW热密度规划的存量(Brownfield)机房,正迅速被由芯粒服务器构建的单机柜60kW至120kW+高密液冷机架挤占。在此类极端功率密度下,空气动力学冷却已彻底丧失对流载热能力。设施工程团队必须将机房底层架构重构为液液热交换拓扑:在白区端部署行内或框架式冷却分配单元(CDU),通过高效板式换热器将机房一次侧设施水回路(FWS)与直接穿梭于服务器微通道冷板的二次侧技术冷却回路(TCS)进行全物理隔离。
在热工水力学控制层面,芯粒液冷系统极大地放宽了进水温度窗口,加速推动设施拥抱ASHRAE W4类温水冷却规范(即冷板进水温度允许高达32°C至45°C)。这一跨越具有里程碑式的工程意义:在绝大多数地理气候带,数据中心可常年100%依靠室外干冷器(Dry Cooler)或间接蒸发冷却塔完成纯自然冷却(Free Cooling),彻底剔除传统冷水机组(Chiller)中高耗能的压缩机热力循环。通过将二次侧供回水温差(ΔT)控制在8°C至12°C之间,机柜级换热效率达到质的飞跃,超大规模计算集群全年的综合电能使用效率(PUE)被坚决锁定在1.15乃至1.08的极限区间,真正实现微观硅片架构革新与宏观绿色基础设施工程效益的闭环协同。
高密机架热力学支撑:CDU单机换热能力达800-1500 kW,全面支持单机架60 kW至120 kW+纯液冷负荷
ASHRAE W4温水运行:实现冷板进水温度32°C-45°C连续运行,全年无压缩机完全自然冷却,PUE < 1.15
存量机房土建改造底线:白区抗震高架地板载荷提升至≥18-25 kN/m²,单回路二次侧温差保持ΔT=8-12°C