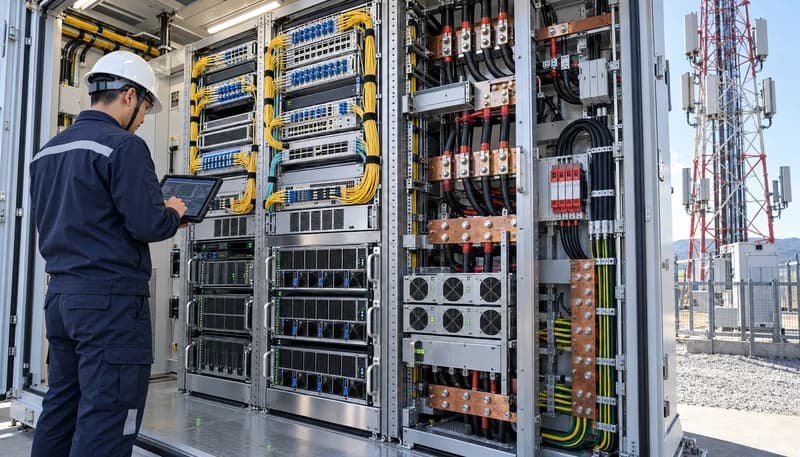
1. AI-RAN架构范式演进:固定功能ASIC与GPU驱动L1物理层计算的架构分化
传统蜂窝无线接入网(RAN)的基带处理单元(BBU)长期依赖高能效比的固定功能ASIC(例如定制化DSP及SoC芯片)执行5G NR第三代合作伙伴计划(3GPP)定义的物理层(Layer 1 PHY)高实时性信道流水线。此类ASIC针对低密度奇偶校验码(LDPC)译码、极化码(Polar Code)处理、快速傅里叶变换(FFT/iFFT)以及固定维度的MIMO信道估计进行了硬连线优化,具备极低的处理时延(通常在数十微秒量级)和高度线性的静态热设计功耗(TDP)。然而,这种高度固化的硅片逻辑在应对多天线波束赋形权值实时协同、动态信道自适应补偿以及通感算一体化(ISAC)等复杂场景时暴露出算法演进瓶颈,无法支持基于深度学习的端到端神经接收机(Neural Receiver)快速重构。
英伟达与诺基亚推动的AI-RAN架构彻底打破了专用硬件的桎梏,采用通用且高度可编程的GPU流多处理器(SM)架构承载cuPHY等全功能软件定义L1处理栈,同时将闲置计算周期动态时分复用给边缘AI推理工作负载。这种计算架构的根本性转移引入了极其苛刻的时延确定性挑战:在sub-millisecond(亚毫秒级)传输时间间隔(TTI,典型取值0.5ms甚至0.125ms时隙)的严苛物理层边界下,GPU必须借助统一内存架构(UMA)与旁路内核驱动(GPUDirect RDMA),消除PCIe总线与电信硬件抽象层(HAL)间的数据拷贝开销,以满足确定性帧调度并维持电信级99.999%的站点可用性指标。
基带流水线确定性约束:确保GPU内核调度时延抖动窗口硬性锁定在单时隙预算的15%以内(0.5ms TTI场景下低于75μs),避免HARQ重传超时引发无线链路失步
算力密度与功耗包络评估:单计算节点TDP由传统ASIC架构的80W-150W跳变至300W-700W,单机柜需按300%原规划计算负荷重新核算总线承载力
动态算力时分复用合规:部署电信硬实时隔离调度器,强制赋予L1 PHY高频通信线程绝对非抢占优先级,次级AI推理任务限制在剩余张量核心内运行
2. 宏基站电力预算扩张:-48V DC整流系统扩容与高密度配电铜排选型
在传统宏基站机房与户外一体化机柜的配电架构中,单机柜的直流供电预算通常被收敛在1.5kW至3.0kW区间内,主要服务于低功耗数字基带板与射频下拉直流转换模块。AI-RAN计算刀片的引入直接将单柜功耗推高至4.5kW至8.0kW甚至更高。为匹配此负载跃迁,基站一次电源系统必须实施结构性重构。现网原本配置的100A-150A直流整流机框必须整建制平滑替换为200A至400A高密度整流机框,其单模块整流功率需提升至3000W至6000W规格,并在全载及40%至80%的典型通信负载区间内提供大于96%(优选98%)的峰值电能转换效率,以抑制整流自身散发的废热堆积。
配电链路的物理载流瓶颈主要集中在直流母排与一次下电(LLVD)分路分配环节。电信级标称-48V DC系统在实际运行时采用53.5V至54.0V的连续浮充电压工作基准,并需兼容56.4V的均充工况。当高负载GPU节点在满载工作模式下吸入超过150A的单路直流工作电流时,既有的配电配线与母排截面积极易引发不可接受的欧姆压降。工程规范要求从整流机框输出端子至最远端GPU计算刀片DC输入端口的回路压降严禁超过0.5V。为此,主直流汇流排必须选用导电率不低于58 MS/m的T2高纯度无氧铜排,截面积需按照不小于2.0A/mm²的保守电流密度进行降额重构,并配套升级为150A至400A框架式直流断路器以消除热积聚隐患。
整流机架冗余与容量基准:按N+1或N+2冗余架构配置3000W-6000W超高效整流模块,确保在单模块故障状态下系统仍可向后级提供大于53.5V稳定浮充供电
直流压降与线损物理校核:依据最大瞬时负载严密验算供电电缆,保持全回路端到端阻抗低于2.5mΩ,严禁单点压降在额定电流下超出500mV设计红线
配电断路器热脱扣标定:选用针对持续高温与非线性直流电感负载优化的150A-400A直流断路器,其额定分断能力在-48V DC下必须达到或超过10kAIC
3. 动态瞬态与微中断缓冲:高倍率磷酸铁锂(LiFePO4)电池与超级电容储能协同
AI-RAN负载与传统恒定速率通信负载的本质差异在于其极端动态的功率包络。在Massive MIMO波束赋形高密度突发调度、多用户并发调度(MU-MIMO)及深度学习推理激增的瞬态交织下,GPU功耗可在数微秒内产生高达数百安培的阶跃响应(di/dt)。这种剧烈的瞬态电流阶跃对供电回路构成严峻考验,极易在直流母线上激发高频电感反冲和瞬态电压跌落。若直流母线电压瞬间瞬态跌落至43.2V低压脱扣保护(LVD)阈值以下,将直接诱发系统雪崩式断电,导致长达数分钟的基站硬重启并摧毁电信级网络可用性。
传统大容量铅酸蓄电池(VRLA)因内阻偏大(通常处于毫欧高段)且电化学电荷转移速率受限,完全无法吞吐此类陡峭的电流突变。现代宏站改造必须强制采用具备高倍率连续放电能力(不低于3C至5C连续放电,10C瞬态脉冲承载)的磷酸铁锂(LiFePO4)高能量密度电池组,并深度集成带纳秒级固态旁路的分立式电池管理系统(BMS)。在电力系统前级,应并联部署毫法(mF)级高压低ESR混合型超级电容器(EDLC)储能阵列,与高倍率锂电构成双级瞬态缓冲架构,就地吸收并滤除高频脉冲电流,将母线纹波电压严格平抑在200mV以内。
放电倍率与阻抗控制:严选单体交流内阻(ACIR @1kHz)小于0.5mΩ的高倍率LiFePO4电芯,成组后系统级动态放电响应时延必须小于100μs
超级电容脉冲吸收拓扑:在GPU计算刀片配电支路就地跨接超低ESR混合电容模组,以平抑上升沿小于10μs、峰值电流达300A的极端di/dt冲击
LVD防误动门限迟滞整定:协同校准BMS与整流架控制单元的欠压脱扣电压曲线,设置200ms以上具备阶梯滤波特征的瞬态低电压屏蔽延时窗口
4. 紧凑机柜户外热管理:均热板(Vapor Chamber)、IP55/IP65风机气动优化与极值环境硬化
电信宏基站普遍处于裸露的沙漠、楼顶或沿海盐雾等严酷户外环境,环境运行温度区间横跨-40°C至+55°C,完全缺失数据中心级别的恒温冷通道、架空地板及集中冷水二次循环管网。然而,安装在紧凑型标准19英寸户外机柜内的GPU芯片,其裸晶工作结温(Junction Temperature, Tj)上限被严格限制在85°C以内。当环境气温攀升至+55°C极值时,散热模组全链路留存的热阻(Thermal Resistance)预算已被极度压缩至小于0.04°C/W。传统基于纯铝或单体热管的风冷散热鳍片在此超高热流密度(>50W/cm²)下将瞬间面临热饱和并导致芯片降频保护。
实现这一物理热极限突围的技术路径依赖于复合相变微通道均热板(Vapor Chamber)与高性能金属粉末烧结工艺的结合。均热板通过工质相变在XY二维平面内实现超快速各向同性热扩散,将集中的热源低热阻展宽至高密度散热鳍片总成。与此同时,户外机柜的防护密闭性(必须满足IP55或IP65防尘防水标准)与大风量低流阻气道构成了天然矛盾。工程上必须抛弃传统的低静压风机,转向搭载PWM精确无级调速、具备高反压特性的48V直流大静压离心式或反相双转子轴流风机组,其在满载风阻工况下的风量需达到400-600 CFM以上,并通过风道流体力学(CFD)导流板优化,强制形成独立隔离的正压冷风道与负压排热流道。
极值工况温升裕量校核:在户外+55°C最高环境温度叠加1120W/m²高强太阳辐射测试下,GPU内核最高稳态结温严禁突破80°C警戒线
均热板相变效能基准:VC底座与冷凝面之间的整体导热系数等效值应提升至不低于5000W/(m·K),并历经-40°C至+85°C深度热循环无形变与泄漏
防护风机组气动可靠性:选用通过IP55/IP65认证、具备双滚珠轴承且MTBF大于10万小时的直流风机,机柜内部流阻应控制在小于250Pa设计水平
5. 光前传网络与确定性时间同步:eCPRI 25G/100G接口、IEEE 1588v2 PTP抖动预算与L1时延合规
AI-RAN的分布式部署架构要求基带GPU计算节点与远端射频单元(RRU/AAU)之间维持极高吞吐且极低时延的光前传链路。基于通用GPU的软件化物理层必须终结高负载的增强型通用公共无线电接口(eCPRI)流量。在典型的64T64R Massive MIMO配置下,单载波100MHz带宽即可压榨出数十吉比特每秒的前传带宽需求,这迫使基站前传接口全面演进为25Gbps NRZ或100Gbps PAM4光收发模块。GPU计算载板必须配备支持硬件级时间戳标记与前向纠错(FEC)卸载的高性能电信级网卡(SmartNIC),避免网络I/O中断对GPU流处理器产生上下文切换震荡。
在5G时分双工(TDD)及多基站协同处理(CoMP/MIMO)机制中,相际与波束赋形空口同步对绝对时间误差提出了近乎苛刻的约束。遵循IEEE 1588v2高精度时间协议(PTP)及ITU-T G.8275.1电信剖面标准,全网同步拓扑依托主参考时钟(PRTC)与电信边界时钟(T-BC)逐级分配。留给计算节点L1物理层的PTP同步抖动与相对时间误差(Time Error)预算必须严格收敛在<10ns以内,绝对相位误差绝对值不可突破±65ns。这要求GPU算力平台内部的时钟树设计、PHY收发器锁相环(PLL)以及PCIe硬件时钟同步机制完成深层次软硬件硬化,彻底根除因操作系统内核中断抖动导致的时间漂移。
PTP时间误差严苛预算:使用高精度时间综合分析仪实测,确保GPU加速节点网络端口处捕获的1PPS及时钟相位抖动峰峰值严格控制在<10ns范围
光前传链路眼图与误码率:25G/100G eCPRI光收发模组在-40°C至+85°C工业宽温运行区间内,前向纠错前原生误码率(BER)需恒定优于1E-12
GPUDirect RDMA时延确定性:锁定前传数据包从光口接收到GPU显存直接落盘的网络时延,端到端单向传输确定性时延必须小于15μs且零丢包
6. 存量宏站现代化改造实施手册:阶梯式割接、DC PDU断路器级联选择性与现场开通规范
针对存量棕地(Brownfield)蜂窝基站的AI-RAN现代化改造工程,必须在完全不中断正在承载的现网商用业务这一前提下推进,对工程的带电割接与风险回退能力提出了极高要求。现场施工前,工程团队必须完成全面的现场环境健康度审计,包括交流进线容量核查、地网接地阻抗测试(确保通信联合接地电阻<1Ω)以及机架残余静态承重计算。实施阶段应推行严格的四步割接法:整流架一次直流母线扩容、高倍率锂电组热插拔并联上线、GPU计算刀片进场上电、最后利用波分复用(WDM)光分路器平滑切换eCPRI光纤流至全新算力节点。
在此演进过程中,直流配电单元(PDU)断路器的保护选择性级联协调(Selective Coordination)是杜绝电气事故的核心壁垒。鉴于GPU算力刀片内置庞大的大容量输入滤波电容组,在上电瞬间会产生巨大的冲击电流(Inrush Current),现场必须选用具备磁通可控、延迟跳闸特性的液压电磁式断路器或特种C/D脱扣曲线直流断路器。设计上必须精确构建各级保护的时间-电流动作特性曲线(TCC),确保后级支路断路器(150A-200A)在毫秒级短路瞬态下的脱扣动作绝对快于前级主配电断路器(300A-400A),防止局部单板故障越级跳闸引发全站供电瘫痪。
断路器时间-电流动作曲线级联整定:现场复核一级主配电与二级支路PDU断路器的瞬态磁脱扣动作时差,保证最小级差选择性隔离裕量不小于50ms
高负荷热成像与电气绝缘测试:改造完成后以100%峰值负载连续热机运行4小时,使用红外热像仪校核各连接螺栓及铜排温升不超标(ΔT<35K),500V DC下母线绝缘电阻>10MΩ
现场开通双向时钟与吞吐终验:执行48小时连续业务浸泡测试,核验L1 PHY未发生任何因时钟失步导致的丢帧重传,全站综合可用性稳定达到99.999%