Физика тензорных вычислений: Преимущества фотонных GEMM над полупроводниковой логикой
Классические кремниевые графические процессоры (GPU) и специализированные ускорители (ASIC) выполняют операции обобщенного матричного умножения (GEMM) за счет переключения миллиардов транзисторов, где фундаментальными физическими барьерами выступают паразитная емкость межсоединений, токи утечки и термический троттлинг. При переходе к литографическим узлам класса 3 нм и 2 нм удельные энергозатраты на одну операцию умножения с накоплением (MAC) стабилизировались в диапазоне от 1 до 3 пикоджоулей. Значительная часть этой энергии расходуется не на логические преобразования, а на перезарядку паразитных емкостей металлических слоев кристалла и передачу зарядов по шинам данных между регистрами и локальной памятью SRAM.
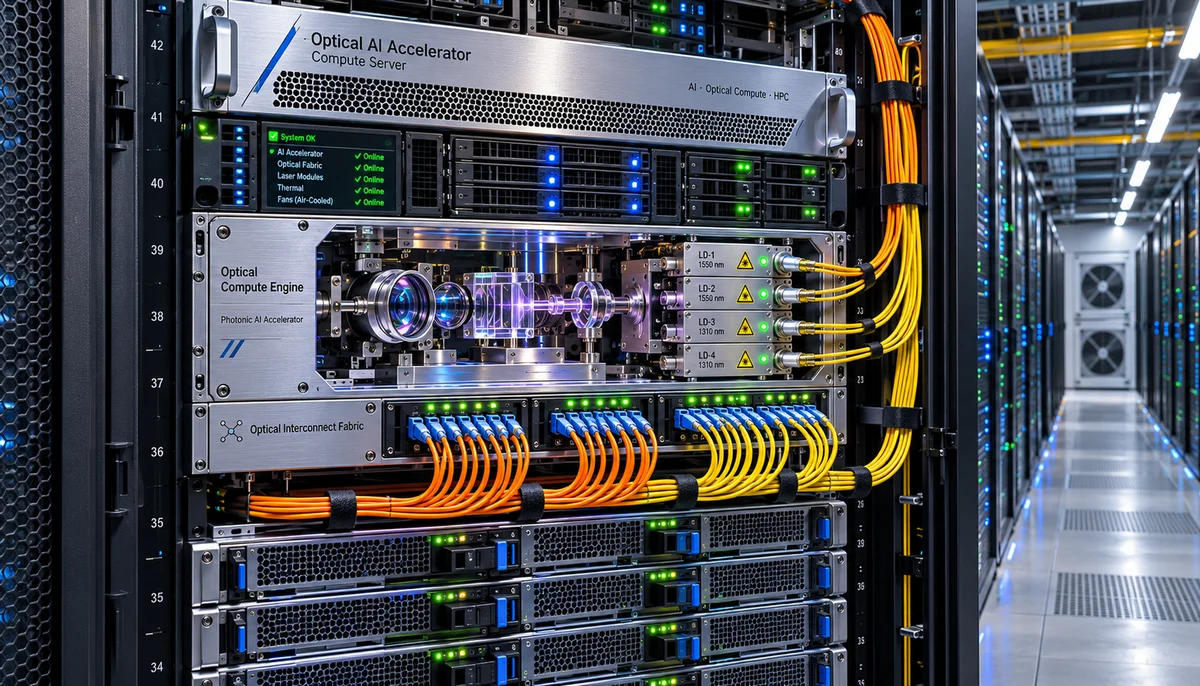
Оптические вычислительные сопроцессоры радикально трансформируют физику вычислений, реализуя умножение матриц непосредственно в оптическом домене со скоростью распространения электромагнитной волны. Входные тензоры модулируются по амплитуде или фазе на когерентные лазерные несущие с использованием спектрального уплотнения (WDM), после чего световые потоки направляются в пассивные оптические матричные процессоры. В зависимости от топологии это могут быть каскады интерферометров Маха-Цендера (MZI), матричные резонаторные решетки на микрокольцах или дифракционные оптические элементы свободной оптики. В пассивном тракте интерференция и дифракция выполняют миллионы операций MAC за такт без выделения джоулева тепла, обеспечивая энергопотребление на уровне менее 0,1 пДж на MAC-операцию.
Энергетическая эффективность оптического умножения: менее 0,1 пДж/MAC против 1,0-3,0 пДж/MAC у кремниевых GPU техпроцесса 3 нм/2 нм.
Использование спектрального мультиплексирования WDM для параллельного исполнения тензорных операций в едином волноводном тракте.
Дезагрегация инференса: Оптимизация фазы Prefill и разгрузка декодирования
Инференс современных больших языковых моделей характеризуется выраженной вычислительной асимметрией между фазой обработки входящего контекста (Prefill) и пошаговой генерацией токенов (Decode). Фаза Prefill строго ограничена вычислительной мощностью (compute-bound): веса модели многократно переиспользуются для всех входных токенов запроса, что формирует сверхвысокую арифметическую интенсивность тензорных операций. Именно на этом этапе оптические ускорители демонстрируют десятикратное превосходство по плотности пропускной способности, выполняя проекции Key, Query, Value и плотные матричные умножения механизма внимания с минимальными задержками при контекстных окнах от 32 тысяч до 1 миллиона токенов.
В противоположность этому, фаза Decode жестко ограничена пропускной способностью памяти (memory-bound), требуя последовательной генерации одиночных токенов с постоянной выборкой весов и KV-кэша из памяти HBM3e/HBM4. Дезагрегированная архитектура разделяет вычислительный кластер на оптические узлы Prefill и полупроводниковые узлы Decode, соединенные низколатентной фабрикой RoCEv2 или InfiniBand. Оптический кластер обрабатывает тяжелый промпт, формирует распределенный KV-кэш и мгновенно передает его через механизмы PagedAttention в специализированные GPU-серверы генерации. Программные движки vLLM, SGLang и TensorRT-LLM обеспечивают прозрачную маршрутизацию запросов с поддержкой Chunked Prefill.
Разделение фаз инференса с направлением compute-bound вычислений (Prefill) на пассивные оптические матрицы, а memory-bound (Decode) — на HBM-ориентированные ASIC/GPU.
Стриминг сгенерированного KV-кэша через сверхнизколатентные интерконнекты RoCEv2/InfiniBand с аппаратной поддержкой PagedAttention.
Тепловые бюджеты и интеграция в существующую инфраструктуру воздушного охлаждения
Современные гипермасштабируемые дата-центры сталкиваются с жестким дефицитом подводимой электрической мощности на уровне фидеров подстанций и машинных залов. В то время как классические кластеры высокоплотных GPU требуют перевода стоек на энергопотребление от 80 до 120 кВт с внедрением жидкостного охлаждения (CDU, прямые водоблоки, вторичные контуры), внедрение оптических серверов снимает инфраструктурные барьеры. В гибридной электрооптической схеме оптическое ядро выполняет ресурсоемкие линейные GEMM-операции без нагрева, тогда как цифровые контроллеры и стандартные кристаллы DRAM/SRAM реализуют нелинейные функции активации (Softmax, SiLU, RMSNorm).
Благодаря отсутствию локальных термических горячих точек (hotspots) в оптических тензорных блоках суммарное энергопотребление оптического вычислительного узла в форм-факторе 2U/4U не превышает 1,5–2,5 кВт. Это позволяет монтировать вычислительные мощности непосредственно в традиционные 19-дюймовые стойки стандарта EIA-310 без модернизации систем охлаждения машзала. Оборудование полностью укладывается в рамки стандартного воздушного кондиционирования с изолированными горячими и холодными коридорами по спецификациям ASHRAE классов A1 и A2, исключая многомиллионные капитальные затраты на гидравлические контуры.
Пиковое тепловыделение серверного шасси 2U/4U в пределах 1,5-2,5 кВт при производительности петафлопсного класса.
Полная совместимость со стандартными 19-дюймовыми стойками EIA-310 и воздушным охлаждением без перехода на распределительные узлы теплоносителя (CDU).
Оптоэлектронная компонентная база, стабилизация фазы и управление потерями
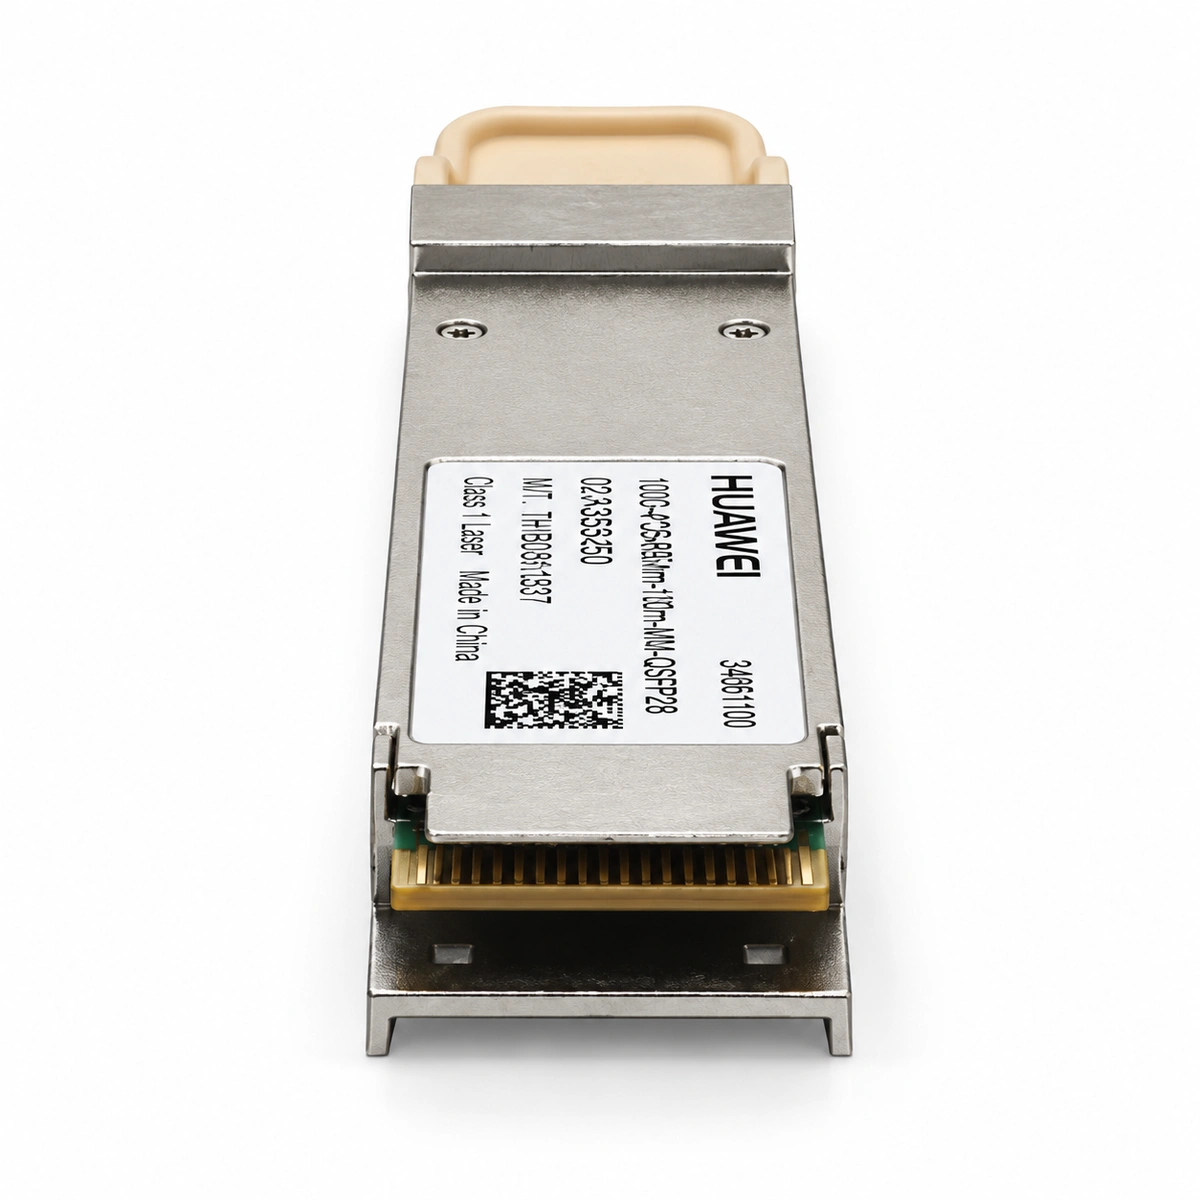
Надежность и экономическая целесообразность фотонных процессоров определяются глубиной унификации с устоявшейся экосистемой оптических трансиверов телеком-стандарта. В архитектурах оптического инференса применяются стандартные полупроводниковые лазеры с распределенной обратной связью (DFB), электроабсорбционные модуляторы (EAM) и интерферометры Маха-Цендера, функционирующие в телекоммуникационных диапазонах O-band (1310 нм) и C-band (1550 нм). Связь оптических модулей с сервером осуществляется через стандартные форм-факторы оптических трансиверов OSFP и QSFP-DD, что минимизирует зависимость от кастомных кремниевых литографий и удешевляет цепочку поставок.
Критическим инженерным вызовом остается сохранение когерентности и борьба с оптическими потерями (insertion loss). Для компенсации термического дрейфа длины волны (не превышающего 0,01 нм/°C в диапазоне температур от 10°C до 45°C) вычислительные модули оснащаются микротермоэлектрическими охладителями (TEC) и замкнутыми контурами фазовой автоподстройки (interferometric feedback loop). Оптимизация ввода излучения через профилированные кремниевые волноводы и нанесение антибликовых просветляющих покрытий позволяют сохранить отношение сигнал/шум (SNR), достаточное для прецизионного исполнения математики в форматах низкой разрядности INT8 и FP8.
Интеграция телекоммуникационных лазерных массивов DFB и модуляторов EAM/MZI на длинах волн 1310 нм и 1550 нм в типовые форм-факторы OSFP/QSFP-DD.
Прецизионный термоэлектрический контроль (дрейф длины волны менее 0,01 нм/°C) и компенсация оптических потерь для обеспечения SNR под форматы FP8/INT8.
Экономика TCO, экологическая эффективность и рекуперация заблокированной мощности ЦОД
Специфика современных дата-центров заключается в наличии так называемой заблокированной мощности (stranded power), когда физическое пространство серверных стоек остается незадействованным из-за достижения локального лимита по электропитанию или теплоотводу. Делегирование от 60% до 70% энергетических затрат инференса специализированным оптическим узлам Prefill высвобождает мегаватты мощности питающих подстанций. Это позволяет операторам утроить число параллельно обрабатываемых запросов на единицу энергопотребления ЦОД без пересмотра контрактов на технологическое присоединение к энергосетям.
Полевые испытания в рамках инициатив, аналогичных UK ARIA Scaling Inference Lab (на примере процессоров Lumai Iris Nova), демонстрируют наработку на отказ (MTBF) оптических матричных модулей свыше 100 000 часов благодаря отсутствию электромиграции проводников под высокими токами. Полное исключение мокрого испарительного охлаждения оптических стоек снижает коэффициент эффективности водопользования (WUE) до нуля, улучшая совокупную стоимость владения (TCO). Программная интеграция на базе Kubernetes и фреймворка KServe гарантирует динамическое оркестрирование оптических и полупроводниковых ресурсов в рамках единого пайплайна инференса.
Рост пропускной способности инференса в 2,5-3 раза при фиксированном лимите энергопотребления дата-центра за счет разгрузки GPU.
Показатель наработки на отказ (MTBF) фотонных модулей более 100 000 часов и нулевой показатель расхода воды (WUE) для оптического вычислительного контура.
Поставки оборудования и техническая поддержка
Для получения технической документации, расчета энергетической топологии и оптовых заказов свяжитесь со специалистами HEFENGQI.