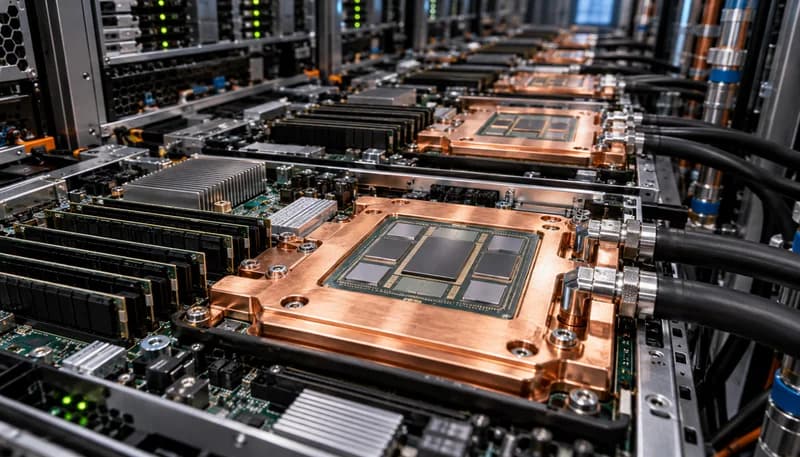
Предел сетки шагографа и дезагрегация кремния: физико-экономический базис 2.5D/3D-чиплетов
На протяжении пяти десятилетий парадигма микропроцессоров серверного класса базировалась на монолитных кристаллах. Однако современные рабочие нагрузки гиперскейлеров — распределенное обучение трансформерных моделей (LLM), инференс высокой плотности и мультитенантные облачные среды — уперлись в фундаментальный физический предел площади экспозиционной сетки литографического шагографа (reticle limit ~858 мм² при стандартном щелевом сканировании). Попытки приблизиться к этому барьеру на передовых техпроцессах (3 нм и ниже) экспоненциально обрушивают выход годных кристаллов (yield) в соответствии с распределением дефектов Пуассона и Мерфи, делая себестоимость кремния экономически неприемлемой.
Архитектурный ответ заключается в дезагрегации функциональных доменов SoC на модульные кристаллы (чиплеты): вычислительные вычислительные ядра (corelets), срезы кэш-памяти L3, контроллеры ввода-вывода и физические уровни памяти HBM. Это открывает возможность гетерогенной интеграции: вычислительные матрицы критической плотности изготавливаются на передовых суб-3нм EUV-линиях, в то время как аналоговые интерфейсы PCIe/CXL и контроллеры памяти разводятся на зрелых и экономически оптимизированных узлах 7/12 нм. Такая фрагментация нивелирует геометрический лимит маски и обеспечивает масштабирование площади кремния в рамках единой сборки далеко за 1500–2000 мм².
Лимит маски экспонирования (reticle limit): жесткая граница площади монолитного кристалла ~858 мм²
Оптимизация выхода годных кристаллов (yield): снижение себестоимости за счет фрагментации кремния на кристаллы площадью 80–150 мм²
Гетерогенная литография: комбинирование узлов 3 нм (логика) и 7/12 нм (I/O, аналоговые тракты) на одном конструктивном модуле
Межкристальные интерконнекты: стандарт UCIe, кремниевые интерпозеры и ультранизкая задержка
Декомпозиция вычислительного ядра на дискретные кристаллы требует создания межсоединений с плотностью и энергоэффективностью, сопоставимыми с внутрикристальной металлизацией. Традиционные технологии печатных плат не обеспечивают необходимого шага трассировки. Решение базируется на технологиях 2.5D/3D-упаковки с использованием кремниевых интерпозеров со сквозными межкремниевыми переходами (TSV), локальных кремниевых мостов высокой плотности (таких как EMIB) и прямого гибридного сращивания (direct copper-to-copper hybrid bonding) с шагом микроконтактов менее 10 мкм.
Ключевым звеном стандартизации стал протокол UCIe (Universal Chiplet Interconnect Express). Физический уровень UCIe обеспечивает скорость передачи данных до 32 Гбит/с на линию при плотности полосы пропускания по фронту кристалла, измеряемой терабитами в секунду на миллиметр (Tbps/mm). При этом сквозная задержка физического уровня удерживается в пределах t_lat < 2 нс при энергозатратах менее 0.5 пДж/бит. Это позволяет организовать когерентный доступ к разделяемой памяти и распределенному L3-кэшу без штрафов по производительности межъядерного взаимодействия.
Пропускная способность UCIe: до 32 Гбит/с на линию при линейной плотности интерфейса свыше 1–2 Тбит/с/мм
Шаг контактных площадок: миграция от микровыводов с шагом 25–45 мкм к медь-медь гибридному сращиванию с шагом < 10 мкм
Энергетический бюджет канала: энергоэффективность межсоединений на уровне < 0.5 пДж/бит при задержке передачи t_lat < 2 нс
Субвольтовое регулирование питания: демпфирование крутых фронтов di/dt и топологии 48V-to-PoL
Снижение технологических норм в вычислительных чиплетах привело к падению номинального напряжения питания ядра (Vcore) до диапазонов 0.70–0.78 В при одновременном росте потребления сокета до 800–1200 А. Экстремальной инженерной проблемой становится динамика переходных процессов: при мгновенном переходе процессорных матриц из состояния глубокого сна в режим интенсивных тензорных вычислений скорость нарастания тока (slew rate) превышает di/dt > 1500 А/мкс. Индуктивность распределительной сети (PDN) при таких фронтах генерирует катастрофические просадки напряжения (voltage droop) ΔV = L·(di/dt), способные нарушить логическую целостность вентилей.
Для компенсации паразитных параметров классическая схема питания 12 В на материнской плате заменяется вертикальной подачей питания (Vertical Power Delivery, VPD) и многоступенчатым преобразованием 48V-to-PoL (Point-of-Load). Непосредственно под кристаллом или в гетерогенном стеке размещаются интегрированные регуляторы напряжения (IVR) на базе GaN-структур и кремниевые конденсаторы глубокого залегания (deep trench capacitors). Это сокращает длину силового контура до долей миллиметра, минимизируя эквивалентную последовательную индуктивность (ESL) до единиц пикогенри и снижая омические потери в шинах питания в 16 раз.
Динамика переходных токов: стабилизация напряжения Vcore 0.75 В при скорости нарастания di/dt > 1500 А/мкс
Архитектура VPD: сквозная вертикальная доставка мощности непосредственно под кристалл для подавления паразитной индуктивности PDN
Энергоснабжение материнской платы: замена распределения 12 В на шины постоянного тока 48 В/54 В с сокращением потерь I²R
Микроскопический тепловой поток: микроканальные охлаждающие пластины Direct-to-Chip и деградация TIM
Концентрация сотен вычислительных ядер и матричных ускорителей на составном кристалле формирует беспрецедентную тепловую неоднородность. В то время как I/O-чиплеты и контроллеры HBM рассеивают умеренную мощность, вычислительные ядра генерируют локальные тепловые потоки, превышающие 100 Вт/см². Возникает выраженный градиент температур по площади сборки, провоцирующий механические напряжения и деформацию кремниевого интерпозера из-за рассогласования коэффициентов термического расширения (CTE mismatch) разнородных полупроводниковых блоков.
Традиционное воздушное охлаждение полностью исчерпало себя. Теплосъем обеспечивается прямым жидкостным охлаждением Direct-to-Chip (D2C). Применяются микроканальные охлаждающие пластины с шагом ребер микроструктуры менее 50 мкм, причем плотность оребрения топологически сопоставляется с термопрофилем горячих точек процессора. Для минимизации термического сопротивления на границе раздела кристалл-водоблок внедряются жидкометаллические термоинтерфейсы (LMT) и спекаемые фазопереходные композиты, устойчивые к эффекту вытекания (pump-out) и окислению в условиях циклического изменения температур от 35°C до 85°C.
Плотность теплового потока: гарантированный теплосъем в локальных термических зонах с тепловыделением > 100 Вт/см²
Профилирование микроканалов: оптимизация гидродинамики пластин с геометрией каналов < 50 мкм под карту горячих точек кристалла
Надежность интерфейсов (TIM): применение термоинтерфейсов, стойких к деградации и эффекту pump-out при термоциклировании
Уплотнение платформ и стоечная интеграция: медные шинопроводы 54 В и спецификации Open Rack v3
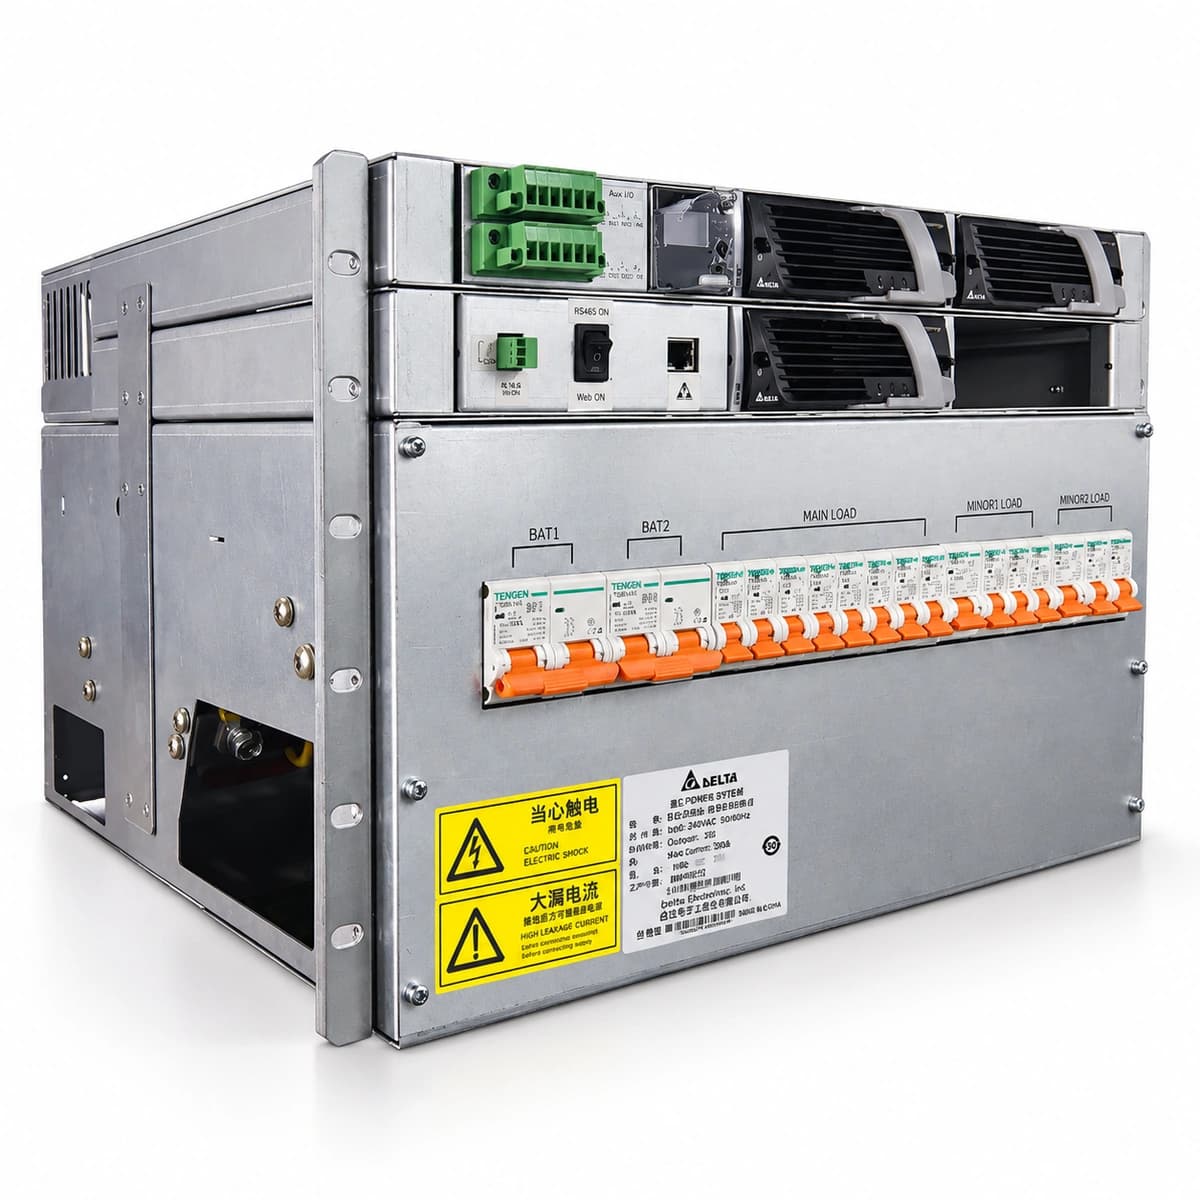
Интеграция чиплетных процессоров с 128–256 ядрами и многокомпонентных ускорителей на один узел привела к резкому уплотнению шасси. Питание 1U/2U серверов мощностью до 2–4 кВт невозможно реализовать через стандартные кабельные жгуты из-за физических ограничений по сечению меди и падению напряжения. Серверные архитектуры гиперскейлеров форсированно переходят на стандарт Open Rack Standard v3 (ORV3), упраздняющий индивидуальные AC-DC блоки в каждом сервере в пользу централизованных полок питания (Power Shelves) с массивными медными шинопроводами (busbars) 48 В/54 В постоянного тока.
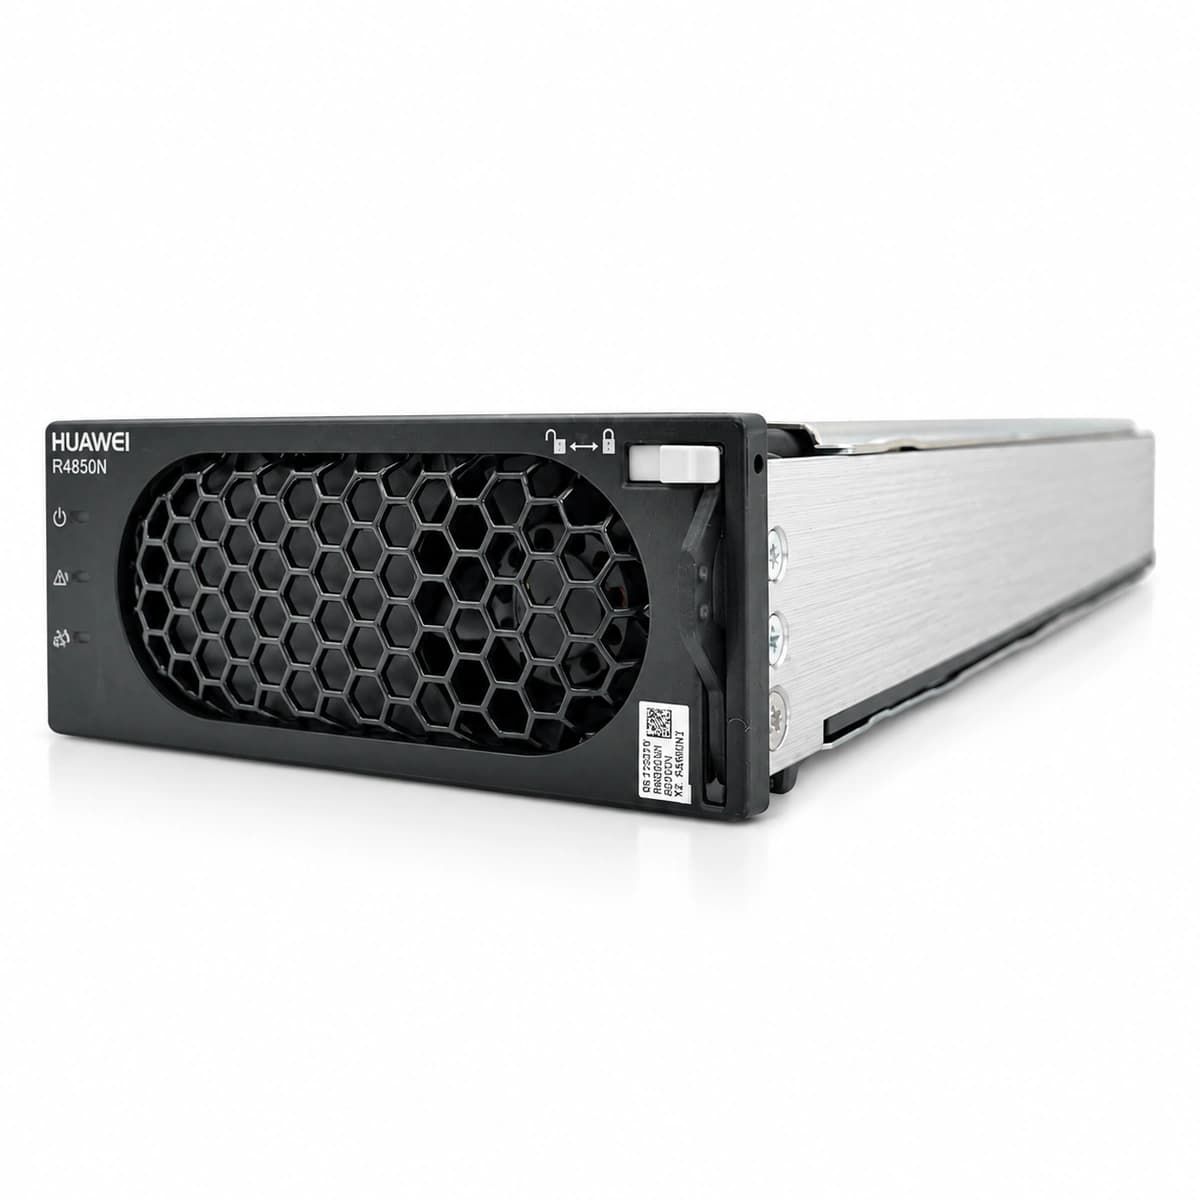
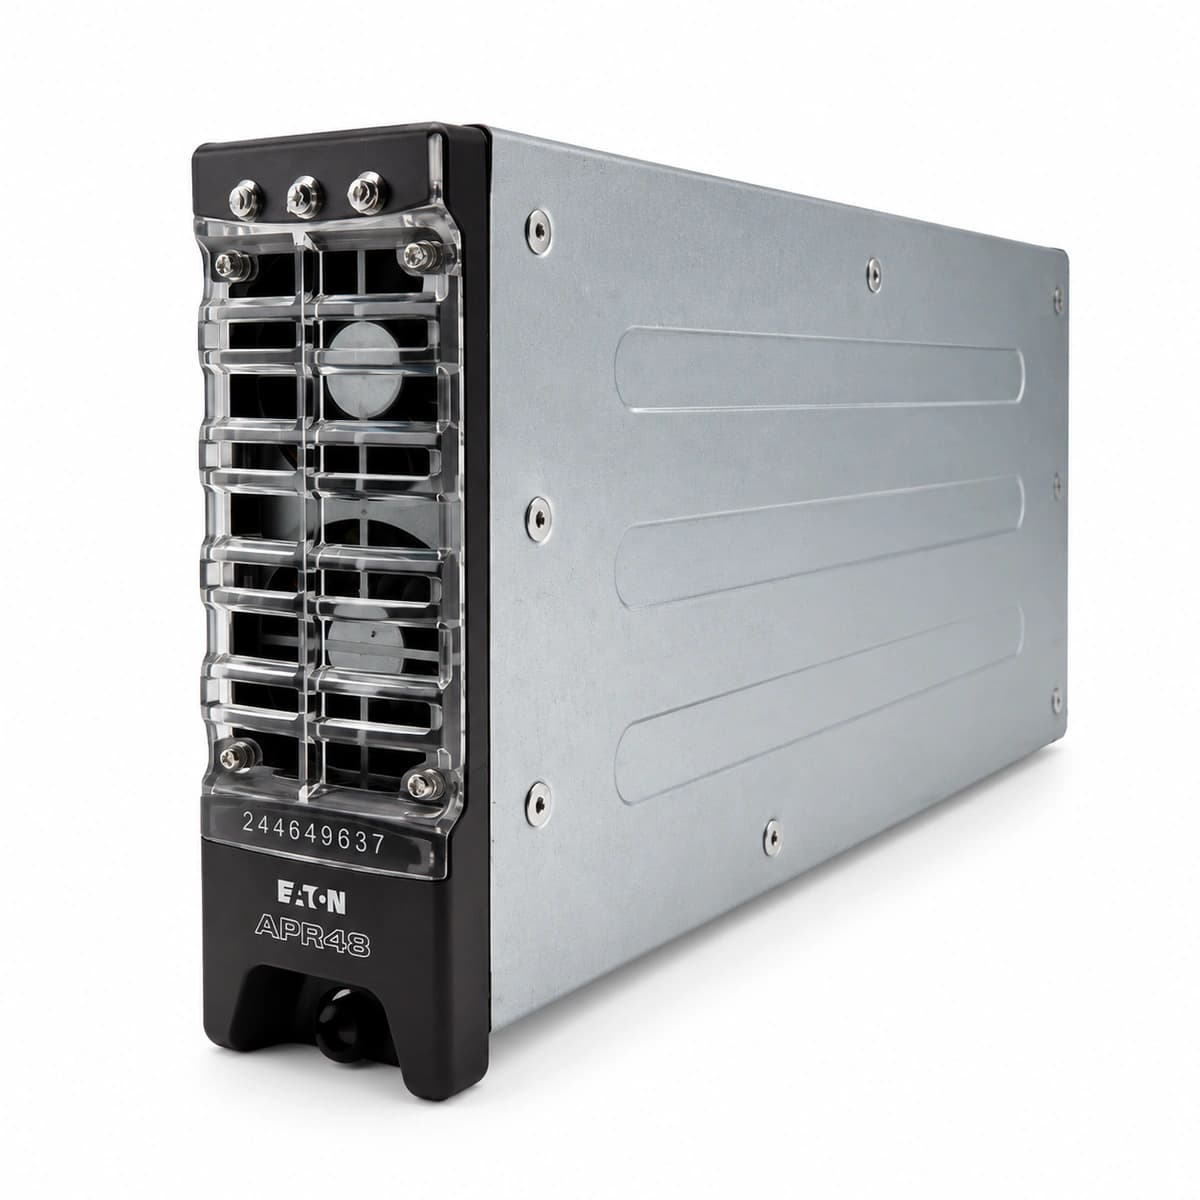
Конструктив ORV3 диктует применение слепых разъемов (blind-mate) высокой надежности как для силовых шин, так и для гидравлических контуров охлаждения. Полки питания комплектуются выпрямительными модулями титанового класса эффективности (>96.5% КПД), что предотвращает паразитный нагрев стойки. Механические расчеты серверного каркаса теперь учитывают значительные статические нагрузки от массы микроканальных водоблоков и гидравлических распределителей (коллекторов), а также усилия сочленения бескапельных быстроразъемных соединений (UQD).
Спецификация питания ORV3: развертывание централизованных шинопроводов 48 В/54 В DC с токовой нагрузкой свыше 1000 А
Энергоэффективность Power Shelf: использование модулей питания класса 80 PLUS Titanium с КПД > 96.5%
Гидравлические интерфейсы: стандартизация на быстроразъемные соединения Universal Quick Disconnect (UQD) с нулевой утечкой
Инженерия ЦОД и ретрофит машинных залов: развертывание СЖО мощностью 60–120 кВт на стойку
Размещение стоек с тепловыделением 60–120 кВт делает невозможным использование традиционных схем охлаждения с фальшполом и кондиционерами CRAH/CRAC, чей физический предел ограничен плотностью 15–25 кВт на стойку. Переоснащение существующих машзалов (brownfield white space) требует масштабной модернизации: прокладки контуров технологического охлаждения (Technology Cooling System, TCS), установки рядных или встроенных в стойку распределительных узлов охлаждения (Cooling Distribution Units, CDU) с пластинчатыми теплообменниками и резервированными насосными группами.
Внедрение чиплетных систем прямого жидкостного охлаждения позволяет перевести инфраструктуру дата-центра на высокотемпературный режим по стандарту ASHRAE W4 (температура подачи теплоносителя на вход в процессор до 45°C). Это исключает из холодильного цикла дорогостоящие и энергоемкие компрессорные чиллеры, переводя дата-центр на круглогодичный режим свободного охлаждения (dry-cooler free-cooling). В результате коэффициент энергоэффективности PUE (Power Usage Effectiveness) удерживается на уровне < 1.15 даже при предельных вычислительных нагрузках чиплетных кластеров.
Тепловая емкость стойки: модернизация машзалов для отвода 60–120 кВт тепловой мощности с одного стойко-места
Температурный базис ASHRAE W4: подача теплоносителя в стойку при температурах до 45°C для круглогодичного фрикулинга
Коэффициент PUE: снижение интегрального показателя PUE дата-центра до целевых величин < 1.15 без использования чиллеров
Поставки оборудования и техническая поддержка
Для получения технической документации, расчета энергетической топологии и оптовых заказов свяжитесь со специалистами HEFENGQI.