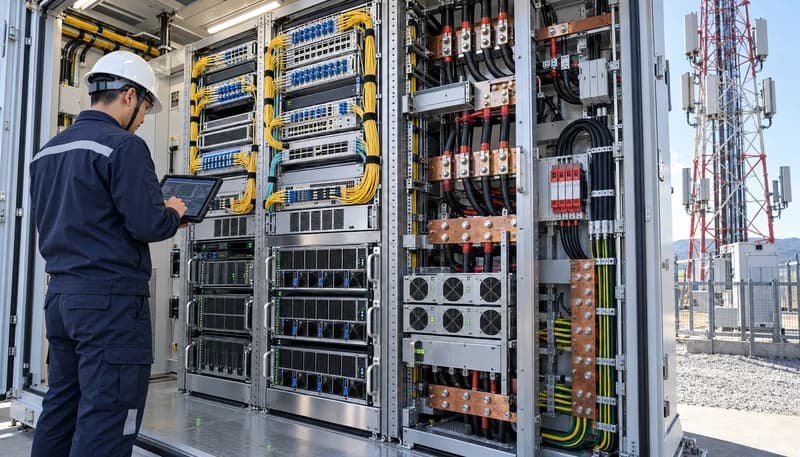
1. Смена парадигмы AI-RAN: Архитектурная дивергенция между ASIC и GPU на физическом уровне L1
Традиционная цифровая обработка сигналов в сетях радиодоступа RAN исторически опиралась на специализированные интегральные схемы (ASIC) и SoC с фиксированной логикой обработки конвейеров FFT/IFFT, модуляции QAM и канального декодирования LDPC/Polar. Данный подход гарантировал минимальное энергопотребление на несущую (TDP в пределах 80–150 Вт на плату цифровой обработки базовых станций) и детерминированное соблюдение временных окон TTI (Transmission Time Interval) в пределах менее 250 мкс для 5G NR Numerology 1 (поднесущая 30 кГц). Однако жесткая топология ASIC исключает динамическую реконфигурацию конвейера под совместную обработку нейросетевых алгоритмов формирования луча (massive MIMO beamforming), предсказания интерференции в реальном времени и задач периферийного инференса (Edge AI).
Архитектура AI-RAN заменяет жестко зафиксированные конвейеры программируемыми тензорными ядрами GPU, функционирующими под управлением специализированных уровней абстракции оборудования (HAL) и драйверов реального времени (RTOS-kernel). Это позволяет производить целочисленную и плавающую матричную математику (FP16/INT8) непосредственно на физическом уровне (PHY/L1). Платой за гибкость и агрегацию задач AI/RAN становится лавинообразный рост расчетной тепловой мощности (TDP) вычислительного узла до 300–700 Вт. На уровне системной логики возникает фундаментальное противоречие: необходимость гарантировать задержку обработки L1 строго в пределах субмиллисекундного бюджета TTI при стохастической природе вычислений AI-инференса, разделяющего общие исполнительные блоки GPU.
Детерминированный лимит задержки конвейера L1: t_proc < 250 мкс при ширине полосы 100 МГц (SCS 30 кГц)
Обеспечение аппаратной изоляции очередей GPU через Single Root I/O Virtualization (SR-IOV) и приоритезацию L1-потоков
Энергетический бюджет вычислительного блейда: расчет от 300 Вт до 700 Вт TDP на сокет при коэффициенте загрузки пула 85%
2. Масштабирование бюджета мощности макросайта: Проектирование выпрямителей -48 В DC и шин распределения
Интеграция высокопроизводительных GPU-ускорителей в существующие телекоммуникационные климатические шкафы разрушает устоявшийся баланс энергопотребления макросайтов, рассчитанный на 1.5–3.0 кВт суммарной мощности. Внедрение двух или трех блейдов AI-RAN поднимает установившуюся нагрузку до 4.5–7.0 кВт на шкаф. Топология распределения питания постоянного тока -48 В DC сталкивается с критическим падением напряжения в кабельных трассах: при номинальном плавающем напряжении буферного подзаряда (float voltage) 53.5–54.0 В DC и токах нагрузки свыше 120–150 А даже паразитное сопротивление проводников в единицы миллиом приводит к просадке шины ниже критического порога отсечки оборудования (42.0–44.0 В DC).
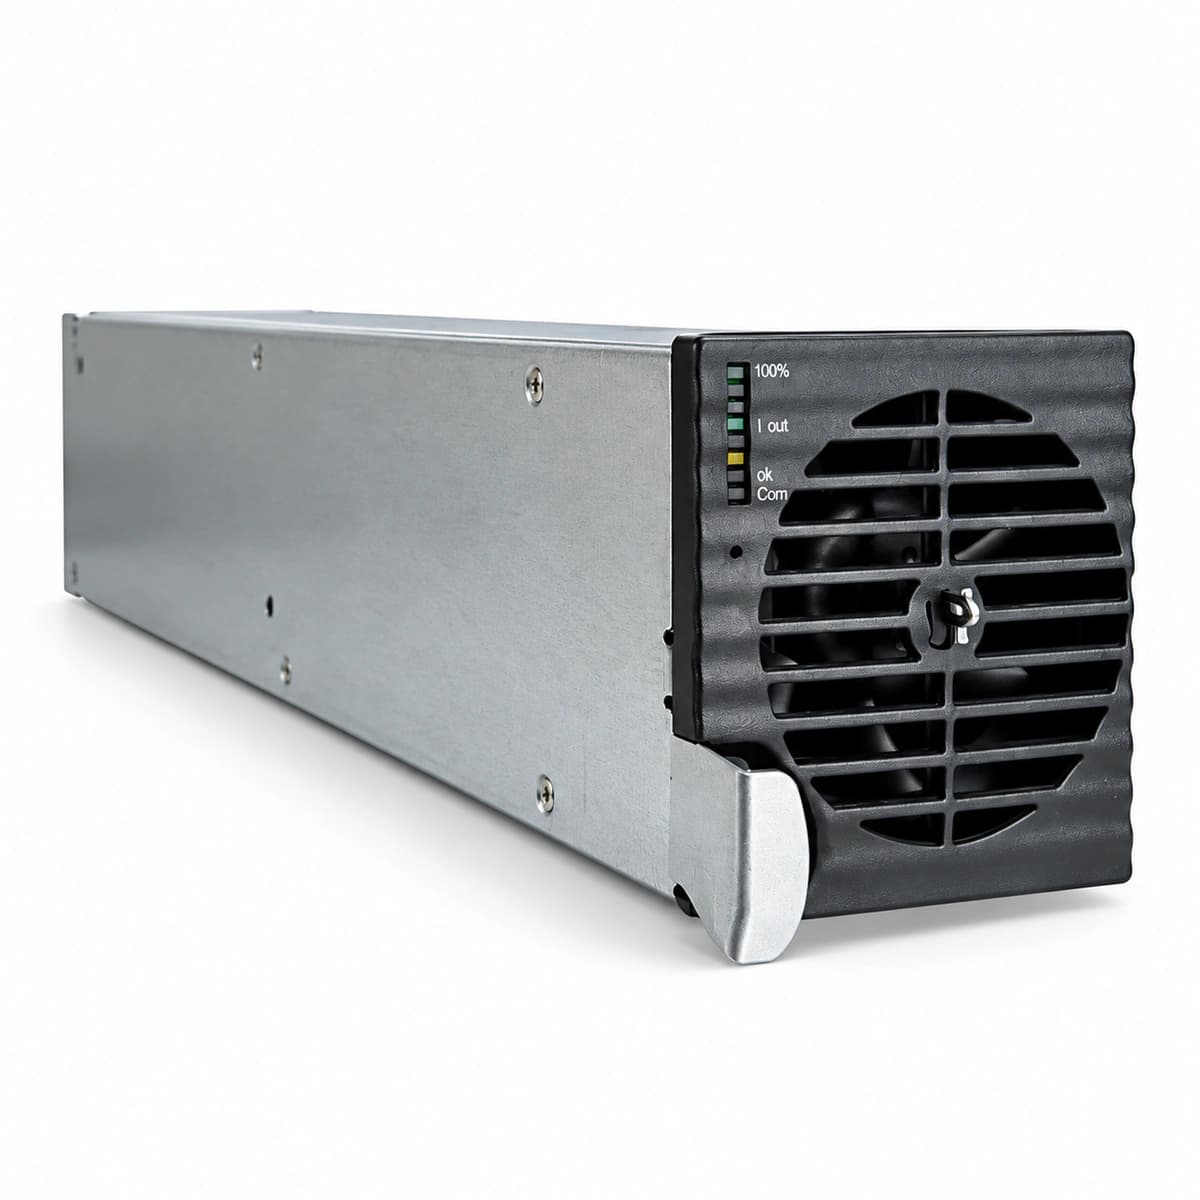
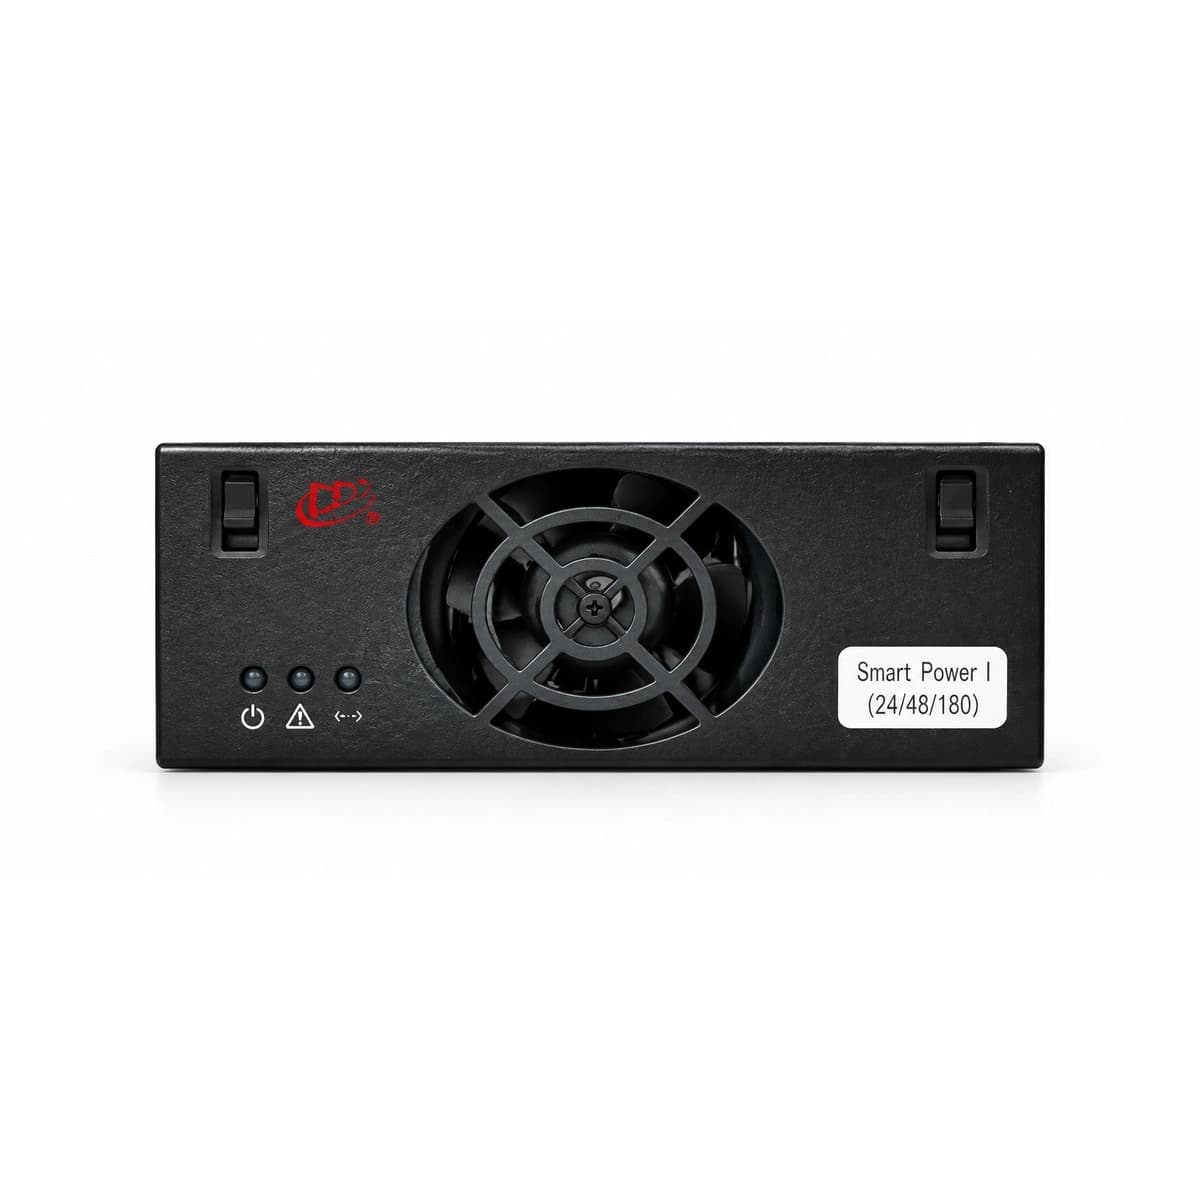
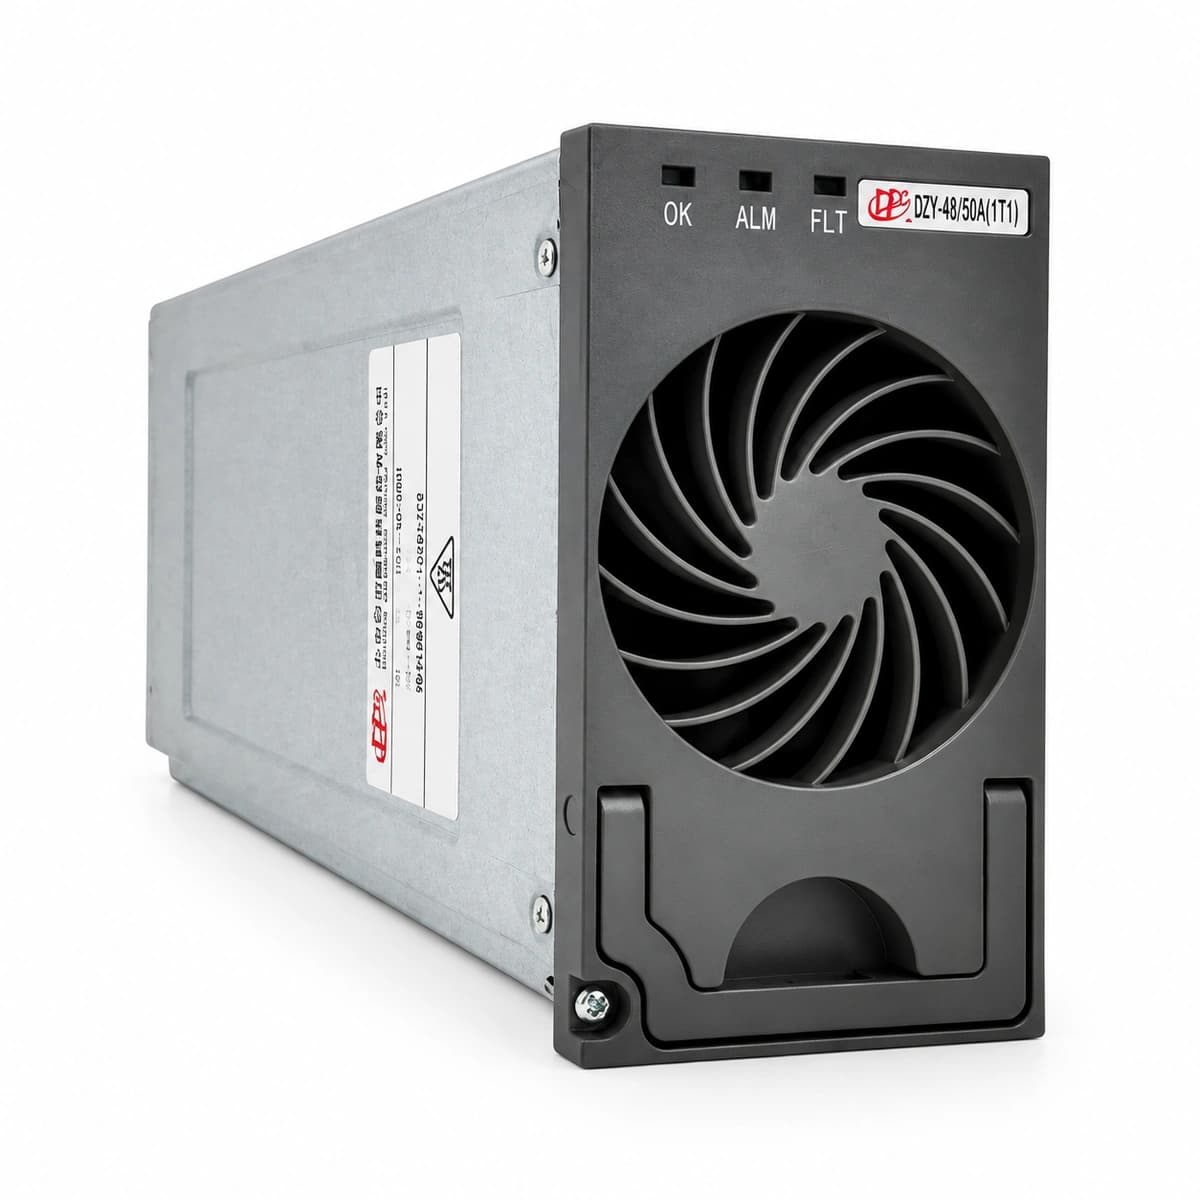
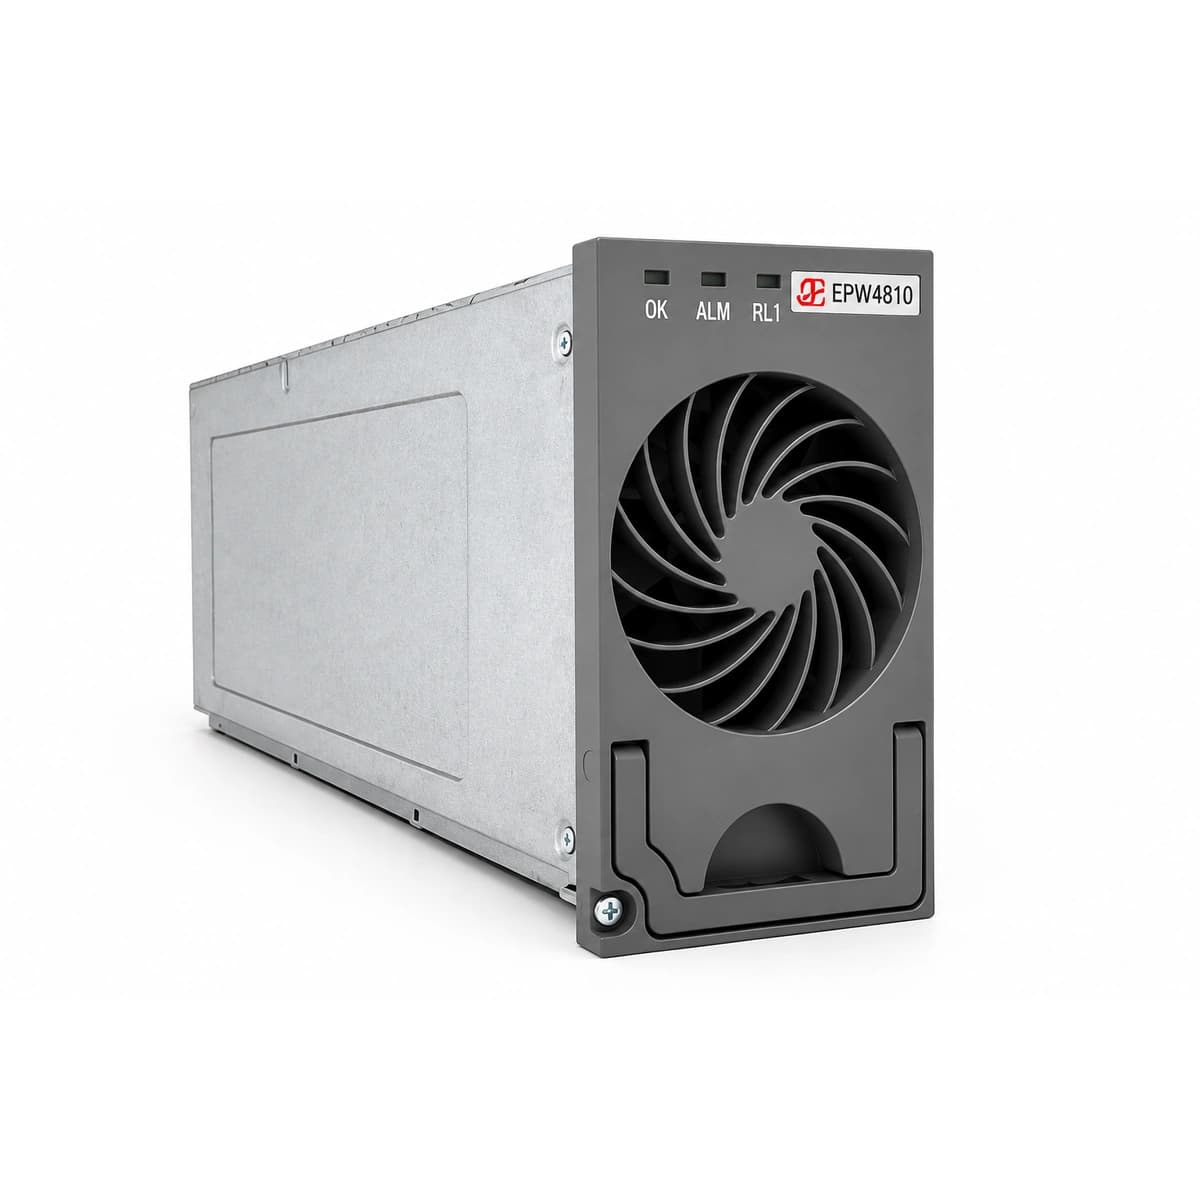
Для предотвращения деградации системы питания архитектура сайтов модернизируется переходом на выпрямительные модули высокой плотности единичной мощностью 3000–6000 Вт с пиковым КПД > 96–98% (топология Totem-Pole PFC с ключами на базе GaN/SiC). Модульные корзины питания расширяются с прежних 100 А до масштабируемых систем на 200–400 А. Распределительные щиты DC PDU требуют внедрения массивных медных шин (busbars) увеличенного сечения с номиналом плотности тока не более 1.5–2.0 А/мм², минимизирующих активные омические потери и исключающих температурный градиент в точках болтовых соединений кабельных наконечников.
Калибровка плавающего напряжения выпрямительной системы: 53.5–54.0 В DC с погрешностью не более ±0.5%
Использование выпрямительных корзин N+1 мощностью от 12 кВт до 24 кВт с энергоэффективностью > 96.5%
Установка DC-автоматов защиты распределительной панели номиналом 150 А – 400 А с характеристиками селективности типа DC-D/K
3. Динамические переходные процессы и демпфирование микросбоев: Буферные батареи LiFePO4 и суперконденсаторы
Характер энергопотребления GPU-ускорителей в задачах AI-RAN носит импульсный, стохастический характер. При переходе от базового радиовещания к всплескам трафика, динамическому формированию лучей massive MIMO и одновременному инференсу больших моделей скорость нарастания тока (di/dt) на шине питания достигает экстремальных значений — от десятков до сотен ампер за микросекунды. Стандартные импульсные выпрямители с частотой ШИМ-модуляции 50–150 кГц и обратной связью по напряжению не способны мгновенно скомпенсировать подобные броски, что генерирует импульсные провалы напряжения и высокочастотный джиттер на DC-шине.
Для нейтрализации импульсов di/dt и обеспечения бесперебойности класса 99.999% («пять девяток») классические свинцово-кислотные аккумуляторы (VRLA) полностью заменяются высокотоковыми литий-железо-фосфатными (LiFePO4) сборками с интегрированными модулями суперконденсаторов (EDLC). Параллельное включение суперконденсаторных сборок непосредственно на входе DC-DC конвертеров серверных блейдов демпфирует субмиллисекундные всплески, в то время как LiFePO4 блоки с C-rate разряда до 2C–3C берут на себя удержание шины при микросбоях внешней сети переменного тока до момента запуска автоматического ввода резерва (АВР) или выхода ДГУ на номинал.
Демпфирование скорости нарастания тока: подавление бросков di/dt до 200 А/мс с помощью входных LC-фильтров и EDLC
Инсталляция высокотоковых LiFePO4 батарей с поддержкой непрерывного разряда токами до 2C и ресурсом > 4000 циклов
Интервал допустимой просадки напряжения шины при коммутации нагрузок: Delta V < 1.8 В DC в течение 10 мс
4. Терморегулирование компактных уличных шкафов: Испарительные камеры, вентиляторы IP55/IP65 и жесткая внешняя среда
В отличие от специализированных ЦОД с прецизионным жидкостным охлаждением и изолированными холодными коридорами, базовые станции сотовой связи размещаются в компактных уличных термошкафах на крышах зданий и антенно-мачтовых сооружениях. Диапазон температур окружающей среды составляет от -40°C в условиях арктической зимы до +55°C при экстремальной инсоляции в аридных зонах. Отвод 1.5–2.0 кВт тепла непосредственно от кристалла GPU внутри ограниченного пространства шкафа глубиной 600–800 мм требует исключения локальных зон перегрева («горячих точек») на кристаллах, работающих при критическом пороге T_junction 85–95°C.
Архитектурное решение базируется на применении гибридных медных испарительных камер (Vapor Chambers) с капиллярной структурой из спеченного медного порошка, сопряженных с композитными тепловыми трубками прямого контакта. Воздушный тракт изолируется: внешний контур обслуживается интеллектуальными вентиляторными матрицами со степенью защиты оболочки IP55/IP65 и управляемым ШИМ-профилем по шине RS-485/Modbus. Аэродинамический расчет теплообменника типа «воздух-воздух» оптимизируется под перепад статического давления до 350 Па для обеспечения расхода воздуха не менее 450–600 CFM без выхода за шумовые ограничения муниципальных норм (не более 65 дБА на расстоянии 1 м).
Максимальная рабочая температура кристалла кремния GPU под полной нагрузкой: T_j <= 85°C при температуре окружающей среды +45°C
Применение сертифицированных вентиляторных сборок IP55/IP65 с наработкой на отказ MTTF > 100 000 часов при +60°C
Тепловое сопротивление системы охлаждения (R_th кристалл-радиатор): не более 0.045–0.055 °C/Вт
5. Оптический транспорт Fronthaul и детерминированная синхронизация: Интерфейсы eCPRI, джиттер IEEE 1588v2 PTP и задержки L1
Развертывание распределенных радиоинтерфейсов O-RAN Split 7.2x требует непрерывной передачи радиосигналов во временной и частотной областях между модулями радиоблоков (O-RU) и распределенными серверами обработки (O-DU / AI-RAN блейдами). Агрегация нескольких несущих по 100 МГц с матрицами massive MIMO 64T64R диктует переход от устаревших линков CPRI к пакетизированным оптическим интерфейсам eCPRI 25G/100G с использованием трансиверов SFP28/QSFP28 промышленного температурного диапазона (Industrial Temp: -40°C ... +85°C). Потоки данных инкапсулируются поверх стандартного Ethernet с жесткими требованиями к приоритизации трафика согласно стандартам Time-Sensitive Networking (TSN IEEE 802.1Qbu/802.1Qbv).
Ключевым инженерным вызовом выступает синхронизация частоты, фазы и времени. Для корректной когерентной демодуляции и формирования диаграммы направленности суммарный бюджет ошибки времени (Time Error, TE) между антенными портами не должен превышать жесткий лимит Class C/D ITU-T G.8273.2. Архитектура AI-RAN на базе GPU должна поддерживать интерфейсы точного времени IEEE 1588v2 PTP (профили G.8275.1 / G.8275.2) и механизм SyncE. Блейд-сервер обязан оснащаться встроенным контроллером NIC с аппаратной фиксацией временных меток (hardware timestamping) непосредственно на уровне PHY-трансивера с джиттером менее 4–8 нс, нивелируя вариации времени обработки в операционной системе.
Бюджет фазовой погрешности синхронизации (Time Error budget) узла O-DU: |TE| < 10 нс относительно эталона PRTC
Оптический бюджет тракта eCPRI 25G/100G: поддержка потерь линии до 10 дБ с кодированием FEC (RS-FEC IEEE 802.3by)
Аппаратный таймстампинг пакетов IEEE 1588v2 с субнаносекундным разрешением таймера (точность фиксации < 4 нс)
6. Регламент модернизации brownfield-сайтов: Пошаговый ретрофит, селективность PDU и стандарты пусконаладки
Модернизация действующих (brownfield) площадок базовых станций под стандарты AI-RAN сопряжена с жесткими ограничениями: работы должны проводиться в условиях непрерывного предоставления сервисов («zero-downtime») при минимальных габаритах площадки. Процедура начинается с ревизии входящего ввода переменного тока (AC Mains): выполняется замер фактического коэффициента мощности и гармонических искажений (THD_I), после чего существующие вводные кабели заменяются с пересчетом допустимой токовой нагрузки на длительный нагрев при cos φ = 0.99. В распределительной стойке DC PDU производится пересчет координации защитных аппаратов: автоматы с электромагнитным расцепителем заменяются на быстродействующие автоматические выключатели постоянного тока с отключающей способностью не менее 10 кА.
Финальная стадия включает в себя физическую интеграцию серверов AI-RAN в посадочные места шкафа, перекоммутацию силовых медных кабелей сечением 50–95 мм² с опрессовкой двухболтовыми наконечниками NEMA и затяжкой динамометрическим ключом с контролем момента (норма 12–15 Н·м). Перед вводом сайта в промышленную эксплуатацию проводится протоколирование тепловизионной съемкой под 100% нагрузочным тестированием синтетическим трафиком O-RAN в течение 4 часов, замер пульсаций постоянного напряжения осциллографом (ripple voltage <= 100 мВ в полосе до 20 МГц) и верификация калибровки петли синхронизации PTP.
Проверка момента затяжки силовых клеммных соединений DC PDU: верификация динамометрическим инструментом (12–15 Н·м)
Контроль амплитуды высокочастотных пульсаций на DC-шине: U_ripple < 100 мВ пик-пик при нагрузке 100%
Обязательное тепловизионное обследование всех узлов коммутации: температурный перепад Delta T над шиной не более 10°C
Поставки оборудования и техническая поддержка
Для получения технической документации, расчета энергетической топологии и оптовых заказов свяжитесь со специалистами HEFENGQI.