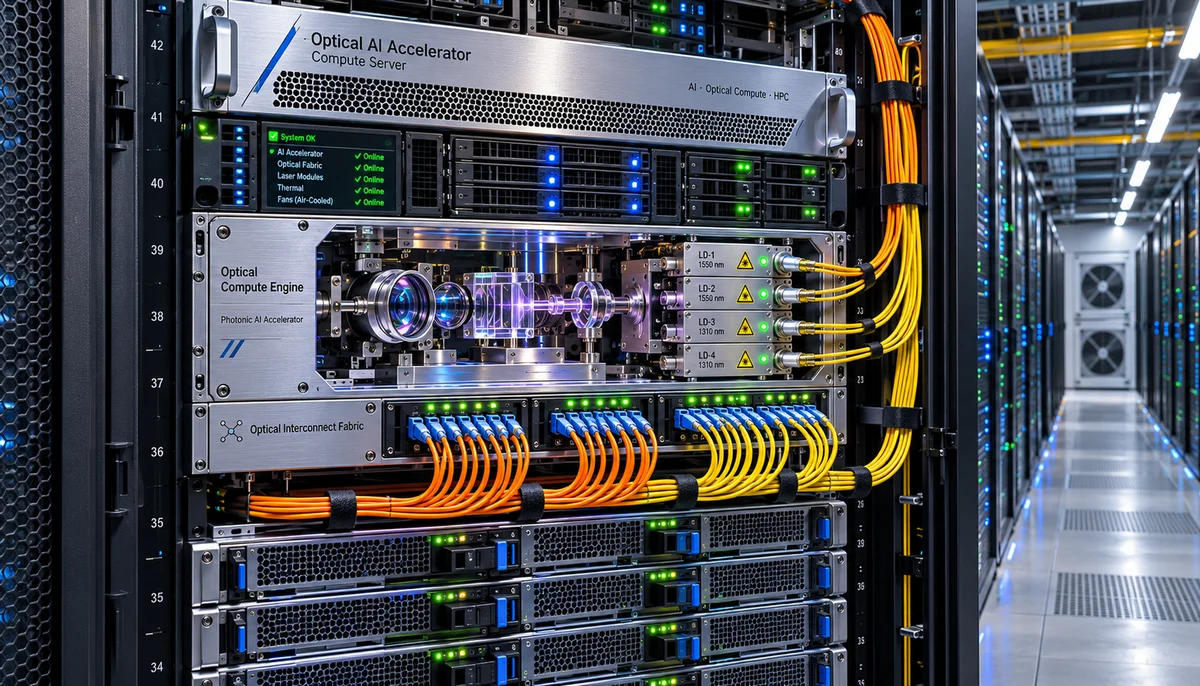
Physique du Produit Matriciel : Électrons versus Photons dans le Calcul GEMM
Les accélérateurs graphiques et les circuits intégrés spécifiques au silicium atteignent aujourd'hui des limites thermodynamiques et capacitives indépassables lors de l'exécution des opérations de multiplication matricielle généralisée (GEMM). Dans les nœuds CMOS avancés de 3 nm et 2 nm, chaque commutation logique engendre une dissipation d'énergie capacitive proportionnelle à la fréquence et au carré de la tension d'alimentation, sans omettre les pertes parasitaires induites par le déplacement des charges sur les bus métalliques microscopiques. Même optimisées pour les formats de quantification réduits FP8 ou INT4, les unités arithmétiques numériques conventionnelles consomment entre 1 et 3 picojoules par opération de multiplication-accumulation (MAC), générant une densité thermique surfacique insoutenable au cœur des puces de calcul haute performance.
Le calcul optique opère un changement de paradigme fondamental en transposant le calcul matriciel dans le domaine analogique et photonique. L'information numérique est convertie sous forme d'états lumineux modulés en intensité ou en phase, multiplexés par répartition en longueur d'onde (WDM) sur des faisceaux laser cohérents. En guidant ces photons à travers des réseaux d'interféromètres de Mach-Zehnder (MZI), des résonateurs à micro-anneaux ou des matrices diffractives en espace libre, les opérations MAC s'effectuent passivement à la vitesse de la lumière par interférence constructive et destructive. La dissipation thermique de cette matrice passive est quasiment nulle, réduisant le coût énergétique intrinsèque du calcul matriciel à moins de 0,1 picojoule par opération MAC, décorrélant enfin le débit de calcul brut de la facture thermique du die.
Consommation énergétique intrinsèque inférieure à 0,1 pJ par opération MAC en photonique passive, contre 1 à 3 pJ/MAC en CMOS 3nm/2nm.
Multiplexage WDM exploitant des dizaines de canaux optiques simultanés sur une structure de guides d'ondes en silicium sans contention capacitive.
Temps de propagation ultra-faible régi exclusivement par la constante diélectrique du guide d'ondes et la vitesse de phase de la lumière.
Désagrégation Topologique de l'Inférence : Séparation Systémique Prefill et Decode
Le déploiement industriel des grands modèles de langage (LLM) souffre d'une asymétrie computationnelle majeure entre le traitement du contexte initial et la génération séquentielle des jetons. La phase de prefill, qui ingère des fenêtres de contexte s'étendant de 32k à plus d'un million de tokens, se caractérise par une intensité arithmétique extrêmement élevée. Chaque poids synaptique du réseau de neurones est réutilisé sur l'ensemble des tokens de l'invite, ce qui sature intégralement la puissance de calcul des processeurs vectoriels (compute-bound). C'est précisément sur cette phase que les accélérateurs optiques apportent un gain de densité de débit de 5x à 10x, compressant le temps de calcul du préfixe tout en divisant la puissance électrique requise pour le traitement des matrices de projection QKV.
Inversement, la phase de décodage génère les tokens unitairement de manière autorégressive, induisant une intensité arithmétique minimale tributaire de la bande passante de la mémoire haute densité (memory-bound), nécessitant des sous-systèmes HBM3e ou HBM4 à très faible latence. Les architectures modernes adoptent ainsi une topologie de service désagrégée : des clusters photoniques spécialisés prennent en charge le prefill optique, matérialisent les tenseurs de clés-valeurs (KV cache) et les transmettent via un réseau à faible latence RoCEv2 ou InfiniBand vers des grappes de GPU ou d'ASIC conventionnels dédiés uniquement au décodage séquentiel. Cette orchestration est gérée nativement par des moteurs d'inférence tels que vLLM avec Chunked Prefill, SGLang et Ray Serve, maximisant le taux d'utilisation de chaque type de silicium.
Spécialisation des nœuds : moteurs GEMM optiques dédiés au prefill compute-bound et puces HBM conventionnelles optimisées pour le decode memory-bound.
Diffusion inter-nœuds du cache KV via fabrics RoCEv2 / InfiniBand à latence déterministe sous la microseconde.
Intégration logicielle transparente avec PagedAttention et répartition dynamique des contextes sous vLLM et SGLang.
Architecture Électro-Optique Hybride et Intégration en Refroidissement par Air
Les accélérateurs optiques ne se substituent pas intégralement à la logique numérique mais s'articulent selon une architecture hybride électro-optique minutieusement dimensionnée. Alors que le moteur photonique prend en charge les opérations algébriques linéaires volumineuses représentant plus de 95 % des opérations globales de l'inférence, les couches non linéaires essentielles telles que Softmax, SiLU, GELU et LayerNorm demeurent traitées par des microcontrôleurs numériques programmables associés à des banques de mémoires SRAM et DRAM standard. Les convertisseurs numérique-analogique (DAC) et analogique-numérique (ADC) ultra-rapides assurent l'interface bidirectionnelle entre le domaine électronique de contrôle et le domaine optique de calcul à des cadences d'échantillonnage de plusieurs dizaines de gigasamples par seconde.
Cette division des responsabilités redéfinit les contraintes d'infrastructure en datacenter. Les clusters de GPU modernes exigent désormais des densités de puissance dépassant 100 kW par rack, imposant des boucles de refroidissement liquide direct-to-chip ou par immersion, associées à de coûteuses unités de distribution de liquide de refroidissement (CDU). À l'inverse, l'absence d'effet Joule massif au sein des unités passives de calcul optique permet de concevoir des serveurs d'accélération 2U ou 4U dont l'enveloppe thermique totale n'excède pas 1,5 kW à 2,5 kW. Ces systèmes s'intègrent directement dans les baies standard EIA-310 de 19 pouces régies par un refroidissement conventionnel par air à confinement d'allée chaude et froide, respectant rigoureusement les préconisations thermiques ASHRAE A1 et A2 sans nécessiter de refonte hydraulique du bâtiment.
Enveloppe thermique unitaire contenue entre 1,5 kW et 2,5 kW pour un facteur de forme 2U/4U adapté aux baies conventionnelles 10 kW à 20 kW.
Partitionnement fonctionnel : calcul linéaire GEMM optique et calcul non linéaire numérique basse consommation (Softmax/LayerNorm).
Conformité immédiate avec les normes thermiques ASHRAE A1/A2 sans boucle de fluide caloporteur ni CDU en salle blanche.
Chaîne d'Approvisionnement Photonique, Stabilisation Thermique et Fiabilité
La viabilité industrielle du calcul photonique repose sur la maturité de l'écosystème des télécommunications et des émetteurs-récepteurs optiques pour datacom. Les architectures comme celles développées dans le cadre du projet Lumai Iris Nova exploitent des composants standardisés, notamment des réseaux de lasers à rétroaction distribuée (DFB), des modulateurs à électro-absorption (EAM) et des émetteurs optiques enfichables OSFP ou QSFP-DD opérant dans les fenêtres spectrales des bandes C et O (1310 nm et 1550 nm). Cet alignement sur la chaîne logistique des télécommunications garantit des rendements de fabrication élevés, un approvisionnement pérenne en plaquettes de silicium photonique (SiPh) et un amortissement rapide des coûts de packaging hétérogène et de couplage sur fibre.
La robustesse opérationnelle face aux fluctuations environnementales constitue néanmoins le défi d'ingénierie principal de ces accélérateurs. Les dérives de température induisent des variations de l'indice de réfraction du silicium, provoquant un désalignement de phase des interféromètres et un glissement spectral des résonateurs. Pour contrecarrer ce phénomène, les modules intègrent un contrôle thermique thermoélectrique (TEC) actif couplé à des boucles de rétroaction interférométriques à verrouillage de phase assurant une stabilité de longueur d'onde stricte (dérive inférieure à 0,01 nm par degré Celsius entre 10 °C et 45 °C). Parallèlement, la gestion des pertes d'insertion optique et l'emploi de photodiodes à avalanche haute sensibilité garantissent un rapport signal sur bruit (SNR) adéquat pour maintenir la convergence de quantification en précision FP8 et INT8.
Boucles de rétroaction à verrouillage de phase garantissant une dérive spectrale inférieure à 0,01 nm/°C sous contrainte opérationnelle standard.
Exploitation des lignes de production de silicium photonique 200 mm et 300 mm standardisées pour les émetteurs-récepteurs datacom 1310/1550 nm.
Gestion stricte du budget optique pour préserver un SNR compatible avec les formats de quantification numériques INT8 et FP8.
Bilan TCO, Efficacité Énergétique PUE/WUE et Récupération de Puissance
Dans la majorité des métropoles hébergeant des datacenters hyperscale, la croissance des capacités d'IA est physiquement plafonnée par la puissance disponible délivrée par les postes sources électriques régionaux. L'introduction d'accélérateurs photoniques résout ce problème d'énergie bloquée (stranded power). En déchargeant de 60 % à 70 % de la charge énergétique requise pour le traitement des prompts vers des moteurs optiques économes, les exploitants d'infrastructure peuvent tripler la densité de requêtes simultanées au sein d'une enveloppe électrique globale identique, maximisant ainsi le retour sur investissement des sous-stations existantes.
Au-delà des économies directes sur l'indice d'efficacité énergétique (PUE), le calcul optique présente un impact déterminant sur l'efficacité de l'utilisation de l'eau (WUE). En éliminant le recours aux tours de refroidissement par évaporation et aux échangeurs thermiques à boucle d'eau glacée pour l'étage de prefill, l'empreinte environnementale globale du datacenter est drastiquement réduite. Les validations de terrain menées dans le cadre d'initiatives telles que le laboratoire Scaling Inference de l'agence britannique ARIA démontrent une résilience industrielle conforme aux attentes du secteur, affichant un temps moyen entre pannes (MTBF) supérieur à 100 000 heures et une intégration native au sein d'environnements virtualisés orchestrés par Kubernetes et KServe.
Gain capacitif permettant de multiplier par trois le débit de traitement d'invites à enveloppe de puissance sous-station constante.
Indice d'efficacité d'utilisation de l'eau (WUE) approchant zéro pour le sous-système de calcul optique grâce à l'aéro-refroidissement direct.
Fiabilité industrielle validée par un temps moyen entre pannes (MTBF) supérieur à 100 000 heures dans les bancs d'essai hyperscale.
Approvisionnement et support technique
Pour les fiches techniques, les topologies d'alimentation sur mesure ou les devis de gros, contactez les ingénieurs HEFENGQI.