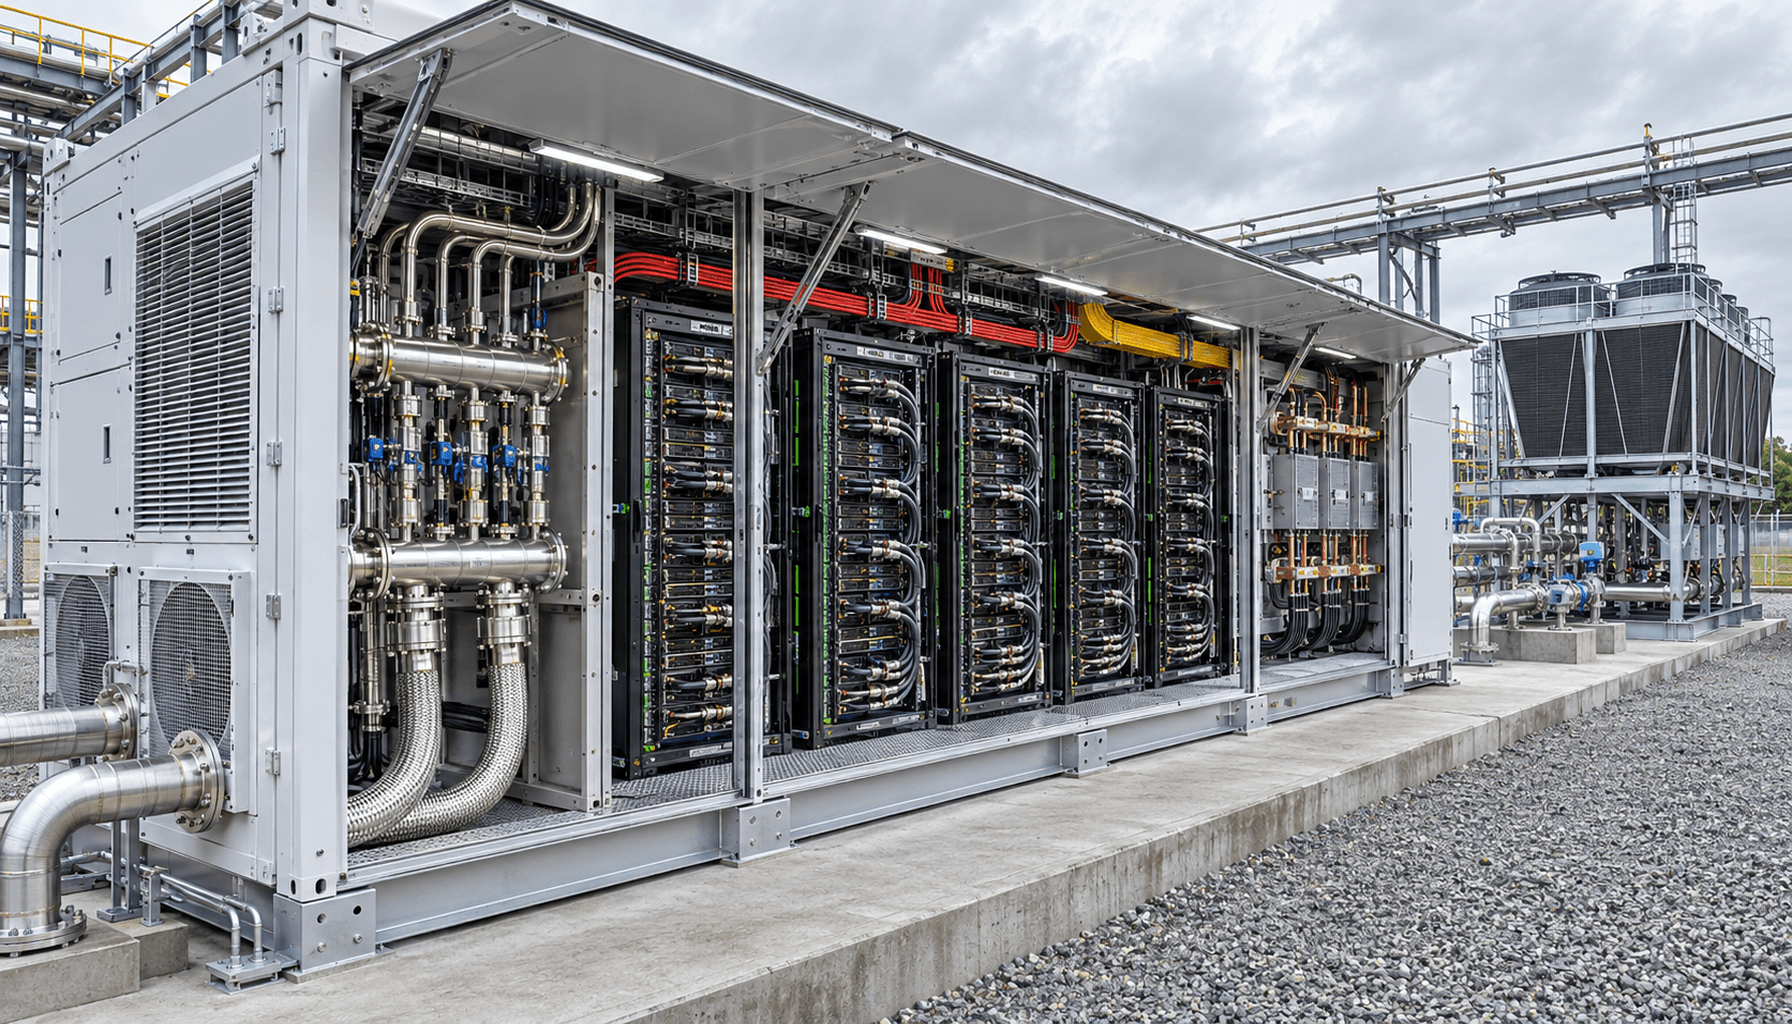
1. La triple contrainte hyperscale : Densité volumique, prédictibilité et Time-to-Token
Le déploiement des clusters d'entraînement pour modèles de fondation (LLM) et modèles multimodaux a mis en échec le modèle conventionnel de construction de centres de données « stick-built ». Les projets civils traditionnels subissent des goulets d'étranglement critiques : files d'attente d'interconnexion au réseau de transport électrique s'étalant sur 36 à 60 mois, lenteurs administratives d'urbanisme et pénurie sévère de main-d'œuvre spécialisée sur site. Parallèlement, l'introduction des super-puces telles que les Nvidia GB300 NVL72 et Vera Rubin NVL72 impose des densités thermomécaniques sans précédent, oscillant entre 120 kW et plus de 140 kW par châssis informatique. Les installations en dur historiques, conçues pour des charges moyennes de 8 à 15 kW par baie, sont structurellement incapables de dissiper ces flux thermiques localisés sans réingénierie lourde et prohibitive.
L'approche modulaire industrialisée déplace 85 % à 90 % de la fabrication structurelle, électrique et hydraulique directement sur les lignes de production en usine. Un module pré-usiné de 3,5 MW arrive sur site sous forme de skid ou de caisson renforcé prêt à l'emploi, intégrant nativement la distribution électrique, les collecteurs fluidiques et les interfaces réseau. Posée sur un simple radier en béton armé instrumenté, cette infrastructure modulaire compresse le cycle de déploiement global de plusieurs années à moins de quatre mois à partir de la viabilisation du terrain, réduisant considérablement la métrique « Time-to-Token » pour les fournisseurs de calcul intensif.
Validation de la portance du radier béton pour des charges statiques supérieures à 2 400 kg/m² au droit des baies NVL72.
Vérification des interfaces de raccordement d'énergie primaire et de secours en limite de propriété foncière.
Modélisation dynamique du temps de déploiement versus l'amortissement du capital GPU engagé.
2. Thermodynamique et mécanique des fluides : Refroidissement direct (DLC) en boucle fermée
Avec des enveloppes thermiques (TDP) dépassant 1 200 W à 1 500 W par socket de calcul, le refroidissement par air atteint ses limites physiques. L'extraction thermique d'une baie de 130 kW exigerait des débits volumiques d'air astronomiques, engendrant des puissances de ventilation parasites inacceptables, des niveaux acoustiques supérieurs à 90 dBA et un étranglement thermique (thermal throttling) systématique du silicium. La thermique des pods 3,5 MW repose sur une architecture Direct-to-Chip Liquid Cooling (DLC) en boucle fermée. Des Unités de Distribution de Liquide de Refroidissement (CDU) à vitesse variable font circuler un fluide caloporteur (eau déminéralisée ultra-pure traitée ou mélange eau/propylène glycol inhibé à 25/75) directement au travers de micro-canaux usinés sur des plaques froides (cold plates) en cuivre électrolytique fixées sur les GPU et CPU.
Le rejet thermique est géré par une topologie à double échangeur sans évaporation d'eau. La boucle primaire capture la chaleur avec une température d'alimentation d'eau (W-supply) calibrée entre 45 °C et 55 °C, autorisant une élévation de température delta T de 8 K à 12 K selon la relation thermodynamique Q = m_dot * Cp * delta T. Cette chaleur est transférée via des échangeurs à plaques brasées en acier inoxydable AISI 316L vers une boucle externe fermée couplée à des aéro-refroidisseurs adiabatiques secs (dry coolers). Cette configuration garantit un fonctionnement continu sans consommation d'eau (zéro WUE) et maintient la température de jonction critique T_j sous les 75 °C, assurant un PUE mécanique inférieur à 1,15, y compris sous des conditions climatiques extrêmes avec des températures de bulbe sec atteignant 42 °C.
Mesure de la résistivité diélectrique et contrôle microbiologique du fluide caloporteur dans la boucle primaire (conductivité < 10 µS/cm).
Étalonnage des vannes d'équilibrage dynamique indépendantes de la pression (PICV) sur chaque manifold de rack.
Vérification du maintien de T_j < 75 °C sur les accélérateurs sous charge synthétique LINPACK continue à 100 % de TDP.
3. Architecture électrique 3,5 MW : Distribution 380V HVDC, busways 48V et intégration DER
Pour délivrer 3,5 MW de puissance active dans une empreinte contrainte tout en minimisant les pertes par effet Joule (P_loss = R * I²), la chaîne cinématique électrique abandonne les schémas basse tension AC standards au profit de topologies optimisées. Le module intègre des transformateurs abaisseurs moyenne tension (13,8 kV / 34,5 kV vers 415 V / 480 V AC) couplés à des onduleurs centralisés à haut rendement ou directement à des bus continus 380V HVDC (Courant Continu Haute Tension, +/-190V bipolaire). Cette distribution supprime les conversions DC-AC-DC redondantes des alimentations sans interruption (ASI) classiques et permet un rendement de conversion global supérieur à 97,5 % de la moyenne tension jusqu'au cœur de calcul.
Au sein de chaque travée de calcul, des convertisseurs DC-DC abaisseurs alimentent des barres omnibus (busbars) 48V / 54V conformes au standard Open Compute Project (OCP) ORV3. Ce saut technologique réduit drastiquement les sections de cuivre requises et élimine les barres omnibus AC triphasées encombrantes. De plus, l'architecture d'entrée du pod modulaire est intrinsèquement compatible avec les ressources énergétiques distribuées (DER). Elle permet l'interconnexion synchrone de microturbines au gaz naturel, de piles à combustible à oxyde solide (SOFC) ou de futurs réacteurs modulaires de faible puissance (SMR) directement sur le bus DC ou AC moyenne tension, décorrélant la mise en service du cluster IA des délais imposés par les opérateurs de réseaux publics.
Contrôle de l'équilibrage des phases et analyse du taux de distorsion harmonique globale en courant (THDi < 3 %) à pleine charge.
Inspection thermographique des contacts de busbars 48V OCP ORV3 sous une densité de courant continue de 2 500 A.
Validation du temps de basculement transitoire source primaire vers DER (< 10 ms sans désynchronisation des GPU).
4. Ingénierie mécanique et alignement structural Nvidia DSX POD
L'intégrité structurelle des pods 3,5 MW découle d'une modélisation par éléments finis (FEA) rigoureuse, répondant aux exigences mécaniques du standard Nvidia DSX POD (Data Center Scale Computing Infrastructure). Les enveloppes extérieures adoptent des formats de conteneurs maritimes ISO 40/45 pieds renforcés ou des skids fermés spécifiques certifiés NEMA 4X / IP66, capables de résister aux atmosphères corrosives, aux infiltrations de particules fines et aux séismes de classe Seismic Zone 4. L'aménagement intérieur est conçu selon un couloir de maintenance ergonomique permettant l'extraction et l'insertion à chaud (hot-swap) des tiroirs de serveurs et des blocs de pompage de CDU.
L'interopérabilité hydraulique et électrique repose sur des normes strictes de connexion rapide. Les tiroirs de calcul intègrent des raccords sans égouttement à accouplement aveugle (blind-mate drip-free quick disconnects) conformes aux tolérances de désalignement axial de +/- 1,5 mm. La sécurité opérationnelle est assurée par un réseau de détection de fuite sous forme de cordons conducteurs adressables déployés sous chaque raccord critique et manifold, relié à des électrovannes d'isolement pneumatiques capables d'interrompre le débit volumique en moins de 150 millisecondes en cas de chute de pression différentielle (delta P) anormale.
Vérification de l'étanchéité mécanique de l'enveloppe par test de surpression différentielle positive (classe IP66).
Test d'endurance cyclique des raccords rapides blind-mate (50 cycles d'accouplement/désaccouplement sous pression sans déperdition de fluide).
Calibration du système d'isolement d'urgence milliseconde lors d'une simulation d'intrusion d'eau dans les bacs de rétention.
5. Analyse techno-économique : TCO, granularité modulaire et Edge d'inférence
D'un point de vue technico-économique, la préfabrication modulaire réduit l'intensité capitalistique (CapEx) par mégawatt informatique déployé de 20 % à 30 % par rapport aux constructions in-situ, tout en éliminant les risques de dépassement de budget liés aux aléas climatiques et de coordination de corps d'état sur les chantiers. La modularité en blocs de 3,5 MW permet aux opérateurs d'aligner précisément leurs dépenses de capital sur les allocations de puissance disponibles (poches de 5 MW à 20 MW) plutôt que d'immobiliser des centaines de millions d'euros dans des mégacampus sous-utilisés en attente de transformateurs élévateurs ou de livraisons de GPU échelonnées.
Cette agilité d'ingénierie prend tout son sens dans les architectures d'IA souveraine et les grappes d'inférence distribuée à faible latence. Positionnés à la périphérie des métropoles ou directement adossés à des nœuds d'ingestion de données massives (robotique industrielle, flottes de véhicules autonomes), ces pods fournissent une résilience de niveau Tier III sans exiger d'investissements fonciers massifs. La monétisation immédiate des mégawatts disponibles garantit un retour sur investissement accéléré et sécurise la rentabilité opérationnelle face au rythme d'obsolescence rapide des générations de puces IA.
Audit comparatif du coût total de possession (TCO) sur 5 ans intégrant le PUE cible de 1,12 versus 1,35 en solution standard.
Évaluation de la conformité réglementaire locale concernant l'implantation de structures modulaires préfabriquées.
Planification du modèle d'amortissement dynamique indexé sur la dépréciation des GPU sur 36 mois.
6. Protocoles de recette FAT/SAT, épreuves hydrauliques et mise en service
La fiabilité opérationnelle d'un data center modulaire repose sur la rigueur de ses tests de qualification en usine (Factory Acceptance Testing - FAT). Avant toute expédition sur convoi exceptionnel, chaque unité de 3,5 MW subit un rodage complet sur banc de charge thermique et électrique simulant 100 % de la charge informatique maximale. Des bancs de charge à dissipation liquide reproduisent fidèlement la signature enthalpique des baies GB300 NVL72, validant le comportement dynamique des CDU, la régulation des boucles PID de pompage et l'absence de points chauds sur l'ensemble de la distribution HVDC.
Le protocole d'assurance qualité fluidique impose une double épreuve mécanique des circuits hydrauliques. Les collecteurs subissent d'abord un test d'étanchéité moléculaire à l'hélium pour détecter les micro-fuites indétectables aux contrôles visuels, suivi d'une épreuve hydrostatique sous une pression équivalente à 1,5 fois la pression de service maximale autorisée (PSMA), soit généralement 10 à 12 bars pendant 4 heures. Une fois transporté sur site, le protocole de mise en service sur site (SAT) se limite au raccordement des brides de fluide secondaire, au verrouillage des barres omnibus moyenne tension et à l'interconnexion des liaisons fibres optiques MPO/MTP, permettant une mise en production en moins de 72 heures après déchargement.
Exécution du test d'étanchéité à l'hélium sous vide avec un seuil de sensibilité inférieur à 10⁻⁶ mbar·L/s.
Certification de l'épreuve hydrostatique à 1,5x la PSMA (12 bars) sans variation de pression sur une période de 4 heures.
Contrôle de conformité de l'interconnexion fibre optique trunk MPO-432 (perte d'insertion totale < 0,35 dB par canal).
Approvisionnement et support technique
Pour les fiches techniques, les topologies d'alimentation sur mesure ou les devis de gros, contactez les ingénieurs HEFENGQI.