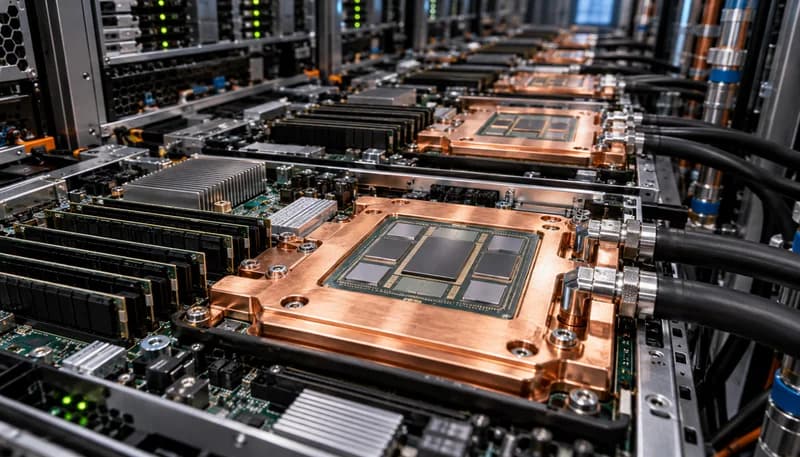
1. Le plafond de réticule monolithique : impératifs économiques et physiques de la désagrégation 2.5D/3D
Durant cinq décennies, la loi de Moore s'est incarnée dans la mise à l'échelle monolithique des puces sur silicium brut. Cependant, la convergence des charges d'entraînement de modèles d'IA et de calcul intensif (HPC) a précipité l'industrie contre le mur physique de la limite de champ du réticule lithographique, standardisée à environ 858 mm² pour les systèmes DUV et EUV conventionnels. Au-delà de cette frontière dimensionnelle, la fabrication d'une puce unique devient géométriquement impossible sans recourir à des techniques complexes de raccordement de masques (stitching). Simultanément, la loi de Poisson et le modèle de rendement de Murphy dictent une dégradation exponentielle de la viabilité économique : à mesure que la surface du dé augmente, la probabilité de défauts critiques de cristallographie ou de particules sur galette s'accroît, faisant chuter dramatiquement le rendement par tranche (wafer yield). Les processeurs monolithiques modernes de plus de 700 mm² présentent des coûts marginaux insoutenables, exacerbés par le coût surfacique astronomique des nœuds nanométriques avancés (N3 et N2).
Pour briser ce goulot d'étranglement physique et économique, l'architecture des microprocesseurs de serveurs s'est convertie au paradigme des puces partitionnées, ou 'chiplets'. Cette approche désagrège les fonctions du système sur puce (SoC) en modules distincts, optimisés pour des profils technologiques hétérogènes. Les cœurs de calcul compute-intensive, saturés de logique haute performance sensible à l'échelle, sont gravés sur les nœuds les plus fins (3 nm ou GAAFET 2 nm). En revanche, les blocs de contrôle d'E/S (PCIe Gen 6/CXL 3.1) et les contrôleurs de mémoire analogiques, qui ne bénéficient pas de la réduction d'échelle volumétrique en raison des limites de claquage diélectrique et de l'encombrement des plots de contact, sont déportés sur des nœuds matures hautement rentabilisés (6 nm, 12 nm ou 16 nm FinFET). Les couches de cache de dernier niveau (LLC) et les piles de mémoire à haute bande passante (HBM3e/HBM4) sont intégrées via des substrats 2.5D (silicon interposer, ponts intégrés de type EMIB) ou empilées verticalement en 3D via des liaisons directes cuivre-cuivre (hybrid bonding). Cette modularité restaure une rentabilité de production massive tout en quadruplant la surface totale de silicium effectif sous un même dissipateur thermique.
Dépassement du plafond de réticule standard (858 mm²) par modularisation en blocs fonctionnels indépendants.
Partitionnement nœud avancé (3 nm pour le calcul pur) vs nœud mature (7-12 nm pour I/O analogique et CXL).
Rétablissement du rendement de production global au-delà de 85% par tranche grâce à des dies unitaires restreints (<150 mm²).
2. Architectures d'interconnexion Die-to-Die : UCIe, latence sub-nanoseconde et routage sur interposeur
L'effondrement des limites du silicium monolithique au profit de désagrégations multi-dies requiert des bus d'interconnexion 'puce-à-puce' (die-to-die ou D2D) capables de répliquer les débits internes du silicium natif. Le standard ouvert Universal Chiplet Interconnect Express (UCIe) s'est imposé comme le protocole de référence, unifiant les couches physiques et logiques pour standardiser l'interopérabilité entre fonderies et blocs d'adresses hétérogènes. UCIe définit deux profils d'intégration : le packaging standard à base de substrats organiques multicouches, et le packaging avancé exploitant des interposeurs de silicium passifs ou actifs (comme le CoWoS de TSMC), des ponts de silicium locaux (EMIB d'Intel) ou des architectures Foveros. La couche physique avancée d'UCIe exploite des micro-bosses (microbumps) d'un pas (pitch) de 25 à 45 µm, migrant vers le collage hybride direct à pas sub-10 µm, éliminant quasi totalement la capacité parasite associée aux piliers de soudure traditionnels.
Ces interconnexions ultra-denses imposent des métriques de transmission sans compromis : une bande passante linéaire en bordure de puce (shoreline bandwidth density) comprise entre 1,3 et 3,2 Tbps par millimètre de périmètre, tout en limitant la consommation énergétique à des seuils inférieurs à 0,5 picojoule par bit (pJ/bit). Le routage des pistes à ultra-haute densité au sein de l'interposeur de silicium requiert une impédance contrôlée rigoureuse pour les signaux asymétriques non blindés (single-ended NRZ) cadencés jusqu'à 32 Gbps par voie. La diaphonie capacitive (crosstalk) entre pistes adjacentes espacées de moins de 2 µm est contenue par l'alternance de plans de masse stricts et de techniques de codage de bus spécifiques. Sur le plan de la latence, la traversée de la couche physique et du pont d'interconnexion n'excède pas 2 nanosecondes aller-retour, maintenant ainsi la cohérence des caches et une topologie NUMA plate transparente pour le système d'exploitation et les bibliothèques de calcul parallèle (NCCL, MPI).
Densité de bande passante shoreline supérieure à 2 Tbps/mm avec un budget énergétique visé <0,5 pJ/bit.
Tolérance de gigue et compensation de skew multi-canaux garantissant une latence D2D sub-2 ns.
Standardisation sur spécifications UCIe 1.1/2.0 avec compatibilité native pour les protocoles PCIe 6.0 et CXL 3.1.
3. Régulation de tension sub-volt : maîtrise des transitoires di/dt via architectures 48V-PoL et IVR
L'intégration de centaines de cœurs de calcul et de moteurs tensoriels matriciels sur un boîtier unifié pousse les processeurs vers des niveaux de consommation électrique colossaux, oscillant entre 700 W et plus de 1500 W par socket. Parallèlement, l'alimentation des transistors N3/FinFET et N2/GAAFET s'effectue sous des tensions nominales de cœur (Vcore) extrêmement basses, comprises entre 0,65 V et 0,85 V. Cette combinaison d'une puissance accrue et d'un Vcore sub-volt génère des courants continus atteignant 1000 à 2000 A par socket. Le défi le plus critique pour les ingénieurs d'alimentation réside dans les transitoires de charge massifs (di/dt) induits par le passage quasi instantané d'états de repos (C-states) à des phases d'exécution d'instructions vectorielles SIMD/matricielles complètes. Les taux de montée en courant dépassent désormais 1500 A/µs, menaçant de provoquer des chutes de tension par résonance L·di/dt (voltage droop) qui franchissent les tolérances de bruit dynamique de ±30 mV, risquant d'induire des corruptions silencieuses de données ou des arrêts de protection d'urgence.
Pour juguler ce phénomène, le réseau de distribution de puissance (PDN) abandonne la conversion directe 12 V vers Vcore au profit d'une topologie étagée débutant à 48V/54V au niveau du fond de panier de la baie. L'abaissement vers le point de charge (Point-of-Load - PoL) s'organise selon une architecture à deux étages : un convertisseur de bus intermédiaire (IBC) ou des régulateurs non isolés hybrides commutés abattent le bus 48 V à une tension intermédiaire (typiquement 5 V à 12 V), relayés par des régulateurs de tension multiphases intégrés (Integrated Voltage Regulators - IVR) ou des puces de puissance montées en face arrière de la carte mère. L'horizon technologique ultime repose sur l'alimentation par la face arrière (Backside Power Delivery Network - BSPDN) et la livraison de puissance verticale (Vertical Power Delivery - VPD). Dans ce schéma, les modules de régulation sont placés directement sous l'interposeur en utilisant des micro-condensateurs à tranchée profonde (Deep Trench Capacitors - DTC), réduisant l'inductance de boucle parasite à moins de quelques picohenrys et maintenant l'impédance du PDN sous les 0,1 mΩ sur une bande passante fréquentielle s'étendant jusqu'à 100 MHz.
Régulation Vcore à 0,75V avec enveloppe dynamique de tension contenue à ±3% sous transitoires di/dt >1500 A/µs.
Déploiement de régulateurs verticaux (VPD) réduisant l'inductance parasite de boucle PDN à <5 pH.
Intégration de condensateurs DTC silicium haute densité pour suppression des résonances d'impédance haute fréquence.
4. Défis thermiques microscopiques : microcanaux pour refroidissement direct et dégradation des TIM
L'agencement hétérogène des architectures chiplets pulvérise le paradigme d'une dissipation thermique homogène sur la surface de l'emballage. Alors qu'un processeur monolithique présentait un profil thermique étalé, les boîtiers multi-dies concentrent la puissance thermique dans les cœurs de calcul ultra-denses, tandis que les matrices I/O et les piles HBM affichent des densités de pertes bien plus modérées. Cette hétérogénéité génère des points chauds microscopiques (hotspots) où le flux thermique localisé franchit allègrement les 100 W/cm², culminant parfois au-delà de 300 W/cm² sur les surfaces de calcul vectoriel. La disparité des coefficients de dilatation thermique (CTE) entre le silicium, le substrat organique, le joint d'étanchéité et le répartiteur de chaleur intégré (IHS) engendre des contraintes thermo-mécaniques considérables, induisant des déformations de gauchissement (warpage) capables d'arracher les joints de soudure sous-jacents lors des cycles thermiques répétitifs.
Face à ces flux d'énergie, le refroidissement à air conventionnel assisté de caloducs est totalement disqualifié en raison de la limite d'ébullition et de la résistance thermique convective incompressible de l'air. L'ingénierie se focalise sur les plaques froides à refroidissement liquide direct (Direct-to-Chip ou D2C) intégrant des réseaux de microcanaux usinés directement au droit des puces de calcul. Ces microcanaux, présentant des largeurs inférieures à 50 µm pour des ratios d'aspect supérieurs à 10:1, optimisent la couche limite hydraulique et maximisent la surface d'échange convectif sous des débits turbulents contrôlés. Parallèlement, l'interface thermique primaire (TIM1/TIM1.5) constitue la résistance thermique dominante du système. L'utilisation d'alliages métalliques liquides (GaInSn) ou de pâtes d'argent fritté remplace les graisses thermiques siliconées classiques. Cependant, ces matériaux imposent des défis majeurs de confinement physique : l'effet d'expulsion par pompage thermique (pump-out effect) et les réactions de corrosion intermétallique avec le nickelage du dissipateur imposent des barrières de passivation étanches pour garantir une stabilité opérationnelle sur un cycle de vie de 5 à 7 ans en datacenter.
Extraction de flux thermiques localisés excédant 150 W/cm² via des plaques froides microcanal optimisées en perte de charge.
Substitution des TIM polymères par des alliages métalliques liquides à conductivité >30 W/m·K avec barrières anti-migration.
Mitigation des contraintes thermo-mécaniques (CTE mismatch) limitant la déformation de coplanarité du boîtier à <50 µm.
5. Densification des plates-formes et des baies : barres omnibus 54V et contraintes mécaniques ORV3
La concentration de puissance induite par les nœuds de calcul chiplets déstabilise la mécanique et l'électromécanique des serveurs au format rackable traditionnel. Dans le standard Open Rack Version 3 (ORV3) promu par l'Open Compute Project (OCP), l'architecture de fond de panier historique à 12 V a été déclarée obsolète : véhiculer 100 kW sous 12 V nécessiterait des sections de cuivre dépassant les capacités de charge structurelle des bâtis et entraînerait des pertes Joule (I²R) prohibitives. La norme s'est donc verrouillée sur une distribution centralisée par barre omnibus (busbar) rigide en cuivre massif à 48V/54V DC, circulant verticalement à l'arrière du rack. Cette élévation de tension réduit l'intensité d'un facteur 4,5 pour une puissance équivalente, divisant les pertes par effet Joule par plus de 20 et autorisant des sections de conducteurs compatibles avec des serveurs modulaires extractibles à chaud sans outillage lourd.
La mise en œuvre de ces tiroirs de calcul de haute densité pose des contraintes mécaniques sévères. Chaque châssis de calcul 1OU ou 2OU peut désormais peser entre 80 et 140 kg en raison de la densité massique du cuivre des barres internes, des collecteurs hydrauliques et des répartiteurs thermiques massifs. Les connexions aveugles (blind-mate) doivent assurer un alignement micrométrique simultané pour le connecteur d'alimentation 54V (capable de délivrer plus de 100 A continus) et les raccords rapides hydrauliques anti-goutte (quick-disconnects - QD). La pression de contact mécanique requise sur les sockets de processeurs à très grand nombre de broches (LGA à plus de 7500 contacts) induit des forces de placage supérieures à 600-800 N par socket. Les cartes mères doivent dès lors intégrer des plaques de renfort arrière (bolster plates) en acier trempé de 4 à 6 mm d'épaisseur et des empilements de circuits imprimés de 24 à 32 couches basés sur des diélectriques ultra-faibles pertes (comme le Megtron 7 ou 8) pour empêcher tout fléchissement de la carte sous contrainte mécanique et thermique continue.
Alimentation de baie standardisée sur busbar vertical 48V/54V ORV3 avec étagère d'alimentation (Power Shelf) centralisée.
Tolérance d'alignement des raccords aveugles (blind-mate fluidique et électrique) calibrée à ±0,75 mm sur rails renforcés.
Rigidification structurelle des PCB (30+ couches) par plaques de renfort pour supporter des forces d'insertion socket >700 N.
6. Ingénierie des infrastructures de salle blanche : reconversion pour charges liquides de 60 kW à 120 kW
L'irruption des architectures serveurs basées sur les chiplets déclenche une onde de choc au niveau des infrastructures de soutien des installations hyperscale existantes (brownfield). Les salles informatiques traditionnelles, conçues pour une enveloppe de 10 kW à 15 kW par baie avec confinement d'allée chaude ou froide assisté par des ventilo-convecteurs de salle blanche (CRAH), se révèlent incapables d'évacuer la charge thermique volumique des serveurs chiplets, qui projette la consommation par baie entre 60 kW et plus de 120 kW. La densification électrique impose d'intégrer des étagères d'alimentation (Power Shelves) dédiées, composées de blocs d'alimentation (PSU) certifiés Titanium présentant des rendements de conversion alternatif/continu supérieurs à 96,5 %, tout en gérant le facteur de puissance et les harmoniques d'ordre supérieur injectées sur le réseau haute tension de l'exploitant.
Sur le plan hydraulique, cette transformation requiert le déploiement d'unités de distribution de refroidissement (Cooling Distribution Units - CDU) en pied de rangée ou intégrées au rack, équipées d'échangeurs de chaleur à plaques en acier inoxydable et de pompes redondantes N+1 régulées par variateurs de fréquence. L'architecture sépare hermétiquement la boucle primaire (côté installation/tours de refroidissement) de la boucle secondaire de distribution technologique (TCS) qui irrigue directement les processeurs. L'eau de la boucle TCS doit faire l'objet d'un monitoring physico-chimique continu (filtration particulaire inférieure à 50 µm, pH stabilisé entre 7,5 et 8,5, teneur en oxygène dissous régulée et injection de biocides non oxydants) pour prévenir la corrosion galvanique et l'encrassement biologique. En exploitant la classe thermique W4 de l'ASHRAE, autorisant des températures d'eau d'alimentation au collecteur allant jusqu'à 45 °C, l'infrastructure s'affranchit totalement des groupes frigorifiques à compression mécanique (chillers) au profit d'un refroidissement direct par aéroréfrigérants adiabatiques (dry coolers), permettant d'atteindre un indicateur d'efficacité énergétique (PUE) annuel inférieur à 1,12 sous une densité de puissance sans précédent.
Remplacement des infrastructures aérauliques par des CDU hydrauliques secondaires supportant 60 à 120 kW par baie.
Exploitation de la classe ASHRAE W4 (eau d'entrée jusqu'à 45 °C) pour un fonctionnement 100% dry-cooler et PUE <1,12.
Gestion drastique de la chimie de l'eau TCS : conductivité <10 µS/cm, filtration 5-50 µm et inhibition galvanique active.
Approvisionnement et support technique
Pour les fiches techniques, les topologies d'alimentation sur mesure ou les devis de gros, contactez les ingénieurs HEFENGQI.