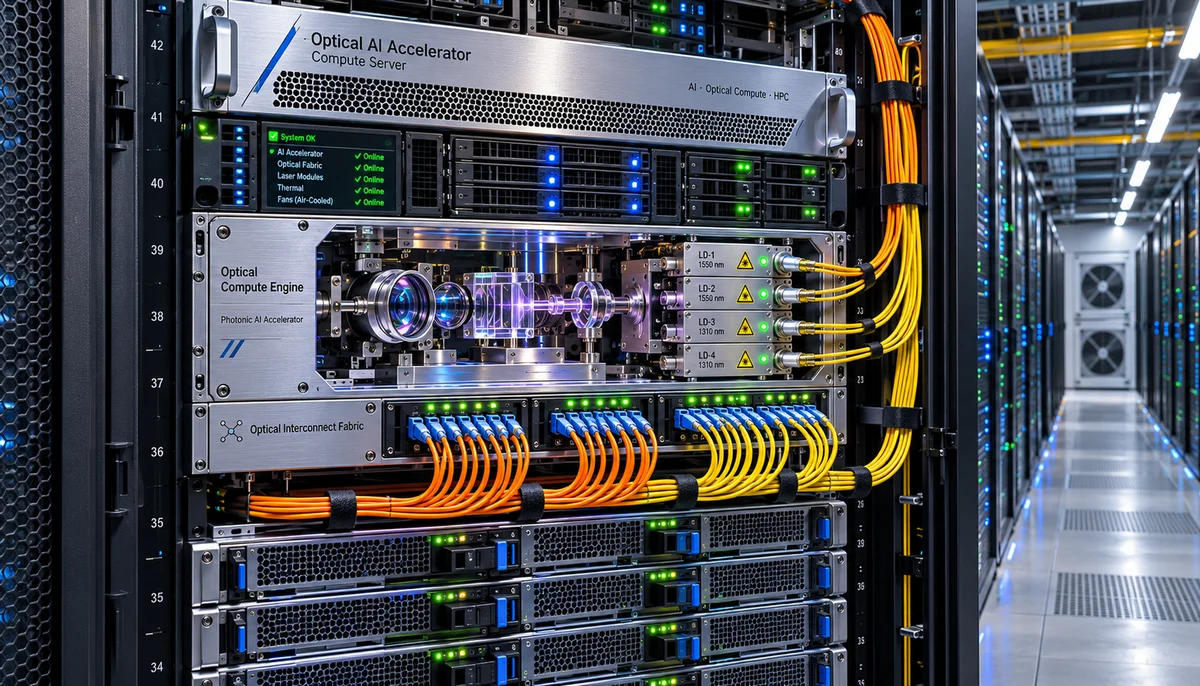
Física de la Multiplicación Matricial: Fotones Frente a Electrones en Operaciones GEMM
En la computación de semiconductores de silicio convencional, las operaciones de multiplicación matricial generalizada (GEMM) se ejecutan mediante la conmutación de miles de millones de transistores FinFET o nanosheet de 3 nm y 2 nm. Este proceso está intrínsecamente penalizado por la capacitancia parásita de conmutación, la resistencia de las líneas metálicas de interconexión y la consecuente disipación térmica, que sitúa el coste energético de las operaciones de precisión reducida (FP8 o INT8) entre 1 y 3 picojulios por operación Multiply-Accumulate (MAC). A medida que las matrices de ponderaciones de los modelos masivos de lenguaje superan los cientos de miles de millones de parámetros, el transporte de electrones a través del silicio genera una barrera física insalvable de densidad de potencia por milímetro cuadrado.
Por el contrario, los aceleradores de cálculo óptico ejecutan las operaciones GEMM en el dominio analógico electromagnético de la luz. La información numérica se modula linealmente sobre haces láser coherentes distribuidos mediante multiplexación por división de longitud de onda (WDM) e interferómetros Mach-Zehnder (MZI) o matrices de microanillos resonadores integrados en fotónica de silicio. La multiplicación se efectúa de forma pasiva a través de atenuadores o moduladores ópticos, mientras que la suma se produce de forma instantánea e inherente mediante interferencia constructiva o superposición espectral en fotodetectores balanceados. Este flujo computacional a la velocidad de la luz disipa calor residual prácticamente nulo en el núcleo matricial, recortando el coste energético a umbrales sub-0,1 pJ/MAC.
Eficiencia energética del núcleo matricial fotónico: menor a 0,1 pJ por operación MAC frente a 1-3 pJ/MAC en lógica digital CMOS de vanguardia.
Procesamiento masivo pasivo mediante multiplexación WDM y elementos ópticos difractivos que eliminan la latencia de conmutación de compuertas lógicas.
Topología de Inferencia Desagregada: Separación Rigurosa de Prefill y Decode
La ejecución de modelos fundacionales presenta una asimetría matemática fundamental entre sus fases operativas. La fase de prefill o procesamiento del prompt se caracteriza por una altísima intensidad aritmética, ya que cada peso del modelo se reutiliza a lo largo de miles de tokens de entrada simultáneos, convirtiéndose en un problema fuertemente acotado por la capacidad de cálculo bruto. En contraste, la fase de decode o generación autorregresiva token a token es estrictamente secuencial y está limitada por el ancho de banda de la memoria de alto ancho de banda (HBM), requiriendo un constante trasvase de ponderaciones desde la memoria dinámica con una intensidad aritmética extremadamente baja.
La arquitectura desagregada desacopla físicamente ambas fases en clústeres especializados conectados mediante redes RDMA sobre Ethernet Convergente (RoCEv2) o InfiniBand. Los motores fotónicos, como el Lumai Iris Nova probado en las iniciativas del Advanced Research and Invention Agency (ARIA) del Reino Unido, asumen el volumen crítico del prefill para ventanas de contexto de 32k a más de 1M de tokens, proyectando las capas lineales de atención y feed-forward ópticamente. Una vez generado el KV cache, este se transfiere mediante DMA directo entre clústeres hacia granjas de GPU y ASIC optimizadas exclusivamente para el bucle de decode, maximizando la utilización del hardware y reduciendo el Time-to-First-Token (TTFT).
Desacoplamiento funcional total gestionado nativamente por motores de inferencia como vLLM (vía Chunked Prefill y PagedAttention), SGLang y KServe.
Transferencia de tensores de KV cache a través de tejidos RoCEv2/InfiniBand de baja latencia con latencias de conmutación por debajo de los microsegundos.
Presupuestos de Potencia Eléctrica y Compatibilidad con Refrigeración por Aire
El despliegue de infraestructuras de inteligencia artificial en centros de datos a hiperescala se enfrenta al agotamiento de la capacidad de las subestaciones eléctricas y a las restricciones de densidad de los bastidores convencionales. Mientras que los pods de supercomputación basados enteramente en GPU líquidas demandan densidades de entre 60 kW y más de 100 kW por rack, las salas de servidores empresariales existentes están diseñadas para tolerar envelopes térmicos de entre 10 kW y 20 kW por bastidor bajo estándares de circulación de aire convencionales.
Los sistemas de aceleración óptica implementan una arquitectura electro-óptica híbrida donde la matriz óptica pasiva se encarga de las multiplicaciones matriciales lineales, dejando las funciones no lineales (como Softmax, SiLU, LayerNorm) y la lógica de control a microcontroladores digitales estándar y bloques SRAM de bajo consumo. Gracias a la ausencia de densidades térmicas extremas en el módulo óptico, un chasis acelerador fotónico de 2U o 4U opera con un consumo total estabilizado de solo 1,5 kW a 2,5 kW. Esto permite una inserción directa en racks EIA-310 de 19 pulgadas compatibles con pasillo frío/caliente según los lineamientos térmicos ASHRAE A1 y A2, eliminando la necesidad de reconvertir las salas con costosas unidades de distribución de refrigerante (CDU).
Consumo por chasis de cálculo óptico acotado a 1,5 kW - 2,5 kW en factores de forma estándar de 2U/4U.
Compatibilidad total con infraestructuras existentes de refrigeración por aire N+1 conforme a especificaciones térmicas ASHRAE A1/A2.
Cadena de Suministro Optoelectrónica, Fiabilidad e Integridad de Señal
La viabilidad industrial de los aceleradores fotónicos radica en el aprovechamiento de la madurez de la cadena de suministro de telecomunicaciones y transceptores ópticos para datacom. La integración de emisores láser de retroalimentación distribuida (DFB), moduladores de electroabsorción (EAM) y transceptores estándares en factores de forma OSFP y QSFP-DD operando en las ventanas telecom de 1310 nm (banda O) y 1550 nm (banda C) garantiza costes de fabricación decrecientes y un volumen de producción a escala de obleas de silicio de 300 mm.
No obstante, el transporte analógico de señales introduce retos críticos en cuanto a deriva térmica y relación señal/ruido (SNR). Para garantizar una precisión matemática equivalente a INT8 y FP8, las plataformas incorporan circuitos de control interferométrico de bucle cerrado asistidos por microenfriadores termoeléctricos (TEC), manteniendo la estabilidad de la longitud de onda láser con derivas inferiores a 0,01 nm por grado Celsius en rangos industriales de 10 a 45 grados. Asimismo, el uso de recubrimientos antirreflectantes de vanguardia minimiza las pérdidas de inserción óptica en el acoplamiento fibra-guía de onda, preservando la fidelidad de los pesos sin degradación de la convergencia del modelo.
Control activo de deriva térmica inferior a 0,01 nm/°C mediante TEC y lazos de fase cerrados para preservar la precisión numérica INT8/FP8.
Utilización de componentes estandarizados de la industria óptica datacom (láseres DFB, moduladores EAM y factores de forma OSFP/QSFP-DD).
TCO, Reducción de Huella Hídrica y Recuperación de Potencia Varada
La integración de aceleradores ópticos en la inferencia desagregada permite a los operadores de hiperescala recuperar la potencia varada resultante de los picos de consumo de las GPU. Al descargar entre el 60% y el 70% del consumo energético del prefill hacia motores fotónicos de ultra-baja potencia, un centro de datos con limitaciones de acometida eléctrica fija puede triplicar la concurrencia de prompts procesados sin necesidad de solicitar capacidad adicional a la red de distribución eléctrica regional.
Desde la perspectiva de la sostenibilidad operativa, la eliminación de intercambiadores de calor líquido-líquido y torres de enfriamiento evaporativo para los racks de prefill reduce drásticamente el Índice de Eficacia en el Uso del Agua (WUE) a valores cercanos a cero absoluto en dichos nodos. Pruebas de campo en entornos como el Scaling Inference Lab de ARIA demuestran tiempos medios entre fallos (MTBF) que superan las 100.000 horas operativas continuas, orquestando cargas de trabajo complejas de manera transparente mediante Kubernetes y extensiones de KServe.
Triplicación de la densidad de procesamiento de prompts dentro de los límites de capacidad eléctrica (MW) ya asignados a la instalación.
Reducción directa del WUE y PUE al prescindir de circuitos de evaporación de agua y chillers mecánicos dedicados para los nodos de cálculo óptico.
Adquisiciones e ingeniería de soporte
Para fichas técnicas, proyectos a medida o presupuestos de exportación por volumen, comuníquese con los ingenieros de HEFENGQI.