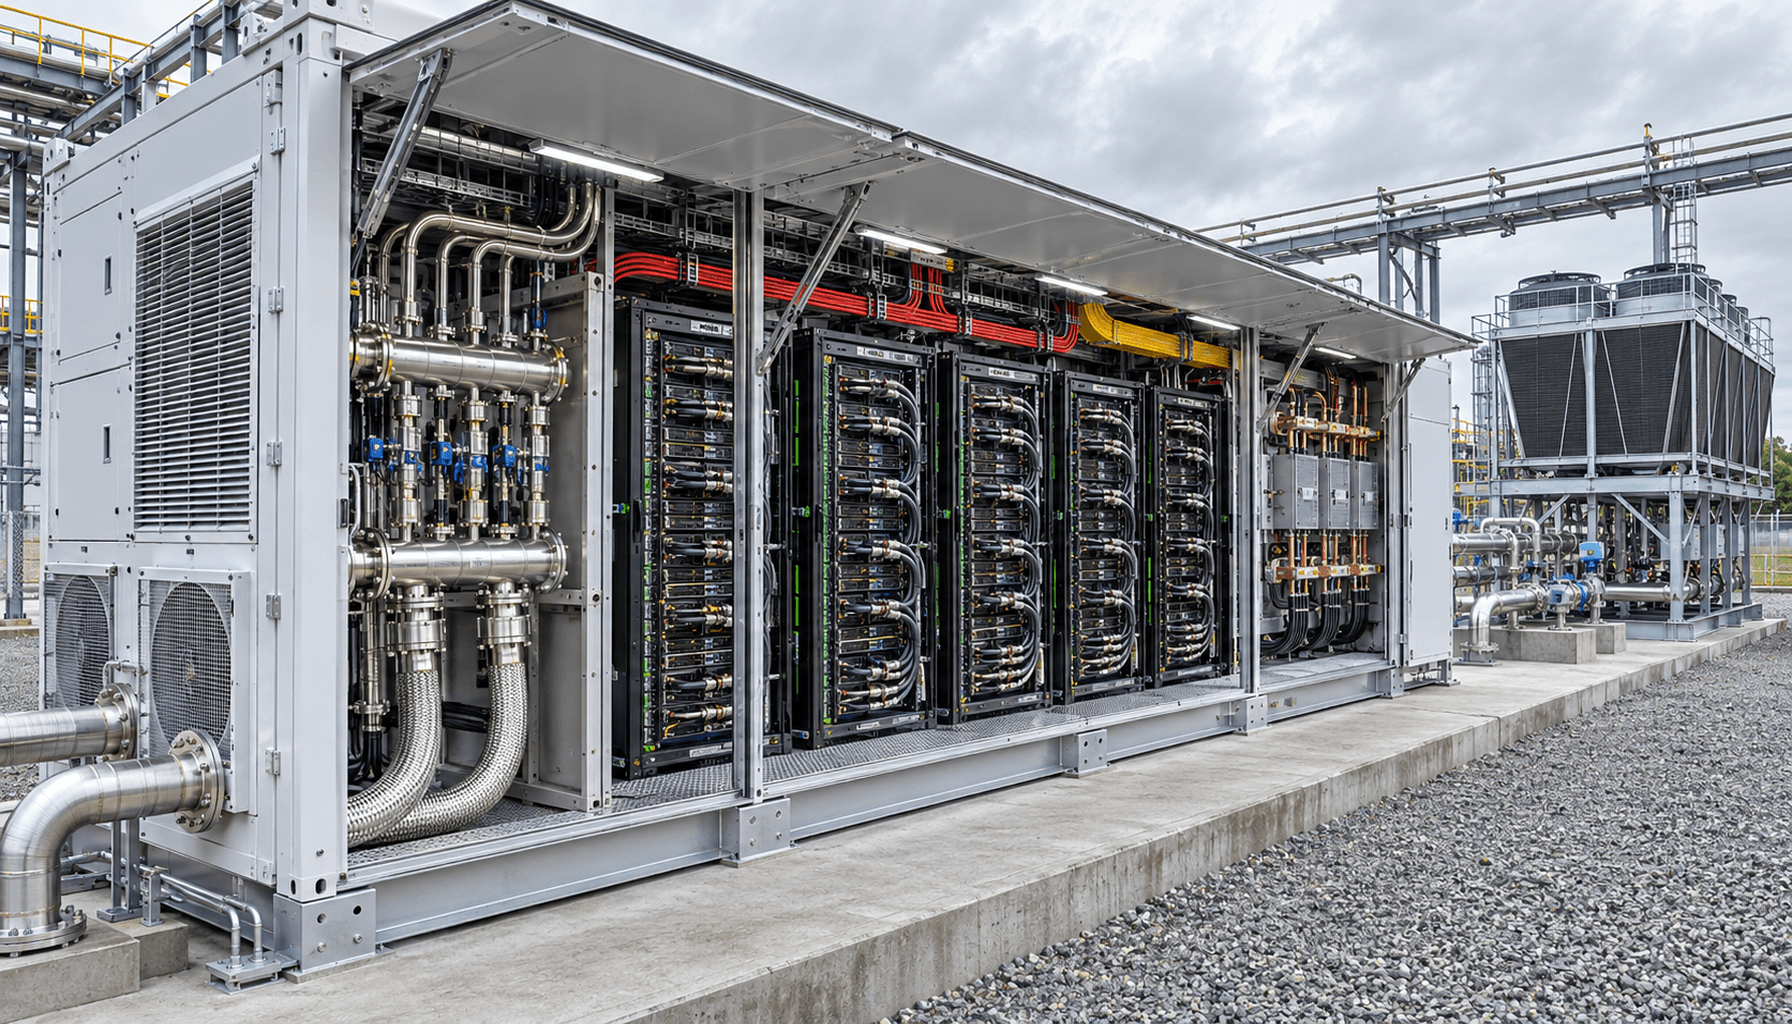
1. El Triple Cuello de Botella en IA a Hiperescala: Potencia, Predictibilidad y Time-to-Token
El desarrollo y puesta en marcha de infraestructura física para cómputo de inteligencia artificial a escala de gigavatios se enfrenta a un choque estructural contra la metodología constructiva tradicional de obra civil (stick-built). Los plazos de conexión a las redes de transporte de alta tensión exceden actualmente los 36 a 60 meses en los principales polos de hiperescala globales, exacerbados por cuellos de botella en la permisología municipal, escasez de transformadores de potencia y limitaciones de mano de obra especializada en sitio. Cuando se proyectan infraestructuras destinadas a plataformas de procesamiento denso como Nvidia GB300 NVL72 o arquitecturas Vera Rubin, las densidades térmicas y eléctricas alcanzan valores de entre 120 kW y 140 kW por rack, pulverizando los supuestos de diseño de salas blancas convencionales basadas en suelo técnico y flujo de aire presurizado.
Frente a este desfase temporal y térmico, los centros de datos modulares prefabricados en fábrica (Prefabricated Modular Data Centers, PMDC) transforman radicalmente el modelo de ejecución. Al trasladar entre el 85% y el 90% del ensamblaje mecánico, estructural y electrotécnico a líneas de producción controladas con estándares de calidad aeroespacial e industrial, se desacopla la fabricación del centro de cómputo del acondicionamiento civil del emplazamiento. Una plataforma modular de 3.5 MW puede completarse, probarse bajo carga sintética y despacharse lista para posarse sobre zapatas de hormigón armado estándar, reduciendo el horizonte de despliegue a una ventana de pocas semanas tras la disponibilidad de energía en sitio, acelerando radicalmente la métrica crítica del sector: el Time-to-First-Token.
Verificación de tolerancias estructurales de zapatas de hormigón (planitud superficial de ±3 mm bajo norma DIN 18202).
Auditoría de cumplimiento sísmico regional del skid estructural (resistencia a aceleraciones espectrales Ss > 2.0g).
Inspección dimensional de interfaces mecánicas y pasamuros de interconexión entre módulos acoplables.
Certificación de transporte pesado y rutas logísticas autorizadas para pesos brutos superiores a 35 toneladas métricas por módulo.
2. Termodinámica y Mecánica de Fluidos: Refrigeración Líquida Directa (DLC) en Circuito Cerrado
La disipación térmica de los aceleradores de cómputo contemporáneos ha superado la capacidad específica del aire como vector refrigerante. Con paquetes de silicio que superan holgadamente los 1000 W a 1500 W de potencia de diseño térmico (TDP), la transferencia de calor por convección forzada de aire exigiría gradientes de presión y caudales másicos acústicamente destructivos y térmicamente ineficientes ($Q = \dot{m} C_p \Delta T$). La arquitectura modular de 3.5 MW adopta una topología de refrigeración líquida directa al chip (Direct-to-Chip Liquid Cooling, DLC) en circuito cerrado, donde Unidades de Distribución de Refrigerante (CDU) bombean una mezcla estandarizada de agua desionizada tratada con propilenglicol inhibido (25-30% PG) a través de microcanales de cobre de alta conductividad acoplados térmicamente a GPUs, CPUs y conmutadores NVSwitch.
El ciclo termodinámico implementa un rechazo de calor dual desacoplado mediante intercambiadores de calor de placas soldadas (Plate Heat Exchangers, PHE) de acero inoxidable 316L. El bucle primario interno opera con temperaturas de suministro de agua (FWS/W4) de 45 °C a 55 °C, capturando el calor latente y sensible con elevaciones de temperatura $\Delta T$ controladas entre 8 °C y 12 °C. El calor es transferido al bucle secundario externo, conectado a aerotermos adiabáticos de circuito seco (Dry Coolers) sin consumo consuntivo de agua ni plumas de evaporación. Esta configuración permite alcanzar de manera sostenida factores de eficacia en el uso de la potencia (PUE) inferiores a 1.15 en climas con temperaturas de bulbo seco de hasta 42 °C, asegurando que la temperatura de unión de las matrices de silicio ($T_j$) no sobrepase el umbral crítico de 75 °C bajo cargas de entrenamiento continuo al 100%.
Calibración de caudalímetros electromagnéticos en bucles primarios y secundarios con precisión nominal de ±0.5%.
Comprobación de la química del refrigerante: conductividad < 10 µS/cm, pH estabilizado entre 7.5 y 8.5, y biocida no oxidante activo.
Validación de pérdida de carga manométrica hidráulica del rack según curvas de bombeo nominales (presión diferencial $\Delta P \le 1.8\text{ bar}$).
Monitorización continua de punto de rocío y activación de algoritmos de prevención de condensación superficial en líneas de líquido frío.
3. Topología de Distribución Eléctrica: Bloque de 3.5 MW, HVDC y Barras Colectoras OCP ORV3
La densidad de un bloque modular de 3.5 MW impone desafíos extremos en la gestión de pérdidas óhmicas y armónicos en la cadena de distribución eléctrica. La alimentación de entrada se procesa mediante subestaciones compactas integradas compuestas por celdas de media tensión aisladas en gas (GIS) y transformadores reductores secos o de éster vegetal de 13.8 kV / 34.5 kV a baja tensión. Para mitigar las caídas de tensión y las pérdidas Joule ($P_{\text{loss}} = I^2 R$) asociadas a corrientes masivas en corriente alterna convencional, las arquitecturas más avanzadas migran hacia barras de corriente continua de alta tensión (380V HVDC o arquitectura bipolar de $\pm$190V DC) o directamente a distribución de 480V/415V AC trifásica hacia sistemas de alimentación ininterrumpida (UPS) modulares de topología estática sin transformador con eficiencia de doble conversión superior al 97.5%.
En el interior de la bahía de racks, la energía se acopla a las especificaciones del estándar Open Compute Project (OCP) Open Rack Standard V3 (ORV3). Sistemas de barras colectoras verticales de 48V/54V de cobre electrolítico de alta pureza alimentan directamente los estantes de cómputo, alimentadas por fuentes rectificadoras integradas (PSU) con balanceo activo de corriente en configuraciones de redundancia $N+1$ o $N+2$. Adicionalmente, el diseño eléctrico modular incorpora bahías de sincronización paralela directa capaces de hibridar la entrada de red con recursos energéticos distribuidos (DERs), tales como microturbinas de gas natural, celdas de combustible de óxido sólido (SOFC) o microrreactores modulares (SMRs), permitiendo monetizar bloques de potencia 'varada' de forma previa a la energización de la subestación principal.
Termografía infrarroja bajo carga nominal del 100% en puntos de empalme de embarrados y barras colectoras OCP ORV3 (gradiente térmico $\Delta T \le 15\text{ K}$).
Medición de distorsión armónica total de corriente ($THD_i$) en el primario del transformador, verificando $THD_i < 3\%$ a plena potencia.
Prueba de inyección secundaria y ajuste de tiempos de despeje de relés de protección contra arco eléctrico (Arc Flash Clearing Time < 50 ms).
Verificación de aislamiento galvánico y resistencia de aislamiento (> 100 M\Omega a 1000V DC) en todo el circuito de barras colectoras.
4. Arquitectura Estructural e Interoperabilidad con Especificaciones Nvidia DSX POD
La integración física del centro de datos modular de 3.5 MW se fundamenta en las directrices mecánicas y lógicas del estándar de referencia Nvidia DSX POD (Data Center Scale POD). El contenedor o envolvente de transporte sobredimensionado está construido bajo un bastidor perimetral monocasco de acero estructural corten, reforzado con cerramientos sándwich aislantes con clasificación de resistencia al fuego EI-120 y protección ambiental NEMA 4X / IP66. La envolvente incorpora zonas de servicio diferenciadas con pasillo caliente confinado o accesibilidad totalmente frontal y trasera, permitiendo el desacoplamiento ergonómico de bandejas de cómputo acelerado que superan los 80 kg por chasis mediante guías telescópicas y carros mecánicos de elevación sincronizada.
La interoperabilidad hidráulica y óptica es el eje central del ecosistema DSX POD. Las acometidas de fluido hacia los colectores verticales (manifolds) utilizan racores de acoplamiento rápido sin goteo de inserción a ciegas (Blind-Mate Quick Disconnects) con sellos elastoméricos de EPDM/FKM ensayados para cero fugas durante miles de ciclos de conexión. En la sección superior del plenum se ubica la infraestructura de cableado óptico de ultra alta densidad, organizada mediante bandejas independientes para interconexiones InfiniBand Quantum-X800 y Ethernet Spectrum-X de 800 Gbps/1.6 Tbps basadas en troncales preconectorizados MPO-32 y MPO-64. Para mitigar el riesgo catastrófico de fluidos sobre electrónica, se instalan cuerdas sensoras de fugas de detección resistiva milimétrica vinculadas a electroválvulas de corte neumático por solenoide con tiempo de aislamiento inferior a 100 ms.
Verificación de estanqueidad de acoplamientos rápidos (QDs) sometidos a 100 ciclos mecánicos de inserción/extracción bajo presión operativa nominal.
Ensayo de hermeticidad de la envolvente con prueba de presurización por Blower Door conforme a norma ISO 9972.
Comprobación de la continuidad del apantallamiento electromagnético (atenuación EMI > 40 dB en rango de 10 MHz a 10 GHz).
Test funcional de la lógica de parada de emergencia (EPO) asociada al lazo sensor de fuga de fluido e interbloqueo de bombas CDU.
5. Optimización del TCO, Granularidad de Capital y Despliegue Distribuido de Inferencia
El costo total de propiedad (TCO) en la infraestructura de supercómputo no está dominado exclusivamente por el gasto de capital (Capex) del silicio, sino por la tasa de depreciación temporal y el costo de oportunidad del capital inmovilizado. Los centros de datos monolíticos de 100 MW a 500 MW implican compromisos de capital multimillonarios por adelantado que permanecen improductivos durante años mientras se construyen las infraestructuras de soporte. Por el contrario, la modularidad en bloques de 3.5 MW introduce granularidad financiera estricta: los operadores ajustan la inyección de potencia a bloques disponibles en subestaciones o fuentes renovables distribuidas, activando clústeres de GPU capaces de generar ingresos inmediatos y optimizar el Retorno sobre el Capital Invertido (ROIC).
Esta flexibilidad habilita casos de uso disruptivos para clústeres de Inferencia de Baja Latencia y Cómputo Soberano (Sovereign AI). Al permitir la colocación de pods autónomos de 3.5 MW directamente junto a nodos de ingesta masiva de datos (como centros de distribución autónoma, plataformas de telecomunicaciones y campus de investigación biomédica protegidos por regulaciones de soberanía de datos), se elimina el tránsito transfronterizo de flujos masivos y se minimiza la latencia de red de extremo a extremo. Los costos operativos (Opex) se contraen drásticamente gracias al PUE de 1.12 a 1.15 y a la drástica reducción del consumo de agua (WUE cercano a cero), blindando las operaciones contra fluctuaciones regulatorias medioambientales y tarifas hídricas punitivas.
Evaluación comparativa del modelo de amortización financiera (Capex/Opex amortizado por FLOP útil producido durante un ciclo de 36 meses).
Cálculo de eficiencia de consumo de agua (WUE) garantizada contractualmente en régimen estacionario (< 0.01 L/kWh).
Auditoría de cumplimiento de estándares de residencia y cifrado local de datos para despliegues clasificados como IA Soberana.
Verificación de los márgenes de redundancia operativa ($N+1$) en compresores y variadores de frecuencia de bombas sin penalización de TCO.
6. Protocolos de Comisionamiento, Pruebas FAT e Integración en Campo
El factor determinante en la confiabilidad de una infraestructura modular reside en la exhaustividad del Comisionamiento Nivel 1 a 5, concentrando la fase crítica en las Pruebas de Aceptación en Fábrica (Factory Acceptance Testing, FAT). A diferencia de las obras tradicionales, donde la integración ocurre en condiciones de obra desfavorables, el pod de 3.5 MW se somete en planta a un proceso de rodaje continuo (burn-in) de 72 a 120 horas. Bancos de carga resistivos e inductivos trifásicos y simuladores de carga térmica líquida reproducen fielmente los perfiles de demanda transitoria (step loads del 0% al 100%) y armónicos característicos de clústeres masivos de entrenamiento de redes neuronales, validando la estabilidad térmica y la respuesta del lazo de control PID antes de la expedición.
El protocolo de hermeticidad mecánica se ejecuta mediante pruebas de presión no destructivas duales: detección de microfugas moleculares mediante espectrometría de masas con trazador de helio al 100% de la red hidráulica interna, seguida de una prueba hidrostática a 1.5 veces la presión máxima de diseño (típicamente entre 10 bar y 12 bar) durante un periodo no menor a 4 horas según ASME B31.3. La integración final en campo (Site Integration Protocol) se reduce entonces a una secuencia de conexión mecano-eléctrica tipo 'flange-to-flange': acoplamiento de bridas dieléctricas de refrigeración secundaria, conexión de electroductos de entrada y empalme de cassettes de fibra troncal MPO pre-alineadas, reduciendo la ventana de puesta en marcha in situ a menos de 96 horas por pod.
Certificación de prueba de estanqueidad por espectrometría de helio con tasa de fuga admisible $< 1 \times 10^{-6}\text{ mbar}\cdot\text{L/s}$.
Inspección hidrostática a 1.5x presión de diseño sostenida durante 4 horas con registro manométrico digital sin caída de presión detectable.
Ejecución exitosa de secuencia FAT de rechazo de carga transitoria del 100% al 0% y del 0% al 100% sin excursión de frecuencia (> ±0.5 Hz) ni temperatura.
Protocolo de barrido, purga de aire automatizada y llenado con líquido caloportador certificado previo a la energización inicial del silicio.
Adquisiciones e ingeniería de soporte
Para fichas técnicas, proyectos a medida o presupuestos de exportación por volumen, comuníquese con los ingenieros de HEFENGQI.