Die physikalische Reticle-Grenze: Ökonomische und technologische Treiber der 2,5D/3D-Chiplet-Disaggregation
Über fünf Jahrzehnte hinweg basierte das Design von Hochleistungs-Serverprozessoren auf monolithischen Siliziumkristallen. Mit dem Vordringen modernster Lithografieverfahren in Sub-3nm-GAA-Strukturen (Gate-All-Around) kollidiert dieser Ansatz jedoch unweigerlich mit der physikalischen Grenze des photolithografischen Belichtungsfensters (Reticle Limit), das bei gängigen DUV- und EUV-Scannern typischerweise auf etwa 858 mm² begrenzt ist. Gleichzeitig führt das exponentielle Absinken der Wafer-Ausbeute nach dem Murphy- und Bose-Einstein-Modell bei Die-Größen nahe dem Reticle-Limit zu prohibitiven Defektkosten pro funktionstüchtigem Chip. Moderne KI-Trainingscluster, Inferenz-Pipelines für Large Language Models (LLMs) und mandantenfähige Cloud-Hypervisoren verlangen jedoch Rechen- und I/O-Kapazitäten, die innerhalb eines einzigen Reticles nicht mehr darstellbar sind.
Die ingenieurtechnische Lösung liegt in der architektonischen Disaggregation: Heterogene Funktionseinheiten werden in spezialisierte modulare Dies (Corelets, I/O-Hubs, Schnittstellen-Controller, SRAM- und HBM-Stapel) zerlegt. Diese Chiplets werden über fortschrittliche Packaging-Technologien wie Silizium-Interposer (z. B. TSMC CoWoS) oder eingebettete Brückenstrukturen (z. B. Intel EMIB) reaggregiert. Dies ermöglicht nicht nur das Brechen des Reticle-Limits um Faktoren von 2x bis 4x, sondern gestattet auch eine technologische Entkoppelung: Logik-Dies werden im teuren Leading-Edge-Node (z. B. N3P) gefertigt, während I/O- und Speichersteuerungen in kostengünstigeren, hochgradig ausgereiften Lithografien (z. B. 6nm oder 12nm) verbleiben. Das Resultat ist eine erhebliche Senkung der Wafer-Gesamtkosten bei gleichzeitiger Beschleunigung der Entwicklungs- und Qualifikationszyklen kundenspezifischer Beschleuniger.
Ausbeuteoptimierung: Zerlegung massiver 800-mm²-Flächen in modulare Sub-150-mm²-Compute-Dies zur Reduktion der Wafer-Ausschussrate um bis zu 40 %.
Heterogene Lithografie: Gezielte Allokation von Leading-Edge-Nodes (3nm/2nm) ausschließlich für rechenintensive Logik bei Verbleib von Analog/Schnittstellen in 7nm/12nm.
Flächenskalierung: Realisierung synthetischer Chip-Flächen von über 1800 mm² auf Gehäuseebene über passive oder aktive Silizium-Substrate.
Die-zu-Die-Interconnect-Architekturen: UCIe-Standards, Sub-Nanosekunden-Latenzen und Silizium-Interposer
Die Fragmentierung eines Prozessors in verteilte Chiplets steht und fällt mit der Qualität der physikalischen Schnittstellen (PHY) und Übertragungsprotokolle zwischen den Dies. Ein monolithischer Chip profitiert von ultrakurzen Metalllagen-Verbindungen mit Latenzen im Sub-Pikosekundenbereich und nahezu vernachlässigbarem Energieaufwand pro Bit. Die Die-to-Die-Kommunikation über Substrate und Interposer hinweg muss daher eine Bandbreitendichte (Shoreline Bandwidth Density) und Energieeffizienz bereitstellen, die dem Anwender eine monolithische Illusion vermittelt. Mit der Verabschiedung des UCIe-Standards (Universal Chiplet Interconnect Express) steht der Industrie erstmals ein offenes Protokoll zur Verfügung, das von der Transportschicht bis hin zum physischen Bumping Interoperabilität zwischen verschiedenen Foundries garantiert.
Moderne 2,5D-Interposer nutzen Micro-Bumps mit Pitches von 25 µm bis 45 µm, wodurch Kanten-Bandbreitendichten von über 1,3 Tbps pro Millimeter Die-Umfang erzielt werden. Die Leitungsführung auf passiven Silizium-Interposern erfordert feinste Metallisierungen (Sub-Mikrometer Line/Space-Geometrien), um kapazitive Lasten und parasitäre Induktivitäten zu minimieren. Bei Datenübertragungsraten von bis zu 32 Gbps pro Lane nach dem UCIe-2.0-Standard darf der Energieaufwand pro übertragenem Bit 0,5 pJ nicht überschreiten, um das Gesamtenergiebudget des Prozessorgehäuses nicht durch interne I/O-Transfers zu überlasten. Zudem müssen die physikalischen Latenzen der Schnittstellen auf unter 2 Nanosekunden begrenzt werden, um Cache-Kohärenzprotokolle wie CXL.mem oder unternehmensspezifische Kohärenznetzwerke (Coherent Fabric Meshes) ohne signifikante Pipeline-Stalls zu betreiben.
Interposer-Leitungsdichte: Implementierung von Sub-Mikrometer Line/Space-Strukturen (L/S < 0,8 µm) mit Micro-Bump-Pitches unter 40 µm.
I/O-Energiebudget: Begrenzung des Die-to-Die-Energiebedarfs auf maximal 0,25 bis 0,5 pJ/bit bei 32 Gbps/Lane über standardisierte UCIe-Physical-Layers.
Latenz-SLA: Einhaltung einer PHY-zu-PHY-Durchlaufzeit von < 2 ns zur Vermeidung von Latenzstrafen bei cache-kohärentem Multi-Die-Traffic.
Sub-Volt-Kernspannungsregelung: Beherrschung extremer di/dt-Transienten durch 48V-PoL und IVR
Mit dem Vordringen in fortgeschrittene Prozesstechnologien sinkt die nominale Kernspannung (Vcore) moderner Compute-Dies auf 0,70 V bis 0,85 V, während die Leistungsaufnahme pro Sockel mühelos 800 W bis 1200 W erreicht. Dies resultiert in Betriebsströmen von weit über 1000 Ampere pro Prozessorsockel. Verschärft wird diese Dynamik durch die Arbeitslastmuster moderner Deep-Learning-Algorithmen: Taktzyklen-synchrone Aktivierungen von Matrix-Multiplikationseinheiten (z. B. Tensor- oder Systolic-Arrays) erzeugen steilflankige Stromänderungsraten (di/dt-Transienten) von mehr als 1500 A/µs. Konventionelle Mehrphasen-Spannungswandler auf der Hauptplatine können aufgrund parasitärer Leitungsinduktivitäten diese Lastsprünge nicht mehr abfangen, was ohne Gegenmaßnahmen zu fatalen Vdroop-Zuständen und transienten Rechenfehlern führt.
Zur Lösung dieser Herausforderung etabliert sich eine zweistufige Topologie für das Stromversorgungsnetz (Power Delivery Network, PDN). Die Systemspannung wird primär mit 48V bzw. 54V bis unmittelbar an den Prozessorsockel herangeführt, um Leitungsverluste auf der Leiterplatte drastisch zu minimieren. Die finale Spannungsreduktion erfolgt zunehmend über integrierte Spannungsregler (Integrated Voltage Regulators, IVRs) oder galvanisch nicht getrennte Point-of-Load-Wandler (PoL), die mittels Vertical Power Delivery (VPD) direkt auf der Unterseite des Gehäusesubstrats montiert werden. Durch diese 3D-Kopplung werden parasitäre Schleifeninduktivitäten im Millimeterbereich eliminiert. Hochfrequent schaltende Galliumnitrid- (GaN) und Siliziumkarbid-Stufen (SiC) ermöglichen Schaltfrequenzen im zweistelligen Megahertz-Bereich, wodurch die Stütz- und Entkopplungskapazitäten (Deep Trench Capacitors, DTC) signifikant verkleinert werden können.
Transienten-Festigkeit: Auslegung des PDN zur Dämpfung von di/dt-Flanken > 1500 A/µs bei einer maximalen Vcore-Welligkeit von unter ±35 mV.
Vertical Power Delivery: Reduktion parasitärer Schleifeninduktivitäten auf < 5 pH durch direkte Substrat-Rückseitenintegration der Spannungsregler.
Wandlungswirkungsgrad: Realisierung einer durchgehenden Effizienzkette von > 91 % vom 54V-Zwischenkreis bis hinunter zur Sub-Volt-Schiene (0,75 V).
Mikroskopische Wärmestromdichten: Direct-to-Chip-Mikrokanal-Kühler, Dampfkammer-TIMs und Grenzschichtdegradation
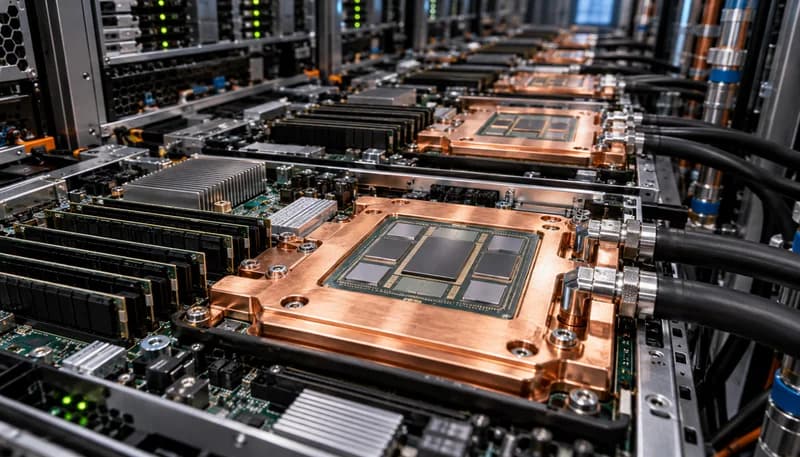
Die Konzentration hunderter Milliarden Transistoren auf engstem Raum durch 2,5D- und 3D-Packaging führt zu einer drastischen Zuspitzung der thermischen Dissipation. Während die durchschnittliche Wärmeleistung des Gesamtsockels beherrschbar erscheint, weisen hochfrequente Rechenkerne und Matrixeinheiten mikroskopische Hotspots mit lokalen Wärmestromdichten von weit über 100 W/cm² bis hin zu 300 W/cm² auf. Luftgekühlte Heatpipe-Kühler scheitern hierbei vollständig am thermischen Gesamtwiderstand (Rth, Junction-to-Air). Die einzig physikalisch tragfähige Antwort ist die Direct-to-Chip (D2C) Flüssigkeitskühlung, bei der Kühlflüssigkeit durch mikrostrukturierte Kühlkörper (Microchannel Cold Plates) direkt über dem Siliziumgehäuse zirkuliert.
Die thermomechanische Zuverlässigkeit der Kühlschnittstelle wird durch die Heterogenität des Chiplet-Verbunds extrem belastet. Die unterschiedlichen thermischen Ausdehnungskoeffizienten (CTE) von Silizium-Dies, HBM-Stapeln, Underfill-Materialien und organischen Gehäusesubstraten führen im thermischen Zyklus zu Verbiegungen (Warpage). Konventionelle Wärmeleitpasten (Thermal Interface Material 1, TIM-1) unterliegen dabei dem gefürchteten 'Pump-Out'-Effekt und thermischem Austrocknen, was den thermischen Kontaktwiderstand über Zeit drastisch ansteigen lässt. Die Industrie migriert daher zunehmend zu Phasenwechselmaterialien (Phase Change Materials, PCM), gesinterten Indium-Preforms oder langlebigen Flüssigmetall-Legierungen, kombiniert mit lasergeschweißten Mikrokanalgeometrien (Fin-Breiten < 50 µm), um einen Junction-to-Liquid-Widerstand von unter 0,05 K/W über eine Betriebsdauer von fünf Jahren sicherzustellen.
Hotspot-Abfuhr: Beherrschung lokaler Wärmestromdichten von bis zu 250 W/cm² bei maximal zulässigen Silizium-Schnittstellentemperaturen (Tj) von 85 °C.
Kanalgeometrie: Auslegung von Kaltplatten mit Mikrokanal-Finnenbreiten ≤ 40 µm zur Maximierung der konvektiven Wärmeübertragungsfläche.
TIM-Degradationsschutz: Einsatz metallischer oder fortschrittlicher Phasenwechsel-Grenzschichten zur Vermeidung von Pump-Out bei thermischen Zyklen (ΔT > 40 K).
Serverplattform- und Rack-Verdichtung: 54V-Stromschienen, Blind-Mate-Hydraulik und OCP-ORV3-Mechanik
Die Multiplikation der Compute-Dichte pro Sockel transformiert das gesamte mechanische und elektromechanische Design von Serverchassis und Racks. Klassische 19-Zoll-Schränke und standardisierte 12V-Stromverteilungen sind bei Multi-Kilowatt-Serverknoten physikalisch überfordert, da die resultierenden Stromstärken zu massiven Kupferquerschnitten und unvertretbaren I²R-Leitungsverlusten führen würden. Gemäß den Spezifikationen des Open Compute Project Open Rack Standard Version 3 (OCP ORV3) migriert die Branche auf standardisierte 21-Zoll-Architekturen mit einer zentralen, vertikalen 48V/54V-Kupferstromschiene (Busbar). Diese Schiene wird aus redundanten, hocheffizienten Power Shelves mit Titanium-Netzteilen gespeist, die einen Konversionswirkungsgrad von über 96,5 % erzielen.
Gleichzeitig erzwingt die Flüssigkeitskühlung eine vollständige Neugestaltung der Serverplattform. Manuelle Schlauchverbindungen im Servergehäuse stellen im Hyperscale-Betrieb ein unkalkulierbares Wartungs- und Leckagerisiko dar. ORV3-basierte Racks integrieren daher rückseitige Blind-Mate-Schnellkupplungen (Quick Disconnects, QD) für Kühlflüssigkeiten direkt in das Chassiseinschubsystem. Beim Einschieben eines 1U- oder 2U-Server-Blades verriegeln sich sowohl die 54V-Gleichstromkontakte als auch die hydraulischen Vor- und Rückläufe des Sekundärkühlkreislaufs simultan und leckagefrei. Die mechanische Rahmenstruktur muss hierbei Toleranzen im Sub-Millimeterbereich gewährleisten, um die hohen Einsteckkräfte aufzunehmen und dynamische Belastungen bei Gesamt-Rackgewichten von über 1400 kg statisch sicher abzutragen.
Busbar-Skalierung: Implementierung von 48V/54V-Kupferstromschienen nach OCP ORV3 zur Reduzierung parasitärer Leitungsverluste um den Faktor 16 gegenüber 12V-Systemen.
Hydraulische Blind-Mate-Integration: Installation tropffreier Schnellkupplungen (Flush-Face Quick Disconnects) mit Leckageraten < 0,05 ml pro Steckzyklus.
Strukturelle Belastbarkeit: Zertifizierung des Rack-Rahmens für dynamische Nutzlasten bis 1500 kg zur Aufnahme dichter D2C-Kupferblöcke und Manifolds.
Hyperscale-Infrastruktur-Engineering: Umrüstung von Brownfield-Rechenzentren auf 60-kW- bis 120-kW-Flüssigkühlracks
Auf Gebäudeinfrastrukturebene bewirkt der Siegeszug disaggregierter Chiplets einen radikalen Paradigmenwechsel. Konventionelle Brownfield-Rechenzentren wurden historisch für Luftkühlungskapazitäten von 10 kW bis maximal 20 kW pro Rack bei Doppelbodenbelüftung ausgelegt. Werden diese Racks nun mit hochdichten Chiplet-Servern bestückt, steigt die Leistungs- und Kühllast schlagartig auf 60 kW bis über 120 kW pro Rackstellplatz. Eine reine Luftkühlung ist bei diesen Dichten thermodynamisch unmöglich. Rechenzentrumsingenieure müssen daher bestehende White-Space-Flächen retrofitten, indem sie zentrale Kühlmittelverteileinheiten (Cooling Distribution Units, CDUs) in Reihen- oder Randeinschub-Architektur (In-Row / End-of-Row) nachrüsten.
Der Einsatz von D2C-Flüssigkühlung eröffnet signifikante Effizienzpotenziale: Durch die drastisch verbesserte Wärmeübertragung am Chiplet-Gehäuse kann die primäre Kühlmittelvorlauftemperatur gemäß den ASHRAE-Spezifikationen der Klassen W3 und W4 auf bis zu 45 °C angehoben werden. Dies eliminiert die Notwendigkeit energieintensiver mechanischer Kältemaschinen (Chiller) vollständig und erlaubt den ganzjährigen Betrieb im Freikühlmodus (Dry Cooler) selbst in gemäßigt warmen Klimazonen. Infolgedessen kann die Power Usage Effectiveness (PUE) moderner Hyperscale-Rechenzentren selbst unter extremen KI-Dichten von 1,35 auf Werte unter 1,12 gesenkt werden. Darüber hinaus ermöglicht das hohe Temperaturniveau des Rücklaufs (über 55 °C bis 60 °C) die direkte Einspeisung der Abwärme in kommunale Fernwärmenetze oder industrielle Prozesswärmeanwendungen.
Dichte-Upgrade im White Space: Nachrüstung zentraler CDUs (Kühlleistung ≥ 300 kW pro Einheit) zur Versorgung von 60-kW- bis 120-kW-High-Density-Racks.
Chiller-loser Betrieb: Auslegung der primären Rückkühlung nach ASHRAE W4 mit Vorlauftemperaturen bis 45 °C zur Realisierung ganzjähriger Freikühlung.
PUE-Reduktionspfad: Senkung der Gesamtanlageneffizienz (PUE) auf < 1,12 unter Volllastbedingungen bei Integration von Abwärmenutzungskreisläufen (T-Return ≥ 55 °C).
Beschaffung und technischer Support
Für Produktdatenblätter, kundenspezifische Stromversorgungslösungen oder Großhandelsangebote kontaktieren Sie HEFENGQI.