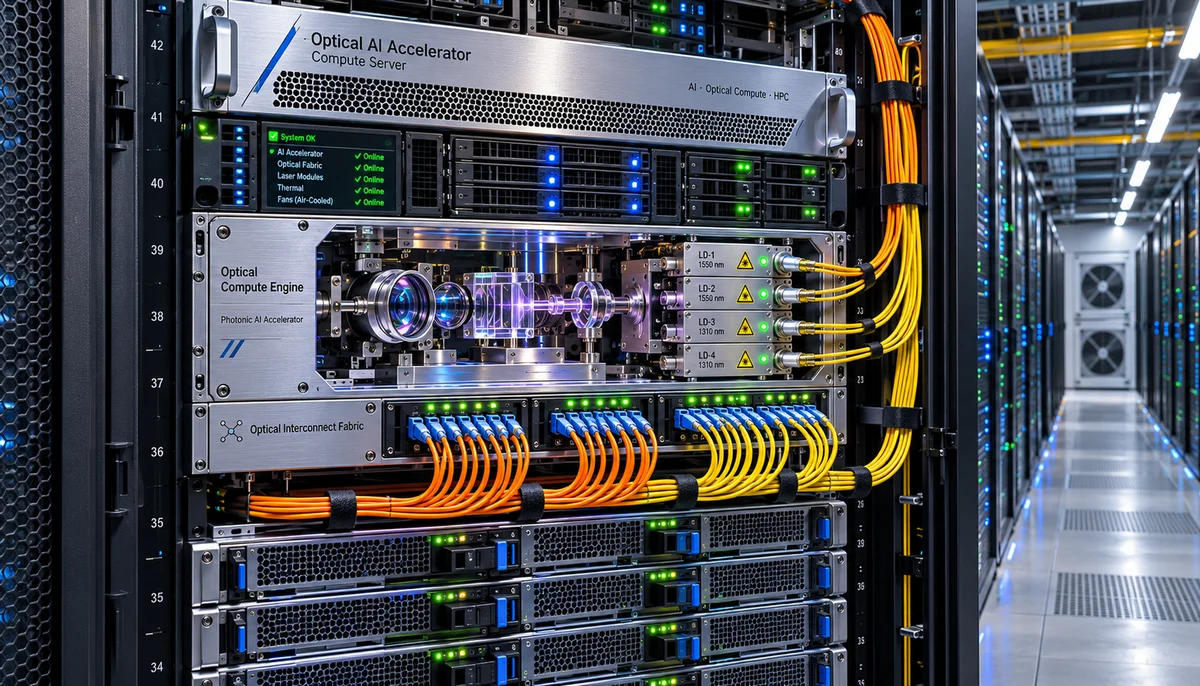
矩阵乘法的物理演变:从半导体电子迁移到光子矩阵乘累加
现代硅基GPU在执行通用矩阵乘法(GEMM)时,依赖于在数十亿个纳米级晶体管中高速调制电子态。随着先进制程微缩进入3nm乃至2nm节点,晶体管互连线寄生电容引起的动态开关功耗与量子隧穿漏电流急剧恶化,导致数字逻辑单元的算力能效瓶颈锁定在每MAC操作1至3皮焦耳(pJ/MAC)。高密度互连金属层的高频寄生效应与时钟树分布网络占用了巨额能量,使得依赖电子开关的张量计算架构逐渐撞上不可逾越的热耗散物理之墙。
光子AI计算加速器通过在光域直接执行线性代数运算重构了计算底层物理机制。系统将输入激活张量调制至高相干性连续波激光载波上,借助波分复用(WDM)技术在单一波导中并行传输数百条特征光路,并引导光束通过由微环谐振腔阵列(MRR)、马赫-曾德尔干涉仪(MZI)或自由空间衍射光学元件构建的无源光矩阵单元。光子在穿过透镜组和调制栅格的过程中,利用光干涉与吸收特性的物理本征叠加,在纳秒级光飞行时间内完成数以百万计的乘累加(MAC)运算,核心计算过程能耗降低至0.1 pJ/MAC以下,且无源光计算部分几乎不产生阻性焦耳热。
算力能耗密度对比:无源光域GEMM核心运算能耗小于0.1 pJ/MAC,相较先进制程CMOS数字逻辑(1-3 pJ/MAC)实现数量级跨越
空间计算物理特性:基于波分复用与自由空间衍射光学单元,以光速完成全并行向量-矩阵张量卷积,内部无全局时钟分配树开销
物理级解耦推理拓扑:Prefill算力密集型集群与Decode显存带宽绑定架构
大型语言模型(LLM)的推理管道在物理计算特征上呈现高度不对称性。在Prompt预填充(Prefill)阶段,系统一次性吞吐成千上万个上下文Token,权重矩阵在全部序列维度被高频复用,运算表现为极高算力操作强度的计算受限型特征;而在自回归生成(Decode)阶段,系统单步仅生成单个Token,其吞吐率完全受限于高带宽内存(HBM3e/HBM4)的读取带宽与延迟,呈现典型的显存受限型特征。强行将两阶段混合于同一种GPU微架构中,导致昂贵的高带宽显存与张量计算核心交替闲置。
在解耦式服务架构中,光学加速集群(如Lumai Iris Nova平台)专职处理长上下文(32k至1M+ Tokens)的Prefill阶段。光学引擎高速完成注意力机制中的Q、K、V投影与前馈网络GEMM,随后通过200G/400G RoCEv2或InfiniBand互联底座,以微秒级延迟将计算生成的KV Cache直接DMA推流至远端的数字GPU/ASIC Decode节点。软件栈层面,vLLM的分块预填充(Chunked Prefill)与PagedAttention机制、SGLang的前缀缓存管理以及Ray Serve分布式执行图已实现对异构光电解耦节点的原生调度支持。
非对称计算流水线:光学计算节点专注超高算力密度的长序列KV生成,数字ASIC/GPU专用集群专注低延迟HBM Decode生成
通信与软件框架收敛:基于无损RoCEv2网络的KV Cache低延迟流转,原生适配vLLM、SGLang等现代分布式推理框架的分块调度协议
电气与热功耗工程:兼容EIA-310标准风冷基础设施的紧凑包络
当代万卡超大规模AI数据中心面临的核心约束已从计算芯片供给转向变电站配电配额与变压器扩容周期。传统全数字GPU集群在满负荷推理时,单机柜功耗迅速飙升至40kW至100kW+,迫使运营方斥巨资在机房二次侧加装复杂的液冷分配单元(CDU)、冷却塔及管网回路,极大增加了单瓦特基础设施投资(CapEx)。现有大量存量数据中心机房依然运行在10kW至20kW的标准风冷供电与散热配额之内,无法直接接纳最新代次的液冷超级Pod。
光子AI服务器采用先进的混合光电架构:光计算引擎负责处理90%以上总计算量的稠密矩阵乘法,而标量控制逻辑、非线性激活函数(如Softmax、SiLU、LayerNorm)及显存管理则由成熟工艺的低功耗CMOS数字协处理器承担。由于光矩阵计算单元在物理机制上不形成高密度热点,单台2U/4U光子推理服务器的总电气功耗能够严格限制在1.5kW至2.5kW范围内。该特性使得系统能够无缝插入传统EIA-310 19英寸机架,在ASHRAE A1/A2推荐标准的冷热通道封闭风冷环境下长期高可靠运行,消除了数据中心实施高成本液冷改造的必要性。
机柜级功耗适配:单机功耗收敛于1.5kW-2.5kW(2U/4U规格),可无缝部署于10kW-20kW传统标准风冷机柜环境
基础设施保护:完全兼容ASHRAE A1/A2冷热通道风冷气流组织,规避高压液冷管网部署与冷却分配单元(CDU)改造成本
电信级光电供应链、相干封装与环境漂移闭环控制
光计算加速器的商业化量产基础依托于成熟的电信与数通光电子供应链。系统广泛采用在1310nm O波段与1550nm C波段经过长期产业验证的标准分布式反馈(DFB)激光器阵列、电吸收调制器(EAM)以及高紧凑度马赫-曾德尔调制器件。通过利用量产化的标准光纤耦合阵列与标准可插拔光模块封装(OSFP、QSFP-DD),光计算芯片能够绕过昂贵的非标定制化产线,获得高吞吐、高良品率的晶圆级光子集成电路(PIC)制造能力。
工业级环境下的振动冲击与工作温度漂移是维持光计算精度的关键工程挑战。微环谐振器与干涉阵列对纳米级波长变化极度敏感,微小的环境热胀冷缩会导致相位漂移并恶化计算信噪比。为此,量产级光子加速卡集成了高响应闭环热电冷却(TEC)模块与片上干涉反馈校准电路,将激光中心波长漂移锁定在小于0.01 nm/°C的极限指标内。结合硅波导微米级精密对准封装与高线性度雪崩光电探测器(APD)阵列,光计算引擎确保了在10°C至45°C工业环温下,信号完整性与信噪比完全满足INT8及FP8精度的模型收敛要求。
供应链复用性:基于成熟的1310nm/1550nm电信级DFB激光阵列、EAM调制器及标准化可插拔光电互联介质构建
温漂闭环控制:片上干涉反馈结合高速TEC电路实现低于0.01 nm/°C的波长漂移抑制,保障全温区FP8/INT8运算精度
TCO经济学、搁浅电力盘活与超大规模集群实证验证
在配电容量受限的超大规模数据中心中,存在大量因机架供电不匹配或热设计余量冗余导致的“搁浅电力(Stranded Power)”。通过将耗能占推理总量60%至70%的预填充算力剥离至光子AI加速底座,数据中心运营商无需向电网申请额外的兆瓦级(MW)供电扩容,即可在现存设施供电包络内将Prompt并发处理容量提升3倍以上。这种极高的能效密度显著削减了每百万Token处理的能耗成本,同时消除了蒸发式水冷塔的巨额耗水量,使数据中心的水资源利用效率(WUE)与碳排放强度大幅优化。
英国高级研究与发明局(ARIA)Scaling Inference Lab与产业界的实地试点验证了该架构在生产环境中的鲁棒性。基于Lumai Iris Nova光子加速底座的测试表明,系统平均无故障时间(MTBF)超越100,000小时大关,表现出媲美传统电信传输设备的系统级可靠度。在云原生基础设施层,通过定制化Kubelet设备插件与KServe推理编排算子,系统能够将光计算Prefill引擎抽象为标准Kubernetes资源池,实现与主流深度学习微服务框架的零侵入动态协同调度。
电力利用重构:将长序列Prompt处理并发度提升3倍,在既有供电容量内盘活数兆瓦级数据中心搁浅电力
生产级可用性指标:在真实智算实验室中验证系统级MTBF超过100,000小时,支持Kubernetes及KServe原生资源化纳管调度