一、 产业背景与核心技术架构
【行业技术趋势】随着百亿至万亿级参数大模型(LLM)分布式并行训练走向常态,AI 算力集群规模已迅速突破万卡甚至十万卡级别。在这类高密集度横向扩展(Scale-Out)与纵向扩展(Scale-Up)拓扑中,算力瓶颈已由 GPU 矩阵乘法计算延迟转移至跨节点通信互联带宽。800G 与 1.6T 高速光收发模块(Optical Transceiver)作为连接 GPU 计算单元与 Leaf/Spine 交换机矩阵的核心纽带,正迎来爆发式换代升级。
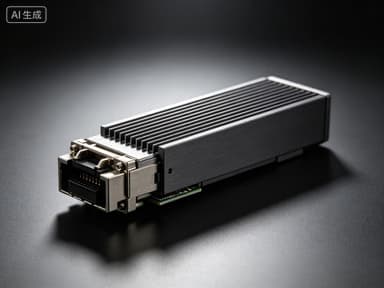
在物理封装规格方面,针对单机柜 40kW~100kW 的超高热密度,业界主流正由早期的 QSFP-DD 封装加速向 OSFP(Octal Small Form-factor Pluggable)乃至更高密度的 OSFP-XD(Extra Density)封装演进。相比传统 QSFP-DD,OSFP 封装在物理尺寸上稍宽,并在模块顶部直接集成了高导热散热鳍片(Integrated Fin),支持高达 25W~35W 的模块热耗散功耗。这使得在 1U 交换机正面面板上部署 32 口 800G/1.6T 成为可能,大幅缓解了交换机前面板微通道散热风阻。
二、 关键电气与光学参数解析
电信号传输速率的提升直接催生了物理调制层从单通道 100G PAM4 向单通道 200G PAM4 的代际飞跃。以 800G 模块为例,主流方案正由 8×100G 架构迅速过渡为 4×200G 架构,不仅将所需激光器与光接收芯片数量减半,更显著提升了集成度与长期工作可靠性(MTBF)。在核心发射芯片路线上,采用单片集成波导与相干相移调制结构的硅光子(Silicon Photonics / SiPh)方案,在高热与大电流环境下的生产良率和温漂稳定性显著优于传统分立式 EML(电吸收调制激光器),正在成为跨国超大规模云厂商的首选基石。
然而,传统光模块内部集成的 DSP(数字信号处理器)芯片带来了极大的功耗挑战。在典型的万卡 AI 集群中,光模块群的总耗电量甚至能够占据整机房电力消耗的 12%~15% 以上。为了打破这一“光电能耗墙”,业界开辟了三大架构路线并驾齐驱:第一是成熟度最高的可插拔线性直驱技术(LPO,Linear-drive Pluggable Optics),彻底剥离模块内部的 DSP 与 CDR 芯片,直接利用交换机端 SerDes 进行信道均衡,将单模块功耗骤降 45%~50%,端到端延迟压至微秒级以下;第二是半直驱(LRO)过渡架构;第三则是远期演进的光电共封装(CPO,Co-Packaged Optics)技术。
三、 现场工程痛点与拓扑优化
在通信机房与数据中心布线工程层面,800G/1.6T 极短波长对光纤端面清洁度与插入损耗(Insertion Loss)有着变态级的容忍阈值。采用 MPO/MTP-16 与 MPO-24 高密度多芯光纤跳线时,通道回波损耗(Return Loss)必须严苛优于 -45dB。在机房配电与机柜规划中,必须配套设计具有低压降母排的大容量通信电源与定制化高密度光纤配线架(ODF),避免密集布线形成热空气滞留区诱发激光器过热降频。
四、 运维规范与避坑指南
禾风起(HEFENGQI / RICEWIND)长期致力于全球通信基础设施、高密微模块算力机房与高频开关电源系统的研发与工程配套,生产符合 CE、UL 与 IEC 严苛国际标准的标准化通信机柜、智能直流配电单元(PDU)及光纤布线管理体系,全面赋能跨国数据中心与 AI 集群的高速互连部署。
五、 禾风起全球工程配套与选型支持
全球工程采购、光通信布线配套与技术支持通道:Email: lee@ricewind.com | WhatsApp: +86 17621197907。