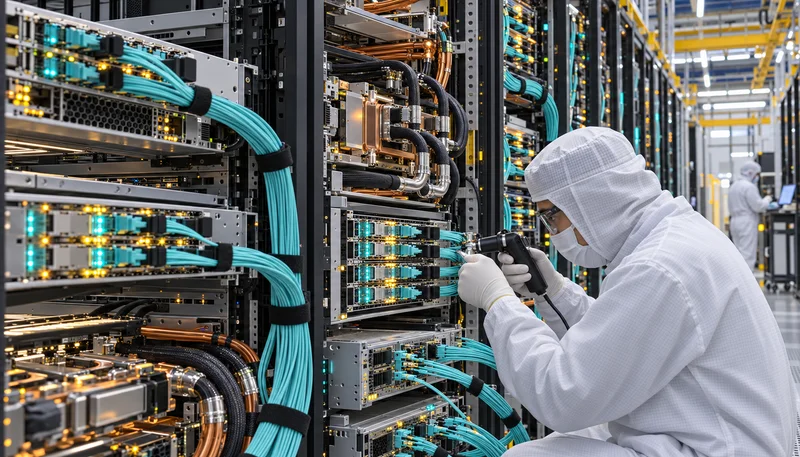
Límites Físicos del Cobre e Integridad de Señal en Canales PCIe 6.0 y 7.0
La escalabilidad de los clústeres de cómputo para entrenamiento de modelos fundacionales ha alcanzado una barrera insalvable determinada por la física electromagnética del cobre. Con la estandarización de PCIe 6.0 operando a 64 GT/s y la proyección inminente de PCIe 7.0 a 128 GT/s mediante modulación por amplitud de pulso de cuatro niveles (PAM4), la frecuencia de Nyquist se sitúa en 16 GHz y 32 GHz respectivamente. A estas frecuencias ultraelevadas, el presupuesto total de pérdidas de inserción establecido por el PCI-SIG oscila estrictamente entre 32 dB y 36 dB. La atenuación combinada de las trazas en tarjetas de circuito impreso multicapa de baja pérdida (Megtron-7 o Megtron-8), los conectores de factor de forma estandarizado y los cables de cobre pasivos de fijación directa (DAC) consume este presupuesto en distancias inferiores a un metro, restringiendo la conectividad física al confinamiento dentro de un mismo chasis.
Más allá de la atenuación intrínseca, el efecto pelicular (skin effect) extremo y las pérdidas dieléctricas incrementan de manera asimétrica la dispersión cromática y la degradación del diagrama de ojo. En un enlace PAM4, la separación de tensión entre niveles lógicos contiguos se reduce a un tercio en comparación con la modulación NRZ clásica, disminuyendo dramáticamente la relación señal-ruido (SNR) y aumentando la vulnerabilidad frente a la diafonía de extremo cercano y lejano (NEXT y FEXT). La inserción de cables eléctricos activos (AEC) mitigó temporalmente el problema mediante la integración de retimers DSP; sin embargo, cada canal retimer añade una penalización térmica inaceptable de entre 2 y 3 vatios por carril x1, introduce jitter adicional y eleva la sobrecarga de latencia que afecta directamente los mecanismos de corrección de errores hacia adelante (FEC) en Flit Mode, tornando inviable la topología de cobre para agrupaciones de cómputo distribuidas.
Verificar que el presupuesto total de pérdida de inserción en canal no supere los 32 dB a 16 GHz (PCIe 6.0) o 36 dB a 32 GHz (PCIe 7.0).
Calcular la relación señal-ruido residual (SNR) bajo modulación PAM4 considerando una reducción de margen de apertura vertical superior al 66% respecto a NRZ.
Auditar el consumo parásito derivado de retimers AEC, limitando la densidad por chasis si el balance supera los 48 W por ranura x16.
Arquitectura de PCIe Óptico y Dinámica de Transceptores VCSEL Multicanal
La superación del límite del cobre sin alterar las capas superiores del protocolo exige una transposición óptica transparente de la capa física de PCIe. El paradigma de PCIe óptico transporta de manera nativa paquetes de capa de transacción (TLP) y paquetes de capa de enlace de datos (DLLP) estructurados en Flit Mode de 256 bytes, manteniendo intactos el control de flujo basado en créditos y los requisitos de memoria mapeada por carga/almacenamiento (load/store). Esto garantiza la coherencia de memoria requerida por extensiones avanzadas como CXL.mem y CXL.cache sin incurrir en la sobrecarga de encapsulación ni en la terminación de pila características de Ethernet convergente (RoCEv2) o InfiniBand. La conversión electro-óptica directa permite preservar el determinismo temporal y la baja latencia crítica para el paralelismo de tensores en arquitecturas de aceleración masiva.
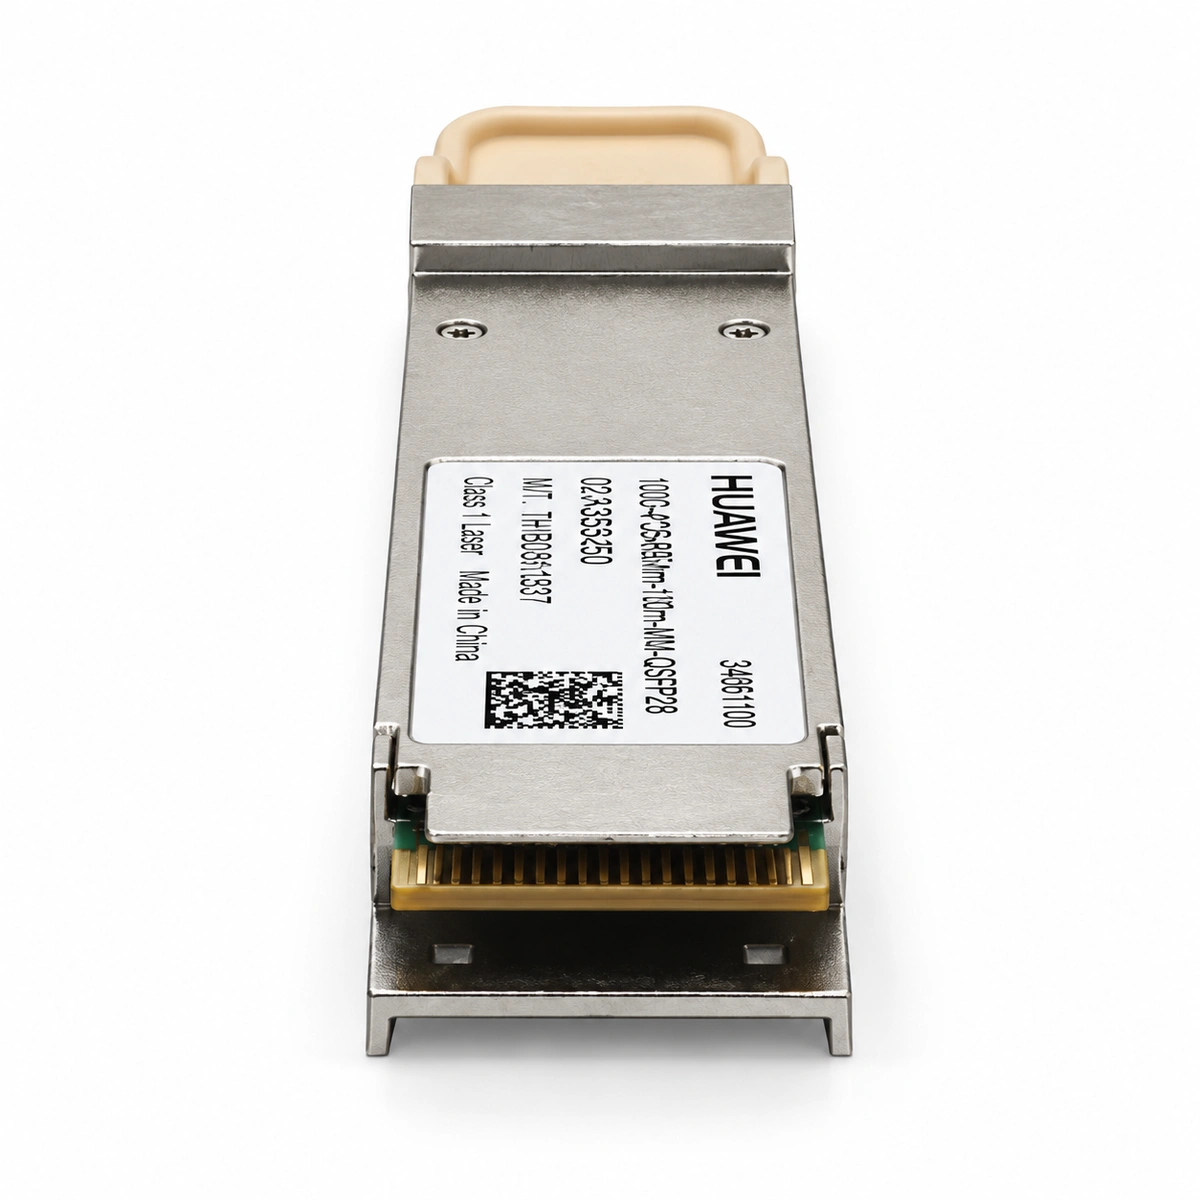
La implementación física líder analizada en el consorcio OCP se basa en matrices de láseres emisores de superficie de cavidad vertical (VCSEL) que operan en longitudes de onda de 850 nm y 910 nm. Estos emisores ópticos se acoplan a fibras multimodo insensibles a curvatura OM4 y OM5 estructuradas en cintas MPO paralelas. La arquitectura de excitador (driver) y transceptor transimpedancia (TIA) de ultra baja potencia alcanza una latencia de conversión bidireccional inferior a 5 nanosegundos, un valor infinitesimalmente despreciable frente a los ciclos de reloj del sistema. Esta topología óptica permite extender el alcance efectivo del bus PCIe desde apenas 1.5 metros sobre cobre hasta distancias de entre 10 y 100 metros dentro de la sala de servidores, eliminando la correlación forzada entre proximidad física y localidad de bus.
Comprobar que el retraso acumulado de conversión electro-óptica (E-O-E) se mantenga estrictamente por debajo del umbral de 5 ns por salto de enlace.
Garantizar la preservación de estados nativos Flit Mode y señalización de crédito de enlace PCIe sin intermediación de puentes de software.
Implementar fibra multimodo OM4 u OM5 insensible a dobleces con atenuación óptica inferior a 2.5 dB/km a 850 nm.
Desagregación Rack-Scale y Topología de Clústeres Scale-Up para Inteligencia Artificial
Al extender el alcance de la interfaz nativa PCIe a escala de sala mediante fibra, el diseño arquitectónico de los clústeres de IA trasciende la frontera rígida del chasis de 19 o 21 pulgadas. Tradicionalmente, una unidad de cómputo para entrenamiento de grandes modelos de lenguaje debía integrar aceleradores (GPU o XPU), procesadores anfitriones y bancos de memoria locales en un espacio confinado para evitar la degradación de señal. Con el despliegue de conmutadores de tejido óptico inteligentes, como los switches de tejido PCIe óptico demostrados recientemente, se consolida una desagregación multilateral. Los aceleradores de cómputo, los módulos de expansión de memoria dinámica CXL 3.1 y los sistemas de almacenamiento NVMe de estado sólido pueden residir en bastidores independientes especializados, interconectados a través de un plano de conmutación no bloqueante.
Esta topología scale-up desagregada transforma la gestión de recursos en un sustrato componible en tiempo de ejecución. Un conjunto arbitrario de GPUs distribuidas en diferentes racks térmicamente optimizados puede consolidarse dentro del mismo dominio de coherencia PCIe, accediendo a un pool de memoria compartida con latencias equivalentes a las de una tarjeta insertada en una ranura local. Asimismo, la desagregación elimina la dependencia geométrica respecto a las limitaciones puntuales de suministro eléctrico y refrigeración líquida de un bastidor singular, permitiendo distribuir las cargas computacionales masivas a lo largo de un mallado flexible optimizado para evitar puntos calientes y cuellos de botella en la fase de all-reduce.
Configurar dominios de direccionamiento PCIe no bloqueantes que admitan hasta 256 dispositivos de procesamiento sin pérdida de coherencia de caché.
Asignar dinámicamente bloques de memoria compartida desagregada CXL 3.1 mediante tejido conmutado óptico.
Validar el dimensionamiento de rutas ópticas para balancear el tráfico de gradientes all-reduce evitando sobrecargas de contención en el conmutador central.
Disipación de Potencia, Impedancia Aerodinámica y Dinámica Térmica del Enlace
La integración masiva de cobre de alta densidad en la parte posterior de bastidores tradicionales crea una barrera física conocida como impedancia aerodinámica parásita. Los mazos de cables DAC gruesos y rígidos, requeridos para limitar las pérdidas resistivas en longitudes de 1 a 2 metros, bloquean físicamente las rejillas de extracción de aire caliente proveniente de chasis de cómputo con densidades superiores a 10 kW por unidad de rack. Esto obliga a los ventiladores a operar a revoluciones por minuto extremadamente altas, aumentando el consumo parásito del sistema de refrigeración mecánica en un 15% a 25% del presupuesto energético del nodo. La sustitución de estos mazos voluminosos por arneses de microfibra óptica de alta densidad reduce la resistencia al flujo de aire a niveles virtualmente insignificantes.
Desde la perspectiva del balance energético por canal, la arquitectura óptica ofrece ventajas termodinámicas superiores. Aunque el motor óptico VCSEL introduce un consumo inherente de modulación láser, este queda holgadamente compensado por la eliminación de los múltiples retimers y ecualizadores de tiempo continuo (CTLE) de alto consumo necesarios para forzar la transmisión sobre cobre degradado. Adicionalmente, las arquitecturas ópticas permiten desacoplar térmicamente el transceptor respecto a la proximidad destructiva de los paquetes ASIC principales, cuya disipación térmica supera habitualmente los 700 a 1000 W. Mediante el uso de óptica de placa intermedia (Mid-Board Optics o MBO) e interfaces ópticas de panel frontal, los motores de emisión láser se aíslan de las fluctuaciones térmicas extremas, garantizando su estabilidad espectral.
Monitorear la caída de presión estática en el plenum de extracción del rack para confirmar la reducción de la resistencia aerodinámica por debajo de 0.2 pulgadas de H2O.
Calcular la reducción neta de vatios consumidos por carril x1 al sustituir etapas de DSP/Retimer por transceptores VCSEL integrados.
Verificar que la temperatura de unión de los arreglos VCSEL no sobrepase los 70 °C mediante el aislamiento térmico relativo respecto a los disipadores del silicio de procesamiento.
Distribución de Potencia DC en Subrack e Infraestructura de Alta Disponibilidad
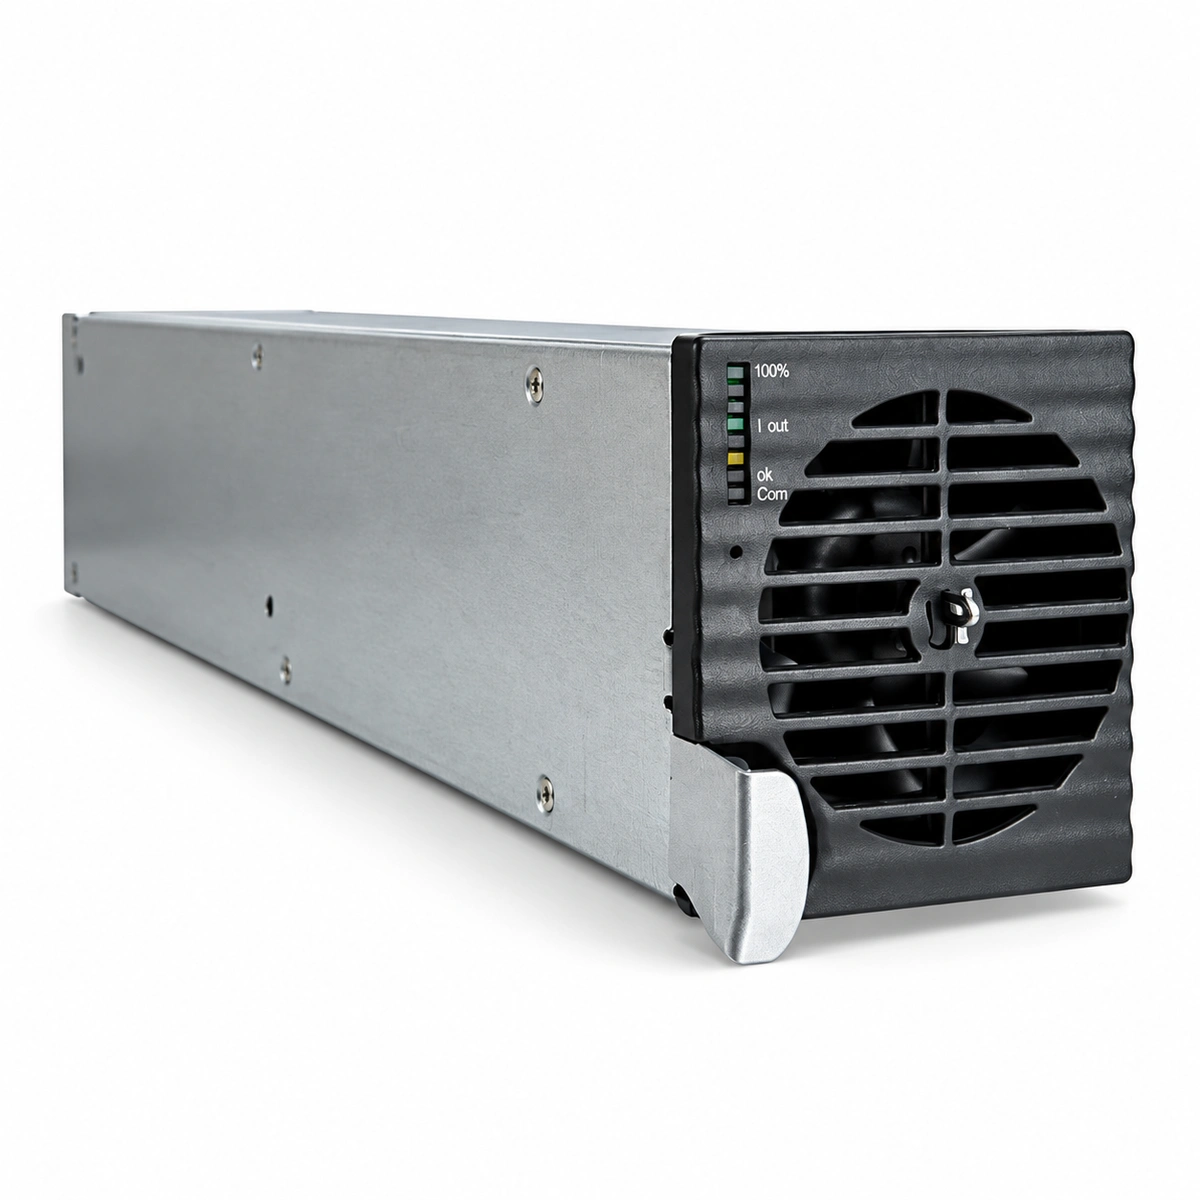
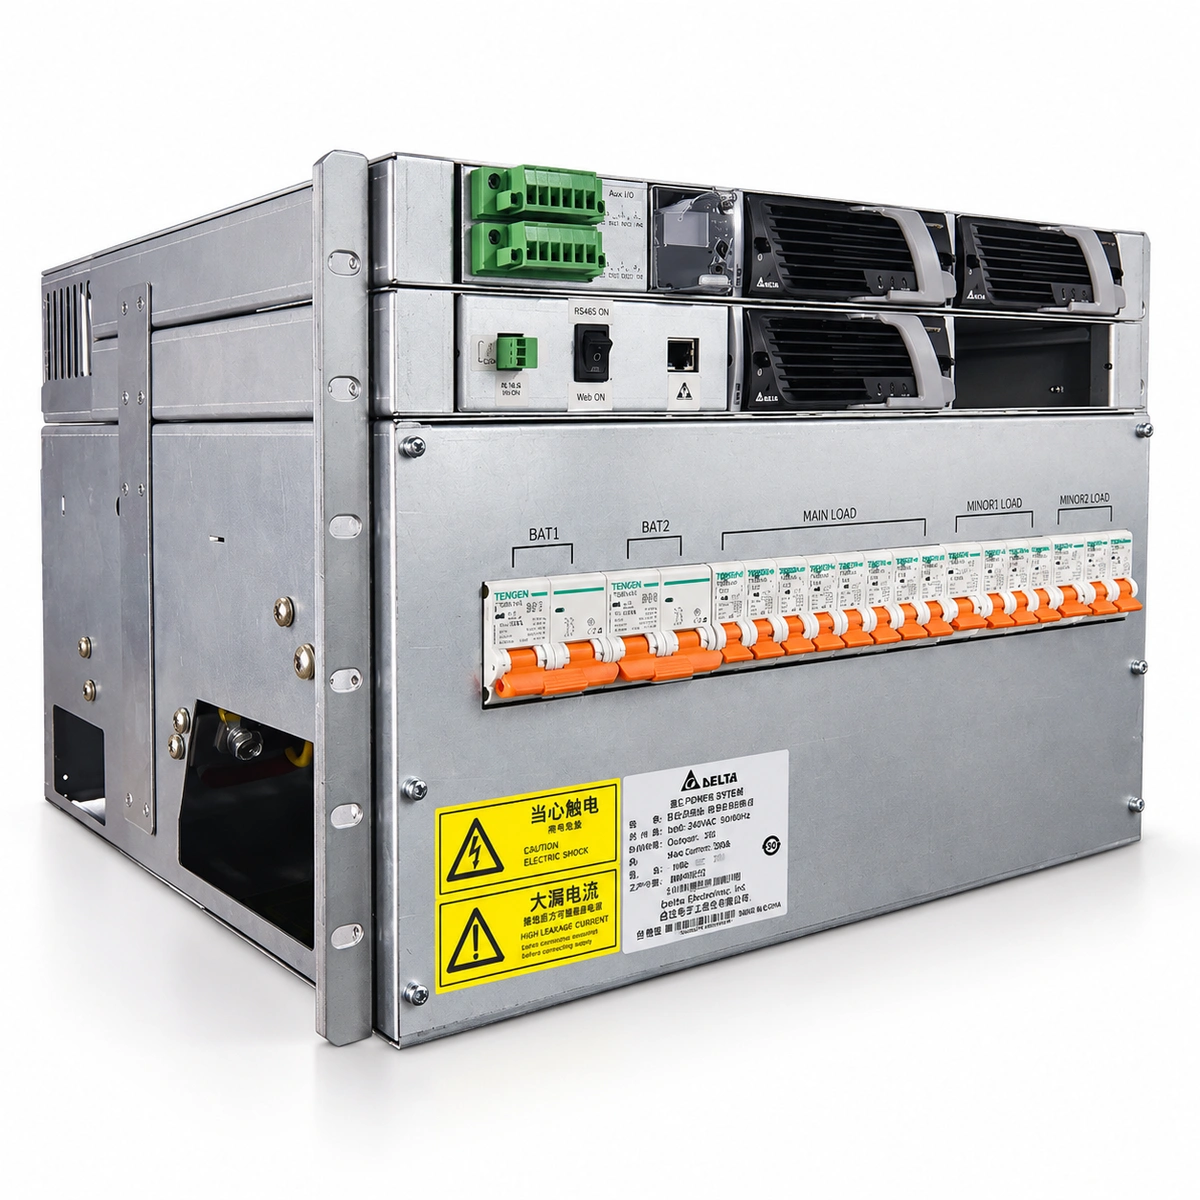
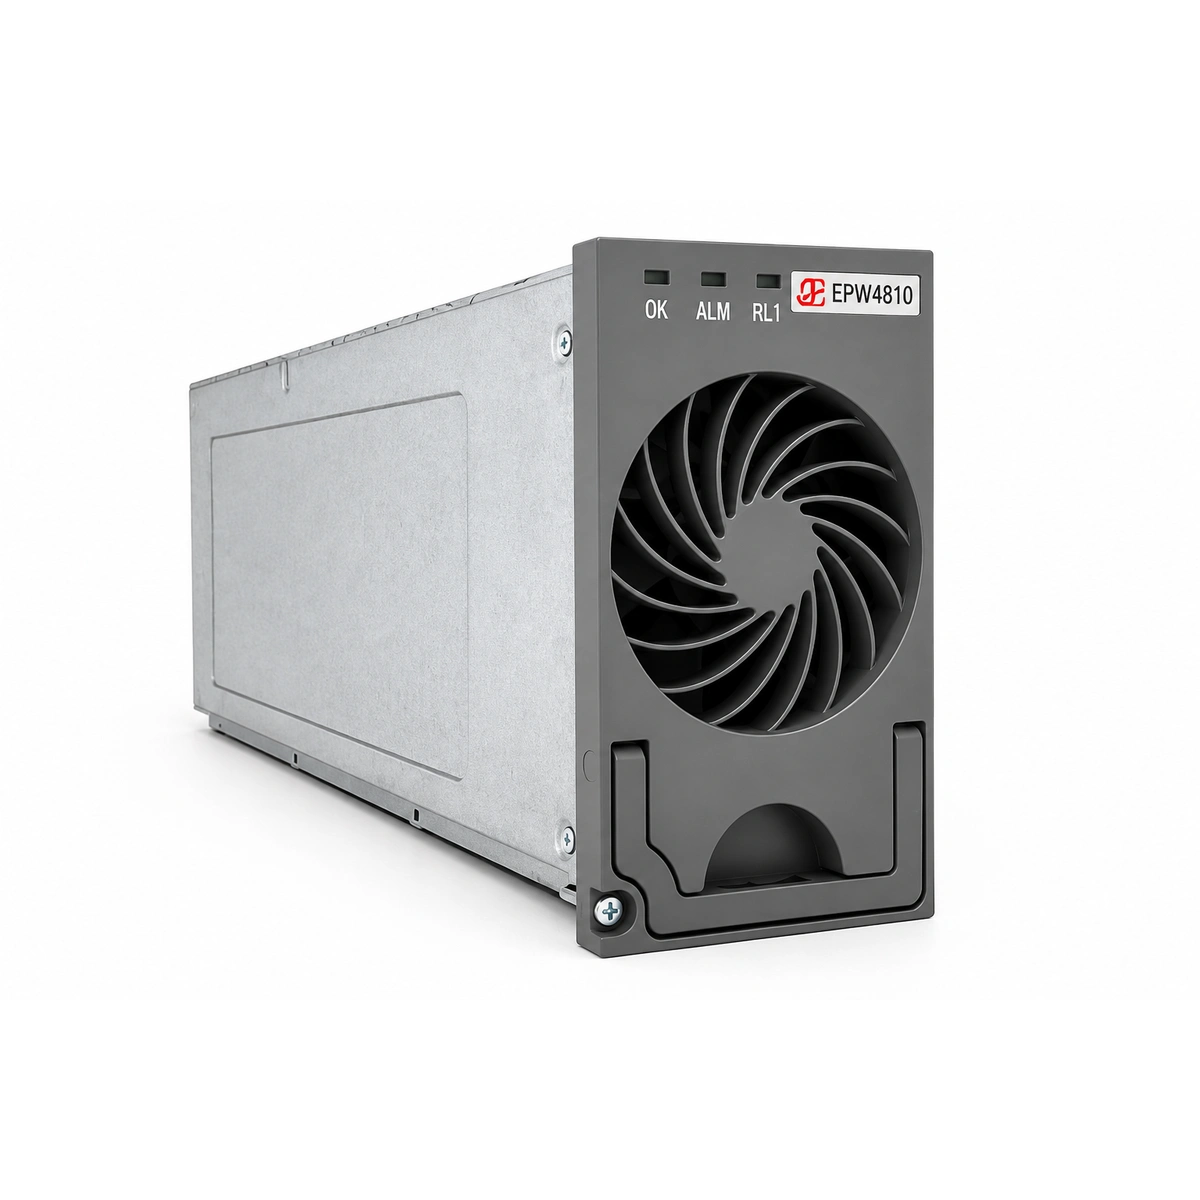
La alimentación de los tejidos ópticos de conmutación PCIe y de los trineos (sleds) de aceleración exige una infraestructura de potencia altamente desacoplada y robusta frente a fluctuaciones de carga dinámica. El estándar emergente para bastidores desagregados prescinde de fuentes de alimentación internas individuales por chasis, adoptando arquitecturas de barra colectora (busway) de corriente continua a -48V o 54V alimentadas por estantes centralizados de rectificación con redundancia N+1 o N+2. Esta configuración minimiza las pérdidas de conversión I²R y proporciona una ruta de distribución eficiente para alimentar las etapas de regulación de punto de carga (PoL) que abastecen tanto a los núcleos del conmutador de tejido inteligente como a los transductores electro-ópticos.
Un reto crítico de integridad de ingeniería reside en la gestión de cargas transitorias durante los cambios de estado de enlace PCIe (como las transiciones de ultra baja potencia L0 a L0p/L1 y de retorno a L0 activo). En un clúster desagregado de gran escala, millones de carriles PCIe pueden reactivarse simultáneamente tras la finalización de una fase de cálculo, generando perturbaciones di/dt masivas en las barras de distribución. La infraestructura de subrack debe incorporar bancos de condensadores desacopladores de respuesta ultrarrápida e interruptores estáticos de transferencia automática (ATS) de doble rama DC. Esta topología evita caídas de tensión por debajo de las tolerancias de funcionamiento de los láseres VCSEL, impidiendo de forma categórica reinicios de enlace que provocarían una partición catastrófica del tejido de conmutación distribuido.
Implementar barras colectoras de -48V/54V DC calculadas para soportar gradientes de corriente di/dt superiores a 50 A/µs sin exceder una caída de tensión transitoria del 3%.
Disponer de módulos de transferencia automática (ATS) con tiempo de conmutación inferior a 2 milisegundos para garantizar la continuidad ininterrumpida de potencia de enlace.
Configurar una redundancia de rectificadores mínima N+2 en el subrack para aislar las fluctuaciones causadas por fallas de fase en la alimentación de CA de entrada.
Estandarización, Conectividad Óptica MPO y Protocolos de Mantenimiento de Campo
El paso de pruebas de concepto hacia la industrialización masiva de PCIe óptico se encuentra regido por los lineamientos técnicos del Optical Workgroup dentro de PCI-SIG. La estandarización formal persigue definir especificaciones interoperables de conformidad electro-óptica, abarcando desde las envolventes mecánicas de conexión directa hasta la integración de conectores ópticos de acoplamiento ciego (blind-mate) en el backplane del bastidor. Estos conectores mecánicos de precisión permiten deslizar y reemplazar bandejas de cómputo completas sin necesidad de manipular manualmente cables de fibra óptica en el interior del nodo, eliminando el riesgo de curvaturas accidentales que degraden el radio mínimo de confinamiento de modo óptico.
No obstante, la fragilidad operativa en entornos de centros de datos de ultra alta densidad radica en la extrema vulnerabilidad de las terminaciones de fibra frente a la contaminación física. En interfaces multifibra MPO/MTP de 16 y 24 fibras, una partícula microscópica de polvo depositada en un núcleo óptico de 50 µm provoca una pérdida de inserción local no compensable y una reflexión destructiva que degrada el Bit Error Rate (BER) más allá del umbral corregible por el FEC. Es imperativo establecer protocolos automatizados de inspección visual de extremos de fibra según la norma IEC 61300-3-35 antes del acoplamiento ciego, complementados con telemetría predictiva continua que monitorice las corrientes de polarización y la potencia óptica recibida para anticipar fallas catastróficas de los transmisores láser antes de que ocurra una caída del clúster.
Ejecutar protocolos de limpieza e inspección automatizada bajo norma IEC 61300-3-35 en todos los puertos MPO/MTP previo a la inserción en el bastidor.
Validar la repetibilidad de inserción mecánica de backplanes blind-mate manteniendo una variación de pérdida óptica inferior a 0.15 dB tras 500 ciclos de conexión.
Implementar telemetría diagnóstica en banda para registrar la corriente de polarización del VCSEL y activar alarmas preventivas ante derivas de atenuación superiores a 1 dB.
Adquisiciones e ingeniería de soporte
Para fichas técnicas, proyectos a medida o presupuestos de exportación por volumen, comuníquese con los ingenieros de RICEWIND.