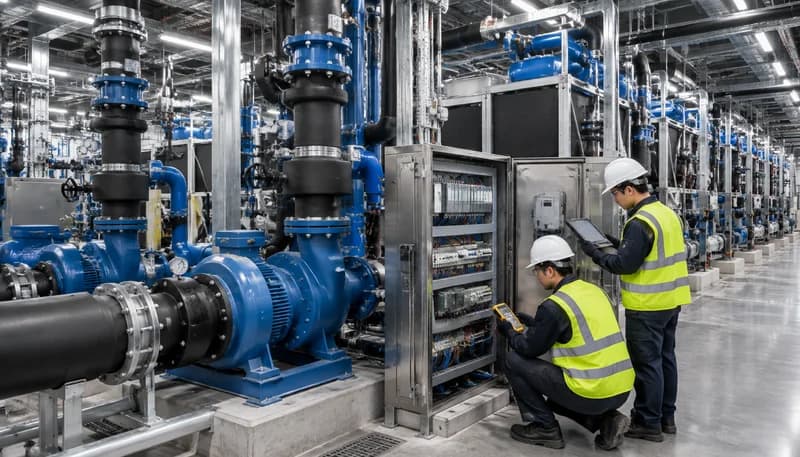
La Ilusión de la Redundancia Mecánica Frente al Acoplamiento Operativo
En el diseño electromecánico convencional de centros de datos, la topología N+1 se evalúa casi exclusivamente a través del inventario de activos físicos: enfriadoras (chillers), bombas de agua helada, unidades manejadoras de aire para salas de computación (CRAH) y unidades de distribución de refrigerante (CDU). Si una instalación demanda tres bombas primarias para disipar la carga térmica nominal y se implementa una cuarta unidad en reserva pasiva o activa, los diagramas de tuberías e instrumentación (P&ID) sugieren una disponibilidad robusta. Sin embargo, este enfoque ignora el dominio de falla operativo real, el cual no está delimitado por el aislamiento galvánico o las válvulas de retención mecánicas, sino por el perímetro de influencia que posee una anomalía singular dentro del ecosistema de control.
El acoplamiento operativo se manifiesta cuando múltiples equipos mecánicamente independientes comparten una capa de decisión común. Si cuatro bombas de velocidad variable dependen de una única secuencia de alternancia ejecutada por un autómata programable centralizado, el sistema no posee cuatro elementos redundantes, sino un único macro-sistema cuádruple supeditado a la integridad de dicho controlador. La falla del hardware del procesador, la corrupción de su memoria volátil o una interrupción en su bus de comunicaciones no inhabilita una máquina: inhabilita el tren de bombeo completo. La redundancia en placa de características es irrelevante cuando la arquitectura lógica consolida todas las rutas de habilitación en un cuello de botella algorítmico y eléctrico unificado.
Auditar los diagramas P&ID cruzándolos directamente con los esquemas unifilares de control e instrumentación para mapear dependencias cruzadas.
Definir contractualmente el radio de impacto térmico máximo permisible ante la pérdida total de cualquier nodo lógico de control.
Verificar que cada equipo clasificado como N+1 cuente con aislamiento de control galvánico y lógico respecto a sus pares redundantes.
Vulnerabilidades en la Capa de Control: BMS, PLCs Supervisores y Redes Industriales Compartidas
La centralización de la toma de decisiones en los sistemas de gestión de edificaciones (BMS) o en PLCs supervisores de planta introduce vulnerabilidades críticas que comprometen la resiliencia mecánica. Comúnmente, las redes de comunicación industrial basadas en protocolos como BACnet/IP, Modbus TCP o PROFINET se despliegan sobre infraestructuras de conmutación Ethernet compartidas sin segmentación determinista ni redundancia de medio físico mediante topologías de anillo con protocolo MRP o RSTP. Un bucle de conmutación no mitigado, una tormenta de difusión (broadcast storm) o el fallo de la fuente de alimentación de un único switch de distribución puede cegar instantáneamente a múltiples variadores de frecuencia (VFD) y controladores de CRAH, provocando su bloqueo por pérdida de consigna de comunicación.
Un vector de fallo igualmente crítico reside en la instrumentación de proceso compartida, en particular los transmisores de presión diferencial (DP) de bucle secundario. En configuraciones mal concebidas, una batería de bombas modula su velocidad basándose exclusivamente en el valor analógico promediado por un único transmisor de presión diferencial o un par no segregado eléctricamente. Si dicho lazo de corriente de 4-20 mA experimenta una pérdida de alimentación de 24 VDC compartida, un cortocircuito en bornera o una deriva por descalibración fuera de rango, el algoritmo supervisor interpreta erróneamente un exceso o caída de presión. Esto induce la rampa descendente de todos los impulsores hasta el flujo mínimo o su parada por enclavamiento de seguridad, consumando la pérdida total de la disipación térmica sin que exista una sola falla mecánica en los motores.
Implementar instrumentación triple modular redundante (2oo3) para variables críticas de proceso como la presión diferencial de cabezal y temperatura de suministro.
Segregar físicamente los switches de red industrial mediante anillos redundantes e inmunes a fallas simples de alimentación de control.
Distribuir fuentes de alimentación ininterrumpida de 24 VDC independientes y con aislamiento galvánico por cada panel de control y VFD.
Proliferación de Refrigeración Líquida y CDUs: Multiplicación del Dominio de Falla
La transición hacia densidades térmicas extremas impulsadas por cargas de trabajo de inteligencia artificial ha acelerado la adopción de refrigeración líquida directa al chip (Direct-to-Chip DLC) orquestada mediante Unidades de Distribución de Refrigerante (CDU). A diferencia de los sistemas de aire tradicionales, las CDUs operan con una inercia térmica drásticamente reducida: ante la pérdida de flujo en el bucle secundario (Technology Cooling System o TCS), la ventana temporal antes de alcanzar el estrangulamiento térmico (thermal throttling) o el daño estructural del silicio se mide en segundos, no en decenas de minutos. Cada CDU integra internamente bombas redundantes, intercambiadores de calor de placas, válvulas de control proporcionales motorizadas y sofisticados sistemas de detección de fugas por cable sensor resistivo.
La proliferación masiva de estas unidades en la sala blanca amplifica exponencialmente las interdependencias ocultas. Frecuentemente, decenas de CDUs se integran mediante enlaces seriales RS-485 daisy-chain o enlaces Ethernet multipunto hacia un concentrador o pasarela de comunicaciones común. Un fallo en el transceptor de una sola unidad o una colisión de paquetes en el bus de campo puede colapsar la telemetría y el comando de modulación de toda la fila de servidores. Asimismo, si la orquestación del balance de presión entre los bucles primario (FWS) y secundario (TCS) depende de un lazo supervisor externo que coordina la apertura de válvulas de control modulantes mediante consignas remotas, la pérdida de dicho enlace puede inducir cavitación simultánea en las bombas de múltiples CDUs o la congelación/ebullición localizada en las placas frías.
Prohibir el encadenamiento en serie simple (daisy-chain) de comunicaciones para el lazo de modulación y protección térmica de CDUs en arquitecturas de alta densidad.
Verificar que el algoritmo interno de cada CDU sea plenamente autónomo para regular el caudal del bucle TCS sin requerir latidos (heartbeats) del BMS.
Establecer sistemas de contención y aislamiento de fugas con enclavamientos locales cableados que no dependan del software del supervisor central.
Diseño para Degradación Elegante: Lazos Locales Autónomos y Respaldos Cableados
La ingeniería de alta disponibilidad en centros de datos debe asumir el postulado de que toda red y sistema supervisor fallará eventualmente. La estrategia fundamental radica en diseñar para una degradación elegante (graceful degradation), asegurando que la pérdida del control supervisor degrade la eficiencia energética de la planta, pero jamás su capacidad bruta de enfriamiento. Esto se logra descentralizando la lógica de control mediante el confinamiento de los lazos Proporcional-Integral-Derivativo (PID) en los controladores locales dedicados de cada máquina (por ejemplo, directamente embebidos en el VFD o en el microcontrolador de la unidad terminal), dejando al BMS únicamente la optimización de consignas y la recopilación histórica.
En caso de una pérdida confirmada de comunicaciones —detectada mediante temporizadores watchdog por software y hardware—, el equipo local debe transicionar de forma determinista a un estado seguro predefinido (fail-safe). Para bombas y ventiladores de velocidad variable, esta condición debe forzar la operación a una velocidad fija de contingencia (típicamente entre el 80% y el 100% de la capacidad nominal) o recurrir a un sensor analógico cableado localmente en bornes del propio convertidor. Simultáneamente, deben existir relés de respaldo cableados (hardwired bypass) que ignoren los circuitos de habilitación por software ante disparos térmicos globales, garantizando que los contactores de bypass o las entradas digitales forzadas mantengan los sistemas hidráulicos en circulación ininterrumpida.
Configurar temporizadores de pérdida de comunicación (watchdog) en VFDs y CDUs que conmuten a consignas de velocidad de contingencia en menos de 2 segundos.
Confinar la ejecución de los lazos PID de presión y caudal al firmware local del convertidor o controlador de unidad, prohibiendo el cierre de lazo sobre BACnet/IP.
Incorporar conmutadores manuales locales de tres posiciones (Hand-Off-Auto) con cableado físico directo a las etapas de potencia de los motores.
Protocolos Avanzados de Comisionamiento: Pruebas del Dominio de Falla Real
Las pruebas funcionales tradicionales de puesta en marcha suelen limitarse a validar la alternancia de equipos en condiciones ideales: se desenergiza la bomba principal y se cronometra el arranque de la bomba en reserva. Este procedimiento es fundamentalmente insuficiente para certificar la resiliencia operativa, ya que evalúa la funcionalidad del activo mecánico bajo el supuesto de que la infraestructura de supervisión e instrumentación permanece completamente operativa. No valida la respuesta del sistema cuando la entidad que emite la orden de alternancia es la que experimenta el fallo catastrófico.
El comisionamiento de nivel 4 y 5 debe incorporar pruebas de estrés destructivas a nivel de control (Integrated Systems Testing orientado a dominios de falla). Los protocolos deben exigir: la desenergización súbita de paneles PLC centrales durante estados de máxima carga de prueba con bancos de carga resistivos; la desconexión física de enlaces de fibra óptica en switches de distribución; la inyección de señales analógicas corruptas (abriendo el circuito del transmisor de DP para simular rotura de cable o cortocircuitándolo a tierra); y la interrupción de la fuente común de 24 VDC. La métrica de éxito no reside en la ausencia de alarmas, sino en la capacidad empíricamente demostrada de la planta para sostener el caudal volumétrico y las temperaturas de impulsión dentro de los límites de la envolvente térmica ASHRAE TC 9.9 sin intervención humana.
Ejecutar pruebas funcionales de corte total de red industrial con carga térmica plena, validando el comportamiento autónomo de los controladores de unidad.
Simular fallos de lazo analógico (rotura de cable y saturación a fondo de escala) en sensores de presión diferencial críticos durante la marcha de los grupos de bombeo.
Registrar mediante analizadores de transitorios y telemetría de alta velocidad que el tiempo de recuperación hidráulica no provoque excursiones térmicas en los racks.
Lista de Verificación de Ingeniería y Gobernanza para Centros de Datos de Alta Densidad
La mitigación sistemática de los dominios de falla ocultos en instalaciones de inteligencia artificial y computación de alto rendimiento (HPC) requiere un marco estricto de gobernanza técnica desde la fase de diseño conceptual hasta las operaciones de Día 2. La arquitectura de control debe ser sometida a un Análisis de Modos de Falla y Efectos (FMEA) centrado exclusivamente en la capa de software, firmware, instrumentación y redes OT. Cada interconexión de red, pasarela de conversión de protocolos y fuente de alimentación auxiliar debe ser tratada analíticamente como un potencial vector de interrupción de servicio para todo el subsistema dependiente.
Finalmente, la gestión de cambios (Change Management) en las lógicas de programación de los controladores supervisores debe someterse a controles tan rigurosos como los despliegues de software crítico. Ninguna actualización de firmware en PLCs o VFDs, modificación de parámetros PID en el BMS o reconfiguración de tablas de ruteo en switches industriales debe ejecutarse sin una verificación exhaustiva en un entorno de gemelo digital o banco de pruebas desacoplado. La gobernanza de la resiliencia exige que cualquier alteración en el código de control garantice que la autonomía de los lazos locales y los mecanismos de degradación elegante permanezcan inalterados y plenamente operacionales.
Documentar y actualizar formalmente la matriz FMEA de automatización e instrumentación antes de cada ciclo de recertificación operativa.
Establecer una política estricta de bloqueo de escritura remota en parámetros críticos de seguridad de los variadores y controladores de CDU.
Realizar simulacros semestrales de pérdida de supervisorio BMS con el personal de operaciones de planta para revalidar la respuesta ante contingencias.
Adquisiciones e ingeniería de soporte
Para fichas técnicas, proyectos a medida o presupuestos de exportación por volumen, comuníquese con los ingenieros de HEFENGQI.