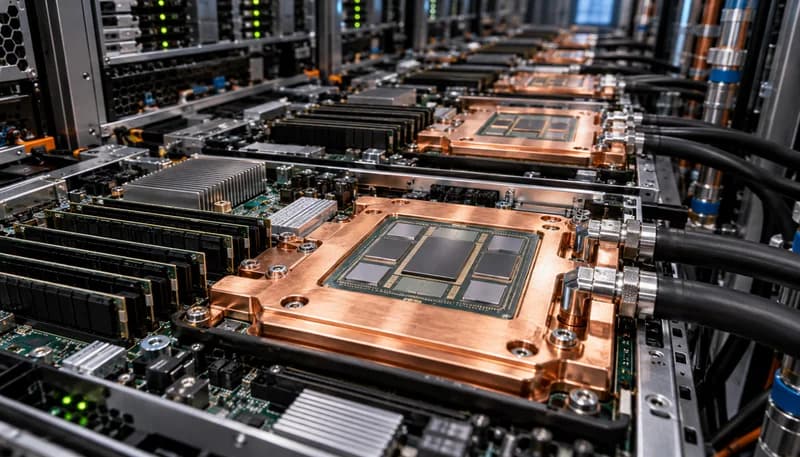
El límite del retículo monolítico: Imperativos físicos y económicos hacia la desagregación 2.5D/3D
Durante más de cinco décadas, la microarquitectura de servidores dependió de la integración sobre matrices monolíticas continuas de silicio. Sin embargo, la física del escalado de semiconductores ha colisionado de forma definitiva con el límite de campo de retículo de la litografía por inmersión ultravioleta profunda (DUV) y ultravioleta extrema (EUV), fijado rígidamente en torno a los 858 mm². La fabricación de matrices que rozan esta cota máxima para satisfacer las demandas de entrenamiento de modelos masivos de lenguaje (LLM) y cargas multi-inquilino de alta densidad conduce a una caída exponencial del rendimiento de fabricación (yield). De acuerdo con el modelo probabilístico de defectos de Murphy y Seeds, a medida que el área del silicio se aproxima a la superficie total de exposición del escáner, los defectos aleatorios reducen el porcentaje de obleas viables a márgenes financieramente inviables en nodos de vanguardia por debajo de los 3 nm.
La desagregación modular mediante chiplets resuelve esta asimetría económica segregando las funciones del procesador en dominios de silicio independientes: núcleos de procesamiento aritmético, controladores de entrada/salida (I/O) y bloques de memoria caché de alta densidad o controladores HBM (High Bandwidth Memory). Esta partición permite un despliegue litográfico heterogéneo donde la lógica pura de procesamiento se proyecta en nodos de última generación (como N3 o N2), mientras que la circuitería analógica, las capas físicas (PHY) de comunicación y los subsistemas de alimentación se fabrican en nodos maduros y amortizados (tales como N6, N7 o N12). El ensamblaje de estos componentes dispares sobre sustratos de empaquetado avanzado de silicio o silicio-puente (2.5D) y apilamiento vertical (3D) restaura la viabilidad del rendimiento industrial, recortando los tiempos de iteración arquitectónica y los costes por oblea de silicio útil hasta en un 40%.
Superación del techo de exposición litográfica fijado en 858 mm² mediante segmentación modular de funciones de cómputo y periféricos.
Optimización del coste por oblea combinando lógica crítica en nodos N3/N2 con capas analógicas e I/O en nodos maduros N7/N12.
Adopción de tecnologías de sustrato avanzado (CoWoS, EMIB) con pasos de micro-bumps inferiores a 25 µm para mitigar pérdidas de rendimiento de área.
Arquitecturas de interconexión Die-to-Die: Estándar UCIe, latencia sub-nanosegundo y enrutamiento en interposers
La viabilidad de una microarquitectura desagregada depende intrínsecamente de que la frontera física entre matrices no degrade las características lógicas ni temporales del bus de comunicación interno. El consorcio Universal Chiplet Interconnect Express (UCIe) ha estandarizado la interfaz de señalización Die-to-Die (D2D), proporcionando anchos de banda que alcanzan los 32 Gbps por línea en sus revisiones avanzadas. Al implementarse sobre interposers pasivos de silicio con vías a través de silicio (TSV) o mediante puentes de silicio embebidos en el sustrato orgánico, se reduce drásticamente la capacitancia parásita de la traza de señal a niveles inferiores a 0.2 pF. Esto permite alcanzar una eficiencia energética ultra-agresiva por debajo de 0.5 pJ/bit, garantizando densidades lineales de ancho de banda (beachfront density) que superan varios Tbps/mm de borde de die.
A nivel microarquitectónico, el acoplamiento die-to-die impone mantener la coherencia de memoria y el arbitraje de transferencias con latencias que compitan directamente con los buses intramatriz convencionales. Los protocolos UCIe encapsulan capas físicas optimizadas para interactuar nativamente con transacciones CXL (Compute Express Link) y PCIe 6.0/7.0, introduciendo penalizaciones de propagación inferiores a 2 ns entre chiplets adyacentes. El enrutamiento de miles de pistas simultáneas a través del interposer demanda un control estricto de la diafonía (crosstalk) capacitiva e inductiva mediante planos de masa intercalados, apantallamientos coplanares de alta precisión y esquemas de ecualización activa de canal a fin de mantener tasas de error de bit (BER) por debajo de 10^-27 sin requerir codificaciones de corrección de errores (FEC) con alta sobrecarga de procesamiento.
Tasas de transferencia de hasta 32 Gbps/línea bajo especificaciones UCIe con eficiencia energética nominal <0.5 pJ/bit.
Presupuesto de latencia añadida en la frontera die-to-die estrictamente acotado por debajo de 2 ns para preservar coherencia de caché a nivel de zócalo.
Diseño de apantallamiento en interposer para mitigar diafonía electromagnética con una tasa de error de bit intrínseca inferior a 10^-27.
Regulación de tensión sub-voltio: Mitigación de transitorios di/dt extremos mediante 48V-to-PoL e IVR
La segregación en múltiples matrices de procesamiento alimentadas sincrónicamente acentúa drásticamente las no linealidades de la red de distribución de energía (PDN). Los núcleos de cómputo avanzados operan a tensiones nominales sub-voltio extremadamente reducidas, situadas habitualmente en el rango de 0.70V a 0.75V Vcore. La agregación de decenas de clústeres de cómputo en un único encapsulado demanda corrientes estáticas que sobrepasan con facilidad los 1000 A a 1500 A. La criticidad reside en los gradientes dinámicos de carga: los ciclos de conmutación de bloques de ejecución vectorial y matricial en algoritmos de aprendizaje profundo generan tasas de variación de corriente di/dt superiores a los 1500 A/μs. Cualquier inductancia residual parasitaria en el lazo de alimentación provoca una caída de tensión inducida L*(di/dt) capaz de quebrar la ventana de tolerancia de ±30 mV, induciendo bloqueos de reloj (clock stalls) o fallos lógicos catastróficos.
Para contener esta degradación, las arquitecturas de alimentación convencionales basadas en caídas intermedias a 12V han sido reemplazadas por esquemas directos de 48V/54V hacia el punto de carga (Point-of-Load, PoL). La integración de reguladores de tensión integrados (IVR) y convertidores de condensadores conmutados (SCC) directamente embebidos en el sustrato del encapsulado permite una conversión de dos etapas de ultra-alta frecuencia (operando en el rango de decenas de MHz). La evolución hacia la entrega vertical de energía (Vertical Power Delivery, VPD), donde los módulos de regulación de tensión se sitúan directamente debajo del interposer y de las matrices de silicio mediante acoplamiento por micro-bumps invertidos, reduce la longitud del bucle de conducción de corriente a fracciones de milímetro. Esta geometría minimiza la resistencia I²R y la inductancia parásita de la ruta en más de un 80%, estabilizando la impedancia de la PDN por debajo de 0.1 mΩ desde corriente continua hasta los 100 MHz.
Control estricto de la caída inductiva (voltage droop) por debajo de 30 mV ante gradientes transitorios de carga di/dt >1500 A/μs a 0.75V Vcore.
Migración de la topología de distribución a 48V/54V Point-of-Load minimizando pérdidas resistivas de transporte I²R.
Implementación de arquitectura Vertical Power Delivery (VPD) situando los IVRs directamente bajo el silicio para eliminar la inductancia lateral de las pistas.
Desafíos del flujo térmico microscópico: Placas frías de microcanales, interfaces térmicas y degradación
La agregación de núcleos y la proximidad física impuesta por las interconexiones cortas concentran la energía disipada en áreas sumamente reducidas. Mientras que los procesadores monolíticos exhibían una disipación térmica extendida y relativamente uniforme, las arquitecturas compuestas por chiplets presentan heterogeneidad espacial extrema: los chiplets de cómputo N3 alcanzan densidades de flujo térmico locales que superan holgadamente los 100 W/cm² a 150 W/cm², flanqueados por matrices I/O o HBM que disipan potencias sustancialmente menores pero imponen límites térmicos críticos (habitualmente <85°C para evitar la degradación de retención en DRAM). Esta coexistencia genera gradientes térmicos intramatriz con diferenciales locales superiores a 40°C en distancias submilimétricas, induciendo tensiones mecánicas severas por expansión térmica diferencial (CTE mismatch) entre el silicio, el interposer y las resinas epoxi de relleno (underfill).
Los disipadores pasivos de aire combinados con cámaras de vapor son incapaces de evacuar estos flujos térmicos microscópicos sin penalizar la temperatura máxima de unión (Tj_max). La solución de ingeniería mandatoria es la refrigeración líquida directa al chip (Direct-to-Chip, D2C) mediante placas frías de cobre electrolítico diseñadas con microcanales internos con aletas de espesor inferior a 50 µm y geometrías de flujo turbulento multivia. El material de interfaz térmica (TIM) entre la parte posterior del silicio (lapeada para reducir espesor) y la base de la placa fría constituye el principal estrangulamiento de resistencia térmica. Se abandonan las pastas poliméricas tradicionales en favor de aleaciones de metal líquido basadas en galio-indio-estaño (GaInSn) o láminas de cambio de fase (PCM) orientadas metalográficamente, las cuales ofrecen conductividades térmicas efectivas >30 W/m·K. Paralelamente, el diseño mecánico debe incorporar fijaciones perimetrales con precarga de resortes calibrados para mitigar el efecto de expulsión por fatiga térmica cíclica (TIM pump-out).
Evacuación de flujos térmicos localizados >100 W/cm² en matrices de cómputo manteniendo el diferencial Tj respecto al HBM bajo control.
Uso de placas frías de microcanales con densidad de micro-aletas sub-50 µm y regímenes hidráulicos de transición controlada.
Despliegue de materiales de interfaz térmica (TIM) de metal líquido o PCM con conductividad >30 W/m·K y resistencia Rth, j-c <0.05 °C·cm²/W.
Densificación de plataforma y bastidor: Barras colectoras de 54V, Power Shelves y restricciones mecánicas ORV3
La integración de hasta 256 núcleos heterogéneos y múltiples aceleradores por nodo de computación eleva el consumo energético por unidad de bastidor (1U/2U) a cifras comprendidas entre 1.5 kW y 3 kW por servidor. Al escalar esta densidad a nivel de rack en envolventes de arquitectura abierta Open Rack Standard v3 (ORV3), los límites de la infraestructura física alcanzan nuevas cotas operativas. Distribuir estas densidades mediante el estándar histórico de 12V exigiría barras colectoras que gestionen más de 8000 A en el backplane, lo cual implicaría secciones de cobre descomunales, pérdidas óhmicas inasumibles y una inviabilidad electromecánica total. En consecuencia, el estándar ORV3 fija la distribución en un plano unificado de 48V a 54V nominales mediante una barra colectora sólida centralizada.
La conversión eléctrica se desacopla de los chasis de computación individuales y se centraliza en estantes dedicados (Power Shelves) de alta eficiencia. Estos módulos integran fuentes de alimentación (PSU) en topologías redundantes N+M con certificación Titanium (>96.5% de eficiencia a cargas operativas típicas) y factores de potencia activos >0.99. Mecánicamente, los racks deben soportar pesos estáticos superiores a los 1400 kg derivados de la densidad combinada de cobre, manifolds hidráulicos de acero inoxidable y el inventario de fluido refrigerante presurizado. Se requiere el despliegue de conectores rápidos de inserción a ciegas (blind-mate fluid and power couplings) libres de goteo, los cuales combinan el enclavamiento eléctrico a la barra colectora de 54V con el acoplamiento hidráulico hermético en una única maniobra de inserción mecánica del chasis, minimizando el riesgo operacional por descargas de arco o fugas.
Integración de barras colectoras de 48V/54V en arquitectura ORV3 reduciendo corrientes de distribución y secciones conductoras de cobre.
Implementación de Power Shelves con fuentes Titanium que aseguran eficiencias de conversión energética superiores al 96.5%.
Configuración mecánica y estructural para soportar cargas estáticas >1400 kg con acoplamientos combinados blind-mate sin pérdidas de fluido.
Ingeniería de infraestructura hyperscale: Adaptación brownfield para racks refrigerados por líquido de 60 kW a 120 kW
El impacto de la desagregación modular por chiplets trasciende la placa base y el bastidor, reconfigurando la planta física de las instalaciones hyperscale. Los centros de datos heredados (brownfield), diseñados primariamente para disipar densidades térmicas de 10 kW a 20 kW por rack mediante climatización convencional por expansión directa (DX) y pisos elevados de aire forzado, no disponen de la capacidad aerodinámica ni volumétrica para absorber clusters densificados con chiplets, cuyos perfiles energéticos oscilan de 60 kW a más de 120 kW por rack. La reconversión física de estas salas blancas exige el tendido de tuberías matrices de transporte hidráulico para distribución de líquido refrigerante hacia unidades de distribución de refrigeración intermedias (CDU, Cooling Distribution Units) ubicadas en fila o integradas en la base del bastidor.
Las CDUs aíslan hidráulicamente el circuito de bucle primario de la instalación del bucle secundario que circula directamente por las placas frías de los servidores, controlando de manera dinámica la presión, el balance químico, la conductividad eléctrica del agua tratada y previniendo la formación de condensación mediante el control del punto de rocío ambiental. Este enfoque viabiliza la operación bajo la envolvente térmica ASHRAE Líquido W4 (temperaturas de suministro de agua de hasta 45°C). Al operar a 45°C en la entrada de la placa fría, la planta física prescinde totalmente del uso de enfriadoras mecánicas por compresión de vapor (chillers), disipando el calor directamente a la atmósfera mediante torres de refrigeración de circuito cerrado o dry coolers adiabáticos. Esta arquitectura térmica reduce drásticamente el consumo parásito del centro de datos, permitiendo proyectar y alcanzar factores de efectividad del uso de energía (PUE) anualizados inferiores a 1.15 a máxima densidad de carga computacional.
Integración de CDUs para desacoplar bucles primarios y secundarios asegurando caudales de 2 a 4 L/min por kilovatio a nivel de rack.
Operación hidráulica bajo el estándar ASHRAE W4 con agua de entrada a 45°C habilitando disipación 100% por economizadores secos (chiller-less).
Optimización de la eficiencia del centro de datos alcanzando un factor PUE anualizado inferior a 1.15 en envolventes de 60 kW a 120 kW por bastidor.
Adquisiciones e ingeniería de soporte
Para fichas técnicas, proyectos a medida o presupuestos de exportación por volumen, comuníquese con los ingenieros de HEFENGQI.