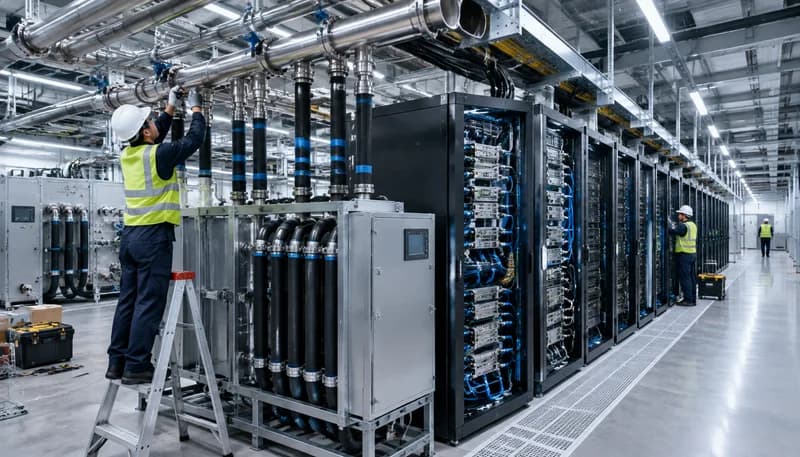
Das Distressed-Asset-Playbook: Konvertierung von Chapter-11-Rohbauten in 73-MW-AI-Compute-Hubs
Die Akquisition unvollendeter Rechenzentrumsprojekte aus Insolvenzverfahren nach Chapter 11 bietet institutionellen Betreibern signifikante Geschwindigkeits- und Kostenvorteile gegenüber Greenfield-Entwicklungen. Am Fallbeispiel des RELLIS-Campus des Texas A&M University Systems (TAMUS) zeigt sich das enorme Potenzial gestrandeter Liegenschaften: Ursprünglich für konventionelle Colocation und administrative Nutzungen konzipiert, wurde der Standort nach Insolvenz des Erstentwicklers neu evaluiert. Das primäre Ziel eines solchen Turnarounds besteht darin, vorhandene Tiefbau-, Rohbau- und Trassenrechte in einen deterministischen 73-MW-Gesamtentwicklungsplan zu integrieren, ohne die baulichen Ineffizienzen des Vorgängerdesigns zu übernehmen.
Aus bautechnischer und finanzieller Sicht verkürzt die Umnutzung eines Rohbaus die Time-to-Market um 12 bis 18 Monate, da langwierige Baugenehmigungsverfahren, Umweltverträglichkeitsprüfungen und die grundlegende Standorterschließung bereits vorliegen. Voraussetzung für die wirtschaftliche Tragfähigkeit ist eine kompromisslose technische Due-Diligence. Es muss detailliert analysiert werden, in welchem Maße Fundamente, Schachtabmessungen und Trassenbelegungen verwertbar sind. Die bestehende Bausubstanz wird hierbei als Hülle betrachtet, deren innerer Grundriss komplett entkernt und für extreme Energiedichten von bis zu 50 kW/m² neu dimensioniert wird.
Durchführung einer statischen und bauphysikalischen Due-Diligence zur Identifikation von Tragwerksreserven im Fundamentbereich.
Validierung bestehender Mittelspannungs-Trassen, Grunddienstbarkeiten und behördlicher Vorabgenehmigungen.
Kapital- und Bauzeiten-Arbitrage: Sicherstellung eines Kostenvorteils von mindestens 30 % gegenüber einer Greenfield-Neuentwicklung.
Strukturelle und räumliche Neuausrichtung: Ertüchtigung von Standard-Bodenplatten für 100-kW+-GPU-Racks
Konventionelle Rechenzentren und Büroflächen sind typischerweise für Flächenlasten von 10 bis 12 kN/m² ausgelegt – dimensioniert für Standard-IT-Racks mit maximal 15 kW Leistungsaufnahme und geringem Eigengewicht. Moderne High-Density-GPU-Architekturen, wie flüssigkeitsgekühlte NVIDIA HGX- und Blackwell-Systeme, erreichen voll bestückt Massen von bis zu 1.800 kg pro Rack, was bei Grundflächen von unter einem Quadratmeter Punkt- und Flächenlasten von 25 bis 35 kN/m² hervorruft. Die Umnutzung von vormaligen Lehr- und Büroflächen erfordert daher die vollständige Entfernung von Estrichschichten und leichten Zwischenwänden sowie eine strukturelle Verstärkung der tragenden Stahlbeton-Bodenplatte.
Zur baulichen Ertüchtigung werden ober- und unterseitige Lamellen aus kohlenstofffaserverstärktem Kunststoff (CFK) in Kombination mit gezielten Stahlunterzügen in den Kriechkellern oder Fundamentebenen eingebracht. Das traditionelle Konzept des doppelten Bodens (Raised Floor) wird vollständig eliminiert, da Hohlraumböden bei derartigen Punktlasten strukturell versagen und die Strömungsmechanik behindern. Racks werden stattdessen direkt auf dem schwingungsentkoppelten Schwerlast-Betonboden platziert, während die Medienzuführungen für Leistungselektronik und Kühlmittel über oberhalb geführte Schwerlast-Tragsysteme (Overhead Steel Unistrut Grids) realisiert werden.
Erhöhung der zulässigen Traglast auf mindestens 30 kN/m² mittels CFK-Lamellenverstärkung der Betonverbundsohle.
Vollständige Umstellung auf deckenmontierte Medienführung (Busways und Kühlmittelrohre) zur Vermeidung von Bodenüberlastungen.
Strukturelle Entkopplung von mechanischen Pumpen- und Kältemaschinenstandorten zur Verhinderung von Schwingungsübertragungen auf optische Komponenten.
Thermische Transformation: Migration von Niedrigdichte-Luftkühlung zu Direct-to-Chip-Kreisläufen mit PGW
Die im Ursprungsdesign vorgesehene Raumluftkühlung stößt bei thermischen Dichten von über 30 kW pro Rack an physikalische Grenzen, da unzumutbare Luftgeschwindigkeiten und inakzeptable Temperaturgradienten entstehen würden. Die thermische Transformation hin zu 100 kW+ pro Rack erfordert eine lückenlose Umstellung auf Direct-to-Chip (D2C) Flüssigkeitskühlung. Hierbei wird ein geschlossener Sekundärkreislauf (Technology Cooling System, TCS) implementiert, der mit einem inhibierten Propylenglykol-Wasser-Gemisch (PG25 bis PG30, 25–30 % Glykolanteil) betrieben wird. Dieses Fluid garantiert verlässlichen Frostschutz im Außenbereich, minimiert die Viskositätsverluste und verhindert über maßgeschneiderte Korrosionsinhibitoren galvanische Prozesse zwischen Kupfer-Kühlkörpern und Edelstahl-Verrohrungen.
Das thermische Design zielt auf eine Vorlauftemperatur von 32 °C bis 35 °C (ASHRAE W32/W35) ab, wodurch der Primärkreislauf bei typischen texanischen Spitzen-Außentemperaturen von bis zu 42 °C im reinen Freikühlbetrieb (Dry Cooler mit adiabater Vorkühlung) ohne energieintensive mechanische Kompressionskältemaschinen betrieben werden kann. Die Kühlverteilereinheiten (Cooling Distribution Units, CDUs) werden für sekundärseitige Differenzdrücke von 180 bis 250 kPa ausgelegt, um den hydraulischen Strömungswiderstand in den Mikrokanal-Kühlblöcken der GPUs und internen Rack-Manifolds verlustarm zu überwinden. Dies ermöglicht die Realisierung eines PUE-Werts von unter 1,15 unter Volllastbedingungen.
Implementierung von D2C-Kühlkreisläufen mit 25–30 % inhibiertem Propylenglykol-Wasser-Gemisch (PG25/PG30).
Auslegung des sekundären Kühlmittelkreislaufs auf Vorlauftemperaturen von 32 °C bis 35 °C für ganzjährigen Freikühlbetrieb.
Dimensionierung der CDU-Pumpenförderhöhe auf sekundärseitig 180–250 kPa bei maximal zulässigen Fließgeschwindigkeiten von 1,5 m/s.
Netzanbindung und Umspannwerk-Phasierung: BTU-Kapazitäten und ERCOT-Lastrampen
Die Bereitstellung von 73 MW IT-Leistung an einem Universitäts-Campusstandort stellt erhebliche Anforderungen an den lokalen Energieversorger Bryan Texas Utilities (BTU) und das ERCOT-Übertragungsnetz. Da KI-Cluster extrem dynamische Lastschwankungen aufweisen – mit Lastwechseln von mehreren Dutzend Megawatt innerhalb von Millisekunden bei Beginn oder Abbruch von Modell-Trainingsiterationen –, muss der Netzanschluss über ein phasenbasiertes Modell realisiert werden. Die Initialphase sichert typischerweise 18 bis 20 MW ab, während parallel dazu der Bau eines dedizierten 138/12,47-kV-Umspannwerks mit N+1-redundanten Transformatoren vorangetrieben wird, um die volle Kapazität von 73 MW netzverträglich aufzunehmen.
Zur Einhaltung der strengen ERCOT-Netzanschlussbedingungen müssen softwaregestützte und hardwarebasierte Lastrampen-Kontrollen (Ramp-Rate Mitigation) integriert werden, die den Lastanstieg auf maximal 2 bis 5 MW pro Minute drosseln, um Netzinstabilitäten und Frequenzabweichungen zu verhindern. Im Inneren der Facility erfolgt die Energieverteilung zunehmend über moderne Gleichstromarchitekturen (800V DC oder rackbasiert 48V DC). Dadurch entfallen mehrfache AC-DC- und DC-AC-Wandlungsstufen in unterbrechungsfreien Stromversorgungen (USV) und Netzteilen, was den Gesamtwirkungsgrad des elektrischen Pfads um 3 bis 5 % steigert und die thermische Abwärme im Weißraum drastisch reduziert.
Phasierung des Netzanschlusses mit Stufen von initial 18 MW bis zur Zielkapazität von 73 MW am BTU-Knotenpunkt.
Integration von Microgrid-Controllern und Lastrampen-Management zur Einhaltung von ERCOT-Grenzwerten (< 5 MW/min Lastanstieg).
Einsatz von 48-V- oder 800-V-DC-Verteilungsarchitekturen zur Reduzierung von Wandlungsverlusten und Minimierung der Leitungsquerschnitte.
Sovereign-AI-Architektur: Verifizierbare Governance, Data Lineage und ITAR/FedRAMP-Enklaven
Die infrastrukturelle Realisierung von „Sovereign AI“ erfordert mehr als bloße physikalische Standortsicherung: Es bedarf einer vollständig verifizierbaren Governance-Architektur über Datenflüsse, Modellgewichte und Ausführungsumgebungen. Durch die Implementierung von Frameworks wie dem Amalgamy.AI-Software-Stack auf jedem GPU-Rechenknoten wird sichergestellt, dass Identitäten, Zugriffsrechte und Workload-Zustände lückenlos kryptografisch attestiert werden. Dies adressiert die regulatorischen Auflagen sensibler Sektoren wie Verteidigung, Energiewirtschaft und Gesundheitswesen.
Technisch wird die Souveränität durch Hardware Root of Trust (RoT), Confidential Computing (z. B. verschlüsselte Enklaven via AMD SEV-SNP oder NVIDIA Confidential Computing) und netzwerkseitige Mikrosegmentierung durchgesetzt. Die Netzwerktopologie wird in isolierte Mandanten-Fabrics (EVPN-VXLAN) unterteilt, wodurch logische und physische Sicherheitszonen geschaffen werden, die strikt konform zu FedRAMP-High-, ITAR- (International Traffic in Arms Regulations) und NIST 800-171/53-Standards sind. Trainingsdaten-Lineage wird über unveränderliche kryptografische Audit-Trails protokolliert, sodass Manipulationen und unautorisierte Exfiltrationen auf Hard- und Firmware-Ebene ausgeschlossen sind.
Durchgängige Hardware Root of Trust (RoT) und TPM 2.0-Attestierung auf allen heterogenen GPU/CPU-Rechenknoten.
Physische und logische Segmentierung von Netzwerk-Fabrics gemäß ITAR- und FedRAMP-High-Zertifizierungsvorgaben.
Kryptografische Verifikation von Modell-Lineage und Speicherzugriffen direkt über die hardwarenahe Orchestrierungsschicht.
Missionskritische Inbetriebnahme: Power Availability Gates, N+1-CDU-Redundanz und Cx-Level 1–5
Die Inbetriebnahme eines 73-MW-Hochdichte-Zentrums erfordert einen lückenlosen Commissioning-Prozess (Cx Levels 1 bis 5 nach ASHRAE Guideline 0 / NIBS). Um das Risiko von Fehlinvestitionen bei gestaffeltem Energieausbau zu eliminieren, werden sogenannte „Power Availability Gates“ definiert. Jede Ausbaustufe des GPU-Clusters wird erst freigegeben, wenn die vorgeschaltete elektrische und thermische Infrastruktur im Rahmen von Cx-Level-4- und Level-5-Tests (Integrated Systems Testing, IST) unter Volllast mit hydrothermischen Lastbänken für mindestens 72 Stunden unterbrechungsfrei betrieben wurde.
Die hydraulische Redundanz der Kühlinfrastruktur basiert auf einem N+1-Konzept auf CDU-Ebene. Fällt eine Primär- oder Sekundärpumpe oder ein ganzer Wärmetauscher aus, übernehmen die parallel geschalteten Einheiten unterbrechungsfrei über automatisierte Differenzdruck-Regelventile die Strömungsleistung, ohne dass es zu Kavitation oder Druckschlägen (Water Hammer) kommt. Die Sensorik überwacht kontinuierlich Druckgradienten, Durchflussvolumina und Glykolqualität in Echtzeit. Jeder Ausfallschritt wird während der Inbetriebnahme bis hin zum kompletten Schwarzfall-Szenario (Black Start) simuliert, um die unterbrechungsfreie Verfügbarkeit sicherzustellen.
Strikte Kopplung des Cluster-Rollouts an Power Availability Gates nach erfolgreichem Abschluss von Cx-Level-5-Vollasttests.
Implementierung hydrothermischer Lasttests mit mindestens 100 kW Lastdichte pro Rack-Position zur Validierung der D2C-Pfade.
Konfiguration automatischer N+1-Umschaltzyklen für CDUs mit Reaktionszeiten von unter 200 Millisekunden zur Vermeidung von GPU-Thermodrosselungen.
Beschaffung und technischer Support
Für Produktdatenblätter, kundenspezifische Stromversorgungslösungen oder Großhandelsangebote kontaktieren Sie HEFENGQI.