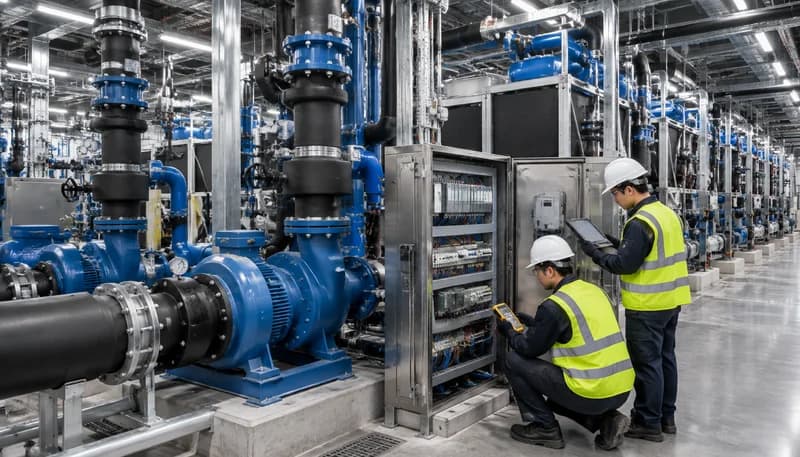
Die Illusion mechanischer Redundanz versus operativer Kopplung
In der Auslegungsphase von Rechenzentren wird Ausfallsicherheit primär über hydraulische und thermodynamische Flussdiagramme definiert: Vier Sekundärpumpen in einer 3+1-Konfiguration, fünf Kältemaschinen für eine 4+1-Grundlast oder redundante Freikühlregister suggerieren eine inhärente Resilienz gegen den Ausfall einzelner Komponenten. Tritt ein mechanischer Lagerschaden oder ein Motorwicklungsdefekt an einer Pumpe auf, übernimmt planmäßig die Standby-Einheit. Diese statische Betrachtung ignoriert jedoch die funktionale Kopplung über die Leit- und Prozessautomatisierungsebene. Sobald mehrere mechanisch voneinander isolierte Aggregate ihre Führungs-/Folge-Auswahl (Lead-Lag), Drehzahlvorgaben über Frequenzumrichter (FU) und Betriebsfreigaben von einer einzigen speicherprogrammierbaren Steuerung (SPS) oder einem gemeinsamen Gebäudeleittechnik-System (GLT) beziehen, existieren sie nicht mehr als autonome Einheiten, sondern operieren innerhalb einer einzigen, gekoppelten Fehlerdomäne.
Eine Fehlerdomäne (Failure Domain) bezeichnet im Kontext missionskritischer Infrastrukturen den maximalen Anlagenbereich, der durch das Versagen eines einzelnen Bauteils, einer logischen Routine oder eines Signalpfades unkontrolliert ausfallen kann. Wird eine mechanisch redundante N+1-Pumpengruppe durch eine gemeinsame Master-SPS koordiniert, bewirkt ein Software-Deadlock, ein Watchdog-Stop oder eine Unterbrechung des zentralen Analogsignals nicht den selektiven Ausfall einer Pumpe, sondern den simultanen Stillstand sämtlicher Aggregate. Die mechanische Überdimensionierung wird damit durch eine serielle Abhängigkeit in der Automatisierungstopologie vollständig neutralisiert. In hochdichten Umgebungen führen solche Ausfälle innerhalb weniger Minuten zu thermischen Schwellenwertüberschreitungen und kaskadierenden Notabschaltungen der IT-Hardware.
Das fundamentale Dilemma moderner Kälteanlagen liegt im Spannungsfeld zwischen Energieeffizienz und operativer Entkopplung. Um Bestwerte bei der Power Usage Effectiveness (PUE) zu erzielen, greifen übergeordnete Optimierungsalgorithmen kontinuierlich in Betriebsparameter wie Vorlauftemperaturen, Pumpendrehzahlen und Kältemaschinen-Teillastpunkte ein. Wenn diese softwarebasierte Optimierungsschleife jedoch nicht strikt von den grundlegenden, thermodynamischen Basisfreigaben getrennt ist, mutiert das Optimierungswerkzeug zum systemischen Single Point of Failure (SPOF). Resiliente Kühlarchitektur verlangt daher eine rigorose Definition der Ausfallgrenzen: Jede installierte N+1-Komponente muss thermodynamisch auch dann betriebsfähig bleiben, wenn die gesamte übergeordnete Supervisory-Ebene ersatzlos ausfällt.
FMEA/FMECA-basierte Validierung des maximalen Ausfallradius (Blast Radius) auf Steuerungsebene für alle N+1-Aggregate.
Rigorose funktionale Trennung von energieeffizienten Optimierungsbefehlen und deterministischen Basissicherheits- und Freigabeschleifen.
Auditierung aller elektromechanischen Stromlaufpläne zur lückenlosen Identifikation gemeinsamer Steuerungs- und Freigabepfade.
Schwachstellen der Steuerungsebene: GLT, übergeordnete SPS, Netzwerke und Differenzdrucksensoren
Die industrielle Steuerungsebene von Kältezentralen weist signifikante Verwundbarkeiten auf, die durch die Verwendung von Standard-Automatisierungskomponenten verschärft werden. Während Kältemaschinen und Pumpen meist über eigene Basis-Controller verfügen, werden Koordination und Sequenzierung häufig an übergeordnete Steuerungen delegiert, die über Feldbusse wie BACnet/IP, Modbus TCP oder PROFINET kommunizieren. Fällt ein unzureichend redundanter Industrial-Ethernet-Switch aus oder entsteht durch fehlerhafte Netzwerkkonfiguration ein Broadcast-Storm, friert die Datenübertragung zu den Frequenzumrichtern ein. Wenn die Umrichterlogik bei Kommunikationsverlust nicht auf einen deterministischen, lokalen Haltezustand parametriert ist, schalten viele Antriebe werksseitig auf Störung oder fallen auf null Hertz ab – wodurch der gesamte Volumenstrom der Anlage schlagartig zusammenbricht.
Ein besonders kritisches Nadelöhr stellen analoge Prozesssignale dar, allen voran Differenzdrucksensoren (DP-Sensoren) in den Kaltwasser-Verteilnetzen. Häufig steuert ein zentrales SPS-Programm die Drehzahlen sämtlicher Sekundärpumpen basierend auf dem 4–20-mA-Signal eines einzigen, hydraulisch ungünstig positionierten Differenzdrucktransmitters. Weist dieser Transmitter einen Kalibrierungsfehler, einen Sensordrift oder einen Drahtbruch auf, führt die Integral-Aktion (I-Anteil) des zentralen PID-Reglers dazu, dass die Pumpen entweder unkontrolliert hochdrehen und hydraulische Schläge provozieren oder auf Minimaldrehzahl absinken. Ohne redundante Sensorik mit Signalplausibilisierung (z. B. 2-aus-3-Auswahl oder Medianfilterung) und lokaler Grenzwertüberwachung bildet ein Bauteil für wenige hundert Euro das systemische Risiko einer Kälteanlage im zweistelligen Megawattbereich.
Ebenso vernachlässigt wird die physische 24VDC-Steuerspannungsversorgung innerhalb von Automatisierungsschränken. Oft versorgt ein zentrales Netzteil-Duo über ungesicherte Klemmenleisten sowohl die Eingangs-/Ausgangsmodule der Master-SPS als auch die Freigaberelais und Signalwandler aller redundanten Pumpenstränge. Ein satter Erdschluss oder Kurzschluss in der Zuleitung eines einzelnen Stellventils oder Frequenzumrichters kann die 24VDC-Sammelschiene unter die Abschaltschwelle der Steuerungen ziehen. Das Resultat ist ein vollständiger Spannungseinbruch der Automatisierungsebene, der sämtliche Schütze abfallen lässt und alle Pumpen gleichzeitig stoppt. Echte N+1-Integrität erfordert selektive, elektronische Sicherungskanäle und galvanisch getrennte Steuerstromkreise pro redundanter Funktionseinheit.
Realisierung einer 2-aus-3-Auswahl (2oo3) oder 1oo2D-Sensorarchitektur für alle kritischen Differenzdruck- und Temperaturmessstellen.
Implementierung selektiv abgesicherter, galvanisch getrennter 24VDC-Steuerstromkreise pro Aggregat zur Vermeidung von Sammelschienen-Kurzschlüssen.
Netzwerkarchitektur mit Ringtopologie (z. B. MRP, RSTP), VLAN-Segmentierung und Härtung gegen Broadcast-Storms auf Feldebene.
Flüssigkühlung und CDU-Proliferation: Eskalation vernetzter Ausfallrisiken
Mit dem Einzug von Hochdichte-KI-Infrastrukturen und Direct-to-Chip-Kühlsystemen (DLC) potenziert sich die Kritikalität der Steuerungsebene dramatisch. In konventionellen Luftkühlungsszenarien bieten die thermische Trägheit des Kaltwasserrings und die Luftmassen im Rechenzentrum typischerweise Pufferzeiten von drei bis zehn Minuten, um Steuerungsausfälle zu kompensieren. Bei GPU-Racks mit thermischen Verlustleistungen von 50 bis über 100 kW pro Rack schrumpft dieses Zeitfenster auf wenige Sekunden zusammen. Coolant Distribution Units (CDUs), die das sekundäre Kühlmittel (Facility Water System zu Technology Cooling System) entkoppeln, sind hochgradig digitalisierte Einheiten mit integrierten drehzahlgeregelten Pumpen, Proportional-Regelventilen und komplexen Mikrocontroller-Platinen.
Werden Dutzende CDUs parallel über ein übergeordnetes Leitsystem gesteuert, multiplizieren sich die Schnittstellenrisiken. Eine weit verbreitete Schwachstelle ist die Kaskadierung von Leckage-Erkennungssystemen: Wird das Sammel-Leckagesignal eines Rack-Reihen-Sensors unkritisch auf die übergeordnete Freigabe mehrerer CDUs aufgeschaltet, kann ein einzelner defekter Leitfähigkeitssensor oder ein eingeklemmtes Sensorkabel eine sofortige Notabschaltung aller zugeordneten CDUs initiieren. Ebenso fatal wirken sich transiente Druckschwankungen im primären Kaltwassernetz aus. Wenn die sekundärseitigen CDU-Regler auf Primärdruckschwankungen mit zu aggressiven PID-Parametern reagieren, entstehen hydraulische Oszillationen, die bei fehlender Entkopplung zu simultanen Kavitationsabschaltungen der internen Umwälzpumpen führen.
Zusätzlich schaffen herstellereigene Gateway-Lösungen oft intransparente Fehlerpfade. Viele CDU-Hersteller integrieren proprietäre Firmware-Module, die Leistungsdaten über MQTT oder Modbus TCP an das Rechenzentrums-Management (DCIM) übertragen. Läuft der interne Puffer dieser Kommunikationsmodule aufgrund von Verbindungsverzögerungen voll, blockieren in mangelhaft architektierten Systemen auch die echtzeitkritischen Steuerungs-Threads des internen Pumpenreglers. In Hochdichte-Rechenzentren muss die interne Druck- und Durchflussregelung einer CDU vollkommen isoliert von jeglicher externen Netzwerkanbindung operieren, um sicherzustellen, dass Telemetrieausfälle niemals zu thermischen Notabschaltungen führen.
Vollständige logische und physische Autonomie der internen CDU-Pumpenregelung gegenüber GLT- und DCIM-Netzwerkverbindungen.
Zonenspezifische Isolierung von Leckagesensoren zur Unterbindung kaskadierender Abschaltungen benachbarter Kühlmittelverteiler.
Dämpfung hydraulischer Regelschleifen zur Beherrschung transienter Druckstöße im primären Kaltwassernetz ohne Resonanzschwingungen.
Auslegung für Graceful Degradation: Autonome Vor-Ort-Regelkreise und verdrahtete Rückfallebenen
Robuste Kälteanlagen folgen dem ingenieurtechnischen Paradigma der 'Graceful Degradation' (abgestufte Funktionsminderung): Bei Ausfall übergeordneter Intelligenz darf das System nicht stoppen, sondern muss in einen vordefinierten, sicheren und autonomen Zustand übergehen. Die Basiskontrolle des Kaltwasser-Volumenstroms gehört zwingend auf die unterste Feldebene – direkt in die Firmware des Frequenzumrichters oder in eine unmittelbar am Aggregat montierte Klein-SPS. Die PID-Regelschleife für den Differenzdruck muss dezentral geschlossen werden, indem der lokale 4–20-mA-Messwert direkt auf den Analogeingang des führenden Frequenzumrichters geführt wird, ohne Umweg über Netzwerk-Switches oder zentrale SPS-Racks.
Zentraler Bestandteil dieser Architektur ist die Parametrierung deterministischer Watchdog-Funktionalitäten. Bricht die Kommunikation zwischen Master-SPS und Frequenzumrichter ab – beispielsweise durch Ausfall des Feldbusses für mehr als 2000 Millisekunden –, darf der Antrieb nicht in einen Fehlerzustand verfallen. Stattdessen greift eine konfigurierte 'Fail-to-Preset'-Logik: Der Umrichter wechselt verzögerungsfrei auf eine feste Sicherheitsfrequenz (z. B. 80 oder 100 Prozent der Nenndrehzahl) und hält den Betrieb aufrecht. Gleichzeitig signalisiert ein Relaisausgang die Störung der übergeordneten Kommunikation an das Alarmmanagement. Die Energieeffizienz verschlechtert sich in diesem Zustand temporär, doch die kontinuierliche Kälteversorgung der IT-Komponenten bleibt unterbrechungsfrei garantiert.
Als letzte Verteidigungslinie gegen totale Steuerungsblockaden müssen missionskritische Schaltanlagen über eine festverdrahtete Hand-0-Auto-Ebene (H-0-A) verfügen, die softwareunabhängig operiert. Im Handbetrieb wird der Frequenzumrichter oder Direktanlasser über einen elektromechanischen Schalter direkt mit einer festen Drehzahlvorgabe bzw. voller Netzspannung angesteuert. Sämtliche digitalen Software-Freigaben der SPS werden in dieser Stellung galvanisch überbrückt; lediglich hardverdrahtete Sicherheitseinrichtungen wie Kaltleiter-Motorschutz, thermische Überlastrelais und Trockenlaufschutzkontakte bleiben aktiv. Dies versetzt das Betriebspersonal in die Lage, selbst bei einem kompletten Blackout der Prozessleitebene innerhalb von Minuten eine manuelle hydraulische Zirkulation herzustellen.
Programmierung von VFD-Watchdogs mit 'Fail-to-Preset'-Logik (Halten der letzten Drehzahl oder Hochlauf auf 85–100 %) bei Busausfall.
Implementierung dezentraler PID-Regelkreise direkt auf den Antriebssteuerungen mit fest verdrahteten Sensoreingängen.
Realisierung einer elektromechanischen Hand-0-Auto-Schaltung mit galvanischer Überbrückung aller SPS-Freigaben im Notbetrieb.
Erweiterte Inbetriebnahmeprotokolle: Prüfung der Steuerungsfehlerdomäne statt isolierter Komponenten
Klassische Inbetriebnahmeprozesse (Level 1 bis Level 5 Integrated Systems Testing / IST) limitieren sich häufig darauf, einzelne Aggregate wie Pumpen oder Kältemaschinen manuell auszuschalten, um das Anlaufen der redundanten Maschine zu dokumentieren. Dieser Komponentenwechsel-Test validiert lediglich die mechanische Verfügbarkeit unter Idealbedingungen, testet jedoch keineswegs die Unabhängigkeit der Fehlerdomänen. Ein rigoroses Testprotokoll muss gezielt das Versagen der gemeinsamen Steuerungs- und Signalinfrastruktur simulieren, während die Anlage unter einer repräsentativen thermischen Last (z. B. durch Heizlastbänke im Weißbereich) betrieben wird.
Zu den obligatorischen Prüfszenarien gehört das abrupte Abschalten der 24VDC-Steuerspannungsversorgung der zentralen Leit-SPS. Die Kälteanlage muss beweisen, dass die aktiven Pumpen unterbrechungsfrei weiterlaufen oder lokale Steuerungen autonom die hydraulische Förderung aufrechterhalten, ohne dass Druckstöße (Water Hammer) die Rohrleitungsnetze beschädigen. Ebenso muss das Durchtrennen redundanter Ethernet-Netzwerkverbindungen (Kabelzugtests) im laufenden Betrieb durchgeführt werden, um zu verifizieren, dass Ringtopologien innerhalb der spezifizierten Rekonstruktionszeit (typischerweise unter 20 Millisekunden) umschalten, ohne dass Modbus- oder PROFINET-Timeouts ausgelöst werden.
Ein weiterer wesentlicher Testschritt ist die Simulation von Sensorfehlern. Hierbei werden gezielt Drahtbrüche (0 mA), Kurzschlüsse (über 21 mA) sowie eingefrorene Analogsignale an den Differenzdruck- und Temperaturtransmittern injiziert. Das Systemverhalten muss verifizieren, dass die Regelalgorithmen unplausible Messwerte sofort verwerfen, auf redundante Messstellen umschalten oder in den definierten Fail-Safe-Betrieb übergehen, anstatt fehlerhafte Steuerbefehle an die Ventile und Frequenzumrichter zu senden. Erst wenn ein Kühlsystem das vollständige Verschwinden seiner übergeordneten Leitlogik ohne nennenswerte thermische Einbußen übersteht, ist der Nachweis echter N+1-Resilienz erbracht.
Durchführung destruktiver Steuerungstests (Kabelzug, SPS-Spannungsabwurf, Switch-Reboot) unter mindestens 75 % thermischer Testlast.
Injektion von Sensorfehlern (Drahtbruch, Signal-Freeze, Kurzschluss) zur Verifikation der automatischen Messwert-Plausibilisierung.
Messung und Protokollierung transienter Druckstöße und Umschaltzeiten während des Wechsels von Leitebene auf autonomen Vor-Ort-Betrieb.
Engineering-Checkliste und Resilienz-Governance für hochdichte KI-Rechenzentren
Um die Resilienz hochdichter Kühlsysteme über den gesamten Lebenszyklus sicherzustellen, bedarf es einer institutionalisierten Governance für Automatisierungscode und Systemarchitektur. Software-Updates in SPS-Systemen oder Erweiterungen der GLT werden im operativen Betrieb oft ohne adäquate Risikoanalyse eingespielt. Bereits eine scheinbar banale Änderung an einem globalen Freigabebaustein kann unbeabsichtigt Querverbindungen schaffen, die zuvor getrennte Fehlerdomänen zusammenführen. Alle Programmänderungen an sicherheits- und verfügbarkeitsrelevanten Steuerungen müssen daher denselben strengen Change-Management- und Peer-Review-Prozessen unterliegen wie Eingriffe in die elektrische Hochspannungsversorgung.
Ergänzend zur organisatorischen Governance ist eine kontinuierliche Zustandsüberwachung der Steuerungsebene erforderlich. Moderne Data Center Infrastructure Management (DCIM)-Systeme müssen Metriken wie SPS-Zykluszeiten, Ethernet-Paketverluste, CRC-Fehler auf Feldbussen und Netzteil-Auslastungen kontinuierlich überwachen und Trendanalysen unterziehen. Steigende Kommunikationslatenzen oder sporadische Bus-Timeouts sind frühe Indikatoren für eine drohende Steuerungsinstabilität, lange bevor es zu einem spürbaren Ausfall von Kälteaggregaten kommt. Resilience Governance bedeutet, die Automatisierungsebene nicht als statisches Beiwerk der Mechanik zu behandeln, sondern als dynamisches, primäres Schutzelement der Gesamtanlage.
Abschließend müssen Rechenzentrumsbetreiber verbindliche Richtlinien für periodische Resilienz-Audits etablieren. Mindestens einmal jährlich sollten im Rahmen geplanter Wartungsfenster kontrollierte Umschaltungen auf die Handbedienebene sowie der Ausfall zentraler Leitsysteme trainiert werden. Nur durch wiederholte praktische Verifikation bleibt sichergestellt, dass das Betriebspersonal die Handlungsabläufe im Havariefall beherrscht und dass nachfolgende Anlagenmodifikationen keine neuen, unbemerkten Abhängigkeiten in die Kühlarchitektur eingeschleust haben.
Einführung eines strengen Freigabeprozesses für Steuerungssoftware-Updates mit statischer Code-Analyse auf unzulässige logische Kopplungen.
Kontinuierliches Telemetrie-Monitoring von SPS-Zykluszeiten, Bus-Latenzen und DC-Spannungspegeln im DCIM-Dashboard.
Jährliche Re-Zertifizierung der autonomen Notbetriebsmodi durch reale, geplante Trenntests der übergeordneten GLT-Infrastruktur.
Beschaffung und technischer Support
Für Produktdatenblätter, kundenspezifische Stromversorgungslösungen oder Großhandelsangebote kontaktieren Sie HEFENGQI.