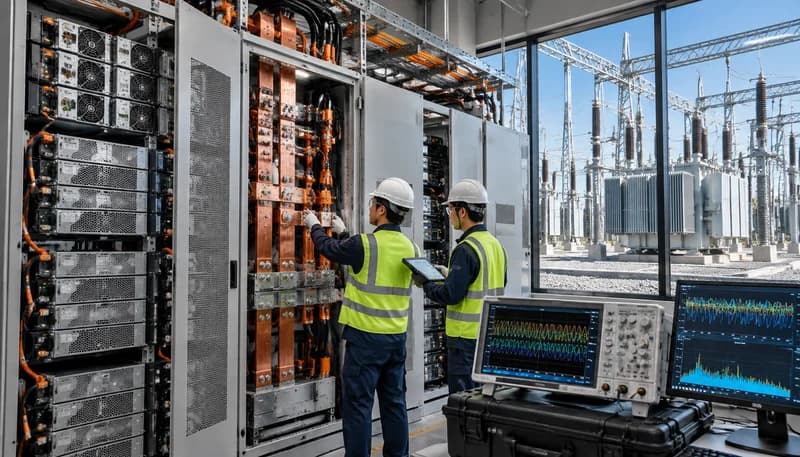
Der Millisekunden-Transiente: Warum AI-Lastdynamiken synchrone Netzparadigmen durchbrechen
Konventionelle Verbundnetze basieren auf dem physikalischen Fundament elektromechanischer Trägheit (Inertia), bereitgestellt durch synchrone Generatormassen in thermischen Kraftwerken und Wasserkraftanlagen. Laständerungen vollziehen sich im traditionellen Netzbetrieb typischerweise entlang prognostizierbarer Gradienten über Minuten bis Stunden. Moderne KI-Trainings- und Inferenzcluster brechen dieses Paradigma fundamental: Kollektive Kommunikationsoperationen wie AllReduce, Barrier-Synchronisationen oder plötzliche Job-Abbrüche führen zu sprunghaften Lastgradienten (di/dt) von mehreren hundert Megawatt innerhalb von Sub-Sekunden oder wenigen Millisekunden.
Trifft ein derartiger Lastabwurf oder Lastsprung auf ein Übertragungsnetz, führt das resultierende Leistungsungleichgewicht gemäß der Schwungradgleichung (Swing Equation) zu extremen Frequenzänderungsraten (Rate of Change of Frequency, RoCoF). Während Primärregelleistungen und Turbinenregler (Governor Response) mechanische Ansprechzeiten im Bereich von 2 bis 30 Sekunden aufweisen, vollzieht sich der KI-Lastwechsel quasimomentan. Ohne gegensteuernde Maßnahmen löst dieser steile Frequenzanstieg bzw. -abfall Fehlfunktionen in Netzschutzrelais aus und gefährdet die Einhaltung kritischer Grenzwerte gemäß NERC BAL-001 und ENTSO-E-Betriebsstandards.
Zusätzlich induziert der rapide Lastwechsel transiente Spannungsverzerrungen und erhebliche Blindleistungsfluktuationen am Netzverknüpfungspunkt (Point of Common Coupling, PCC). Die transiente Fehlanpassung zwischen der induktiven Leitungsreaktanz X_L und der kapazitiven Kompensation destabilisiert den lokalen Spannungsvektor, was ohne schnelle dynamische Spannungsstützung zu Kaskadeneffekten in vorgeschalteten Hochspannungsebenen führen kann.
Implementierung von RoCoF-Überwachungsrelais mit angepasster Filterung gegen Fehlauslösungen bei transienten di/dt-Sprüngen
Etablierung softwareseitiger Ramping-Algorithmen im KI-Workload-Scheduler zur Drosselung des maximalen Lastgradienten (MW/s)
Validierung der Einhaltung dynamischer Grenzwerte gemäß NERC BAL-002 und regionalen Grid-Code-Anforderungen am Netzverknüpfungspunkt
Rack-Leistungsdichten im Wandel: Vom 40-kW-H100-Cluster zum 1-MW-Mega-Rack bei 800 V DC
Die thermische und elektrische Leistungsdichte pro Rack durchläuft eine exponentielle Steigerung: Ausgehend von klassischen Enterprise-Racks mit 5 bis 10 kW etablierten Systeme der H100-Generation Dichten um 40 kW. Aktuelle Plattformen wie Blackwell erreichen 150 kW, während kommende Generationen wie Vera Rubin 240 kW überschreiten. Entwicklungsprognosen für zukünftige dichte Rechencluster visieren bis zu 1 MW pro Rack an, was die physikalischen Grenzen konventioneller 400-V-/415-V-AC- sowie 48-V-DC-Verteilungen sprengt.
Bei einer Leistungsaufnahme von 1 MW würde eine 48-V-DC-Sammelschiene Ströme von über 20.000 A führen, was zu untragbaren I²R-Leitungsverlusten, massiven Schienenquerschnitten und extremen elektromagnetischen Kräften bei Kurzschlüssen führt. Die elektrotechnische Konsequenz ist der Übergang zu einer standardisierten 800-V-DC-Architektur. Durch die Erhöhung der Zwischenkreisspannung auf 800 V sinkt der Betriebsstrom auf rund 1.250 A, was den Einsatz kompakter Kupferschienen und hocheffizienter Solid-State-Leistungsschalter ermöglicht.
Der Übergang zu 800 V DC reduziert zudem mehrfache Wandlungsstufen (AC-DC-AC-DC) auf eine zentrale, hochgradig optimierte Gleichrichtungsebene im Power-Shelf oder Substation-Bereich. Dies verringert nicht nur thermische Verluste, sondern verbessert auch die Kontrolle der harmonischen Oberschwingungsströme (THD_I), stellt jedoch signifikante Anforderungen an Lichtbogenschutz, Isolationskoordination und galvanische Trennung innerhalb der Rackreihen.
Umstellung der Rack-Busbars auf 800-V-DC-Klassen unter Einhaltung verschärfter Kriech- und Luftstrecken nach IEC 60664-1
Integration ultraschneller Solid-State-Circuit-Breaker (SSCB) zur Beherrschung von Kurzschlussströmen bei minimaler Ansprechzeit (<10 µs)
Thermische Auslegung der Busbars und Steckverbinder für optimierte Flüssigkeitskühlung zur Vermeidung lokaler Hotspots
Mechanische Resonanz und subsynchrone Oszillationen: Torsionsbruchrisiken an Turbinenwellen
Eine der gravierendsten netzphysikalischen Gefahren durch ungedämpfte KI-Lastsprünge ist das Anregen subsynchroner Oszillationen (Subsynchronous Oscillations, SSO) und subsynchroner Resonanzen (SSR). Hierbei handelt es sich um niederfrequente Schwingungen unterhalb der nominalen Netzfrequenz (unter 50 Hz bzw. 60 Hz), die durch Wechselwirkungen zwischen leistungselektronischen Wandlern (Active Front Ends, AFEs) und schwachen Übertragungsnetzen entstehen können.
Verfügt ein Rechenzentrum über Millionen getakteter Halbleiterstufen, können unzureichend gedämpfte Regelkreise der Umrichter negative Dämpfungskoeffizienten im subsynchronen Frequenzband erzeugen. Treffen diese elektrischen Frequenzanteile auf die mechanischen Torsionseigenfrequenzen von Welle-Turbine-Generator-Strängen nahegelegener thermischer Kraftwerke, entsteht eine verheerende Resonanzkatastrophe: Die resultierenden mechanischen Wechseldrehmomente führen zu kumulativer Torsionsermüdung, Rissbildung und im Extremfall zum Abscheren massiver Turbinenwellen.
Zur Beherrschung dieses Phänomens müssen Rechenzentren am Übergabepunkt umfassende Impedanzanalysen und dynamische Stabilitätsprüfungen durchführen. Konformität mit Standards wie IEEE 2800 für leistungselektronisch gekoppelte Ressourcen erfordert den Einsatz von Subsynchronous Damping Controllers (SSDC) sowie die präzise Parametrierung der Phasenregelkreise (Phase-Locked Loops, PLL) an den Eingangswechselrichtern, um destabilisierende Interaktionen mit der Netzimpedanz auszuschließen.
Durchführung modaler Torsionsanalysen im regionalen Netzverbund zur Identifikation kritischer Eigenfrequenzen zwischen 10 Hz und 45 Hz
Implementierung von SSDC-Dämpfungsalgorithmen in den Steuerungsalgorithmen der Grid-Tied-Wechselrichter
Echtzeitüberwachung subsynchroner Strom- und Spannungsanteile am PCC mittels hochauflösender Phasor Measurement Units (PMUs)
Glättung auf Chipebene und Telemetrie: In-Rack-Puffer, DSX-Regelkreise und dynamisches Headroom-Management
Um Netztransienten bereits am Entstehungsort abzufangen, muss das Lastmanagement unmittelbar auf Chipebene und im Rack ansetzen. Architekturen wie Nvidias DSX verknüpfen Hochgeschwindigkeitstelemetrie direkt mit der Leistungszuteilung des Rechenknotens. Über Latenzzeiten im Mikrosekundenbereich erfassen Strommess-Shunts und On-Die-Sensoren plötzliche Rechenpausen und passen die Taktung sowie die dynamische GPU-Leistungsaufnahme über DVFS (Dynamic Voltage and Frequency Scaling) kontinuierlich an.
Hardwareseitig fungieren im Rack integrierte Superkondensatoren (Electric Double-Layer Capacitors, EDLCs) oder Lithium-Kondensatoren als elektrochemische Puffer erster Instanz. Diese Komponenten zeichnen sich durch extrem hohe C-Raten und niedrige äquivalente Serienwiderstände (ESR) aus. Bei einem abrupten Lastabfall oder Lastanstieg nehmen sie die Differenzenergie für 10 bis 100 Millisekunden auf bzw. speisen sie ein, wodurch das externe di/dt am AC- oder DC-Einspeisepunkt des Racks auf netzverträgliche Raten geglättet wird.
Das dynamische Headroom-Management nutzt ungenutzte thermische und elektrische Reserven: Droht ein Einbruch des Gesamtleistungsbezugs, können Hintergrund-Workloads wie Checkpointing, Datenvorverarbeitung oder synthetische Blindlastroutinen auf freien Compute-Kernen hochgefahren werden. Dieser koordinierte Regelkreis entkoppelt die algorithmische Burst-Natur von Deep-Learning-Workloads von der elektrotechnischen Leistungsaufnahme des Power-Shelfs.
Dimensionierung von In-Rack-Superkondensatorbänken zur Pufferung von Lastgradienten für mindestens 50 ms bei Volllastsprung
Integration von Sub-Millisekunden-Telemetriekanälen zur automatisierten Aktivierung von Drossel- und Glättungsroutinen
Konfiguration adaptiver Lastabfang-Routinen im Compute-Cluster zur Glättung plötzlicher GPU-Idle-Zustände
Standorttopologie und Netzanschluss: Modulare 30- bis 100-MW-Blöcke versus monolithische Großkraftwerke
Gigawatt-Campuskonzepte wie Oracles Stargate offenbaren die infrastrukturellen Risiken monolithischer Versorgungsansätze. Die Konzentration eines 1-GW-Bedarfs auf wenige 200-MW-Großturbinen oder zentrale Riesen-Umspannwerke generiert gravierende Single Points of Failure (SPOF). Fällt ein einzelner 200-MW-Block aus oder trennt das Schutzsystem eine zentrale Sammelschiene, ist ein großflächiger Netzkollaps im lokalen Netzbezirk nahezu unvermeidlich.
Die ingenieurtechnische Lösung liegt in einer zellulären Topologie mit modularen Funktionsblöcken zwischen 30 MW und 100 MW. Jeder Block verfügt über eine eigenständige Mittelspannungs- oder Hochspannungsschaltanlage, dedizierte Transformatoren und autarke Notstrom- bzw. Pufferressourcen. Dieses Konzept begrenzt den maximalen Ausfallschaden (Maximum Credible Loss) auf einen beherrschbaren Bruchteil der Gesamtleistung und vereinfacht die Einhaltung der N-1- bzw. N-2-Redundanzkriterien.
Auf Umspannebene (z. B. 230 kV oder 400 kV) werden diese modularen Einheiten über segmentierte Ring- oder Doppelbussysteme mit statischen Synchronkompensatoren (STATCOM) und Synchronkondensatoren gekoppelt. Diese rotierenden oder leistungselektronischen Phasenschieber erhöhen das Kurzschlussverhältnis (Short Circuit Ratio, SCR) am Verknüpfungspunkt künstlich und stellen sicher, dass auch schwache Netzanbindungen die dynamischen Schaltvorgänge der 30- bis 100-MW-Blöcke ohne unzulässige Spannungseinbrüche verkraften.
Segmentierung des Campus-Gesamtlayouts in galvanisch entkoppelbare Leistungsblöcke von maximal 100 MW
Installation von STATCOM-Systemen oder rotierenden Phasenschiebern zur dynamischen Blindleistungsregelung und SCR-Stützung
Auslegung der Sammelschienentrennung mit redundanten Hochgeschwindigkeits-Kuppelschaltern für selektive Fehlerisolation
Der Chip-to-Grid-Entwicklungsleitfaden: Mehrschichtige Transientendämpfung, BESS und Netzkodizes
Ein zukunftsfähiges Gigawatt-Rechenzentrum erfordert eine geschlossene, mehrschichtige Dämpfungsarchitektur von der Siliziumebene bis zum Hochspannungsnetz. Ebene 0 (Chipebene) regelt Transienten im Mikrosekundenbereich via Takt- und Spannungsmodulation; Ebene 1 (Rackebene) fängt Millisekunden-Gradienten über Superkondensatoren ab; Ebene 2 (Anlagenebene) nutzt schnell ansprechende Batteriespeichersysteme (BESS) mit Grid-Forming-Wechselrichtern zur Glättung im Sekundenbereich; Ebene 3 (Netzebene) synchronisiert primäre Kraftwerksreserven über Minuten.
BESS-Einheiten in modernen KI-Rechenzentren müssen als netzbildende Einheiten (Grid-Forming Inverters) parametriert werden. Anstelle herkömmlicher Grid-Following-Systeme, die lediglich eine bestehende Netzspannung nachführen, prägen Grid-Forming-Umrichter eine eigene Spannungsquelle ein und stellen synthetische Trägheit zur Verfügung. Dies ist essenziell, um die Auflagen gemäß IEEE 1547-2018 und IEEE 2800-2022 für Low-Voltage Ride-Through (LVRT) und High-Voltage Ride-Through (HVRT) zu erfüllen, sodass das Rechenzentrum bei Netzfehlern nicht unkontrolliert abwirft, sondern stabilisierend wirkt.
Der finale Engineering-Blueprint erfordert ein standardisiertes Co-Design zwischen Halbleiterherstellern, DC-Infrastrukturentwicklern und Übertragungsnetzbetreibern (TSOs). Erst durch automatisierte Echtzeit-Schnittstellen zwischen Rechenzentrumsleitsystemen (DCIM/SCADA) und Netzbetreiber-Leitsystemen (EMS) können Leistungsrampen vorausschauend signalisiert, dynamische Blindleistungsbedarfe (Q) kompensiert und die elektrische Stabilität der kritischen Energieinfrastruktur langfristig gesichert werden.
Parametrierung von Facility-BESS mit virtueller Synchronmasse (Grid-Forming Inverter Control) gemäß IEEE 2800-2022
Zertifizierung der Ride-Through-Fähigkeit (LVRT/HVRT) nach NERC PRC-024 zur Verhinderung kaskadierender Abschaltungen
Implementierung von SCADA-zu-EMS-Schnittstellen für die automatisierte Übermittlung prognostizierter Großtransienten an den Netzbetreiber
Beschaffung und technischer Support
Für Produktdatenblätter, kundenspezifische Stromversorgungslösungen oder Großhandelsangebote kontaktieren Sie HEFENGQI.